推論モデルを自分で作る:全 8 回のビデオ講座
Sebastian Raschka が新著に合わせて 8 回の講義を収録した。事前学習済みの Qwen3 0.6B から出発し、検証器、推論時のスケーリング、GRPO、蒸留を PyTorch で順に実装していく。
日本語
コピー
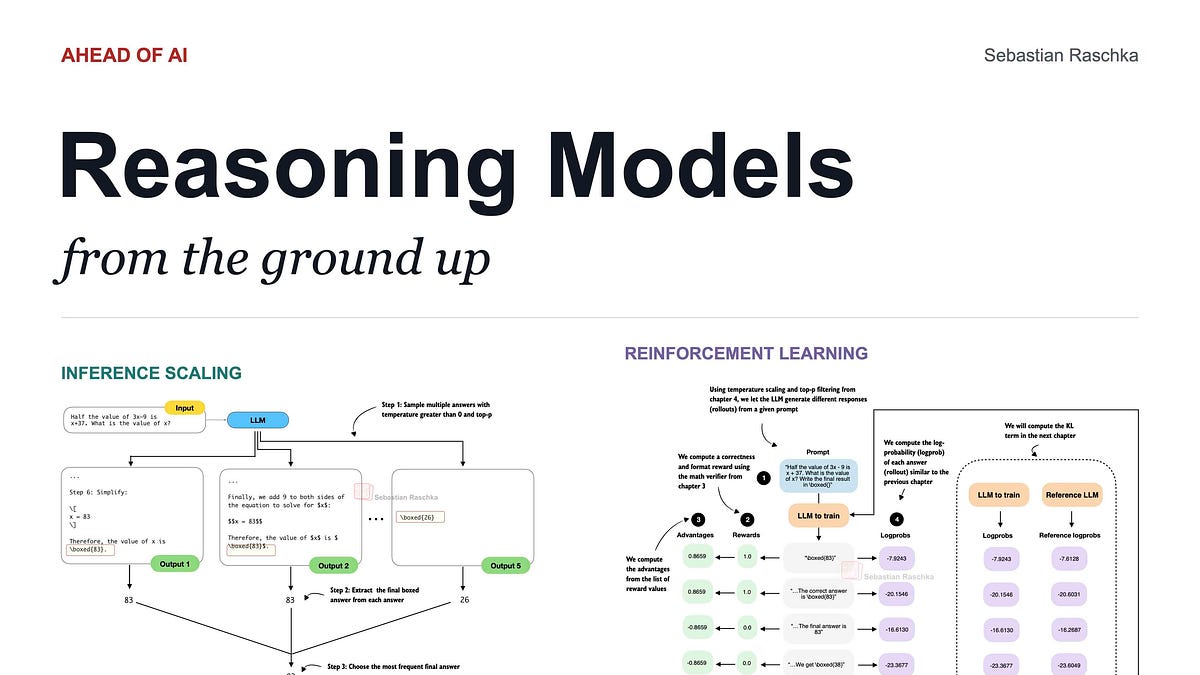
この 2 年、Ahead of AI では推論モデルについてかなり書いてきた。直近の記事は現代の LLM の推論強度をどう制御するかについてだ。推論モデルの重要性はまったく薄れていない。実際、今の LLM はほぼすべてが推論モデルそのものか、推論モードを備えている。
推論モデルの仕組み、つまり推論時のスケーリング、強化学習、蒸留に興味があるなら、最近書いた Build Reasoning Model (From Scratch) を読んでほしい。PyTorch でこれらの手法をゼロから実装している。私の経験では、物事が実際にどう動いているかを理解し、腹に落とすには今でもこれが一番の近道だ。
ここ数か月は、その付属コースの収録にも腰を据えて取り組んだ。ここで共有したい。以下が推論モデルをゼロから構築する 8 本のプログラミング動画(合計 11 時間)だ。
事前学習済みの LLM を出発点に、Python と PyTorch でそれを評価し改善する手法を実装していく。昨年の Coding LLMs from the Ground Up コースが気に入った人なら、このシリーズはほぼその続編だ(ただし、あのコースを受けていなくてもそのまま見られる)。
今はしばらく休憩中で、来月にはまた面白い LLM 研究のまとめを持って戻ってくる。それまでの間、楽しんで、一緒に手を動かしてコードを書いてほしい。
LLM、推論モデル、エージェントはどうつながり、どう噛み合うのか
まず短い補足から。推論モデルと今日の AI エージェントの関係をよく聞かれるので、動画に入る前に簡単に触れておく。
推論モデルは本質的に通常の LLM の上位版だ。検証可能な報酬を用いた強化学習で事後学習を積み増し(推論時のスケーリング手法を併用してもよい)、より難しい問題を解けるようにしたものだ。従来、推論モデルは数学とコードのために開発されてきたが、その能力は他の問題領域にも一般化する。
推論モデルはその後、エージェント harness の内部でエンジンとして働く。harness とは、LLM/推論モデルを囲むソフトウェアやツールの枠組みで、より難度の高いタスク(大規模なコーディング作業、旅行の予約、各種のパーソナルアシスタント的タスク)に対応するためのものだ。harness の役割は細やかなコンテキスト管理と、LLM がツールを使えるようにすることにある。
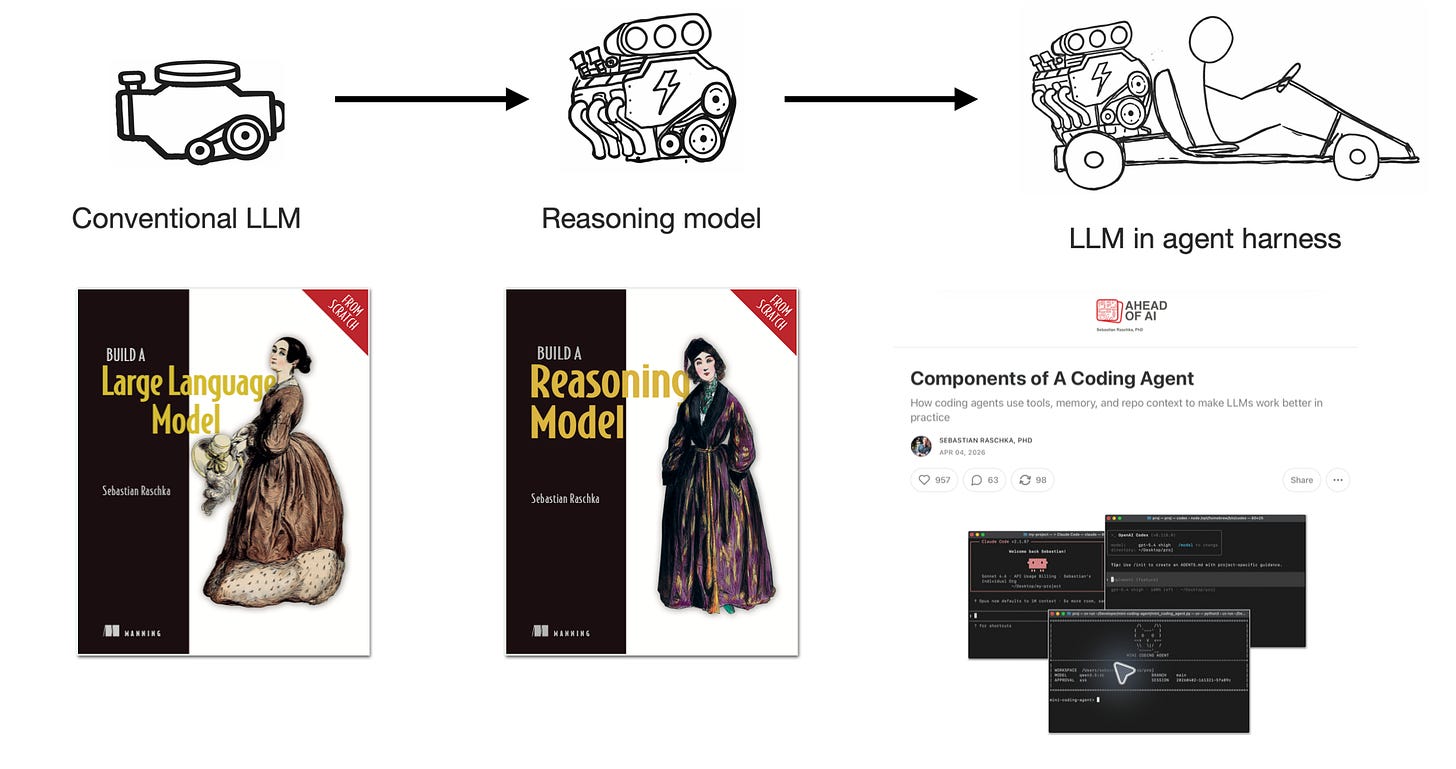
図 1:従来の LLM、推論モデル、agent harness をエンジンにたとえた図。出典は私の記事 Components of a Coding Agent。
上のたとえでは、モデルがエンジンで、agent harness はそこに各種の機械構造を足して、さまざまな用途に使えるようにするものだ(単なるチャットボットの画面から一段進んだ形にあたる)。agent は従来の LLM でも推論モデルでも組めるが、推論モデルのほうが能力は高く、使われる機会も多い。(前述のとおり、現在の LLM の大半は推論モデルであり、推論の強度は設定で変えられる。)
つまり、エンジンにあたる推論モデルは、現代の LLM agent を理解するうえで今なお重要な要素だ。
このテーマに関連するリソースは次のとおりだ。
- Build a Large Language Model (From Scratch) 書籍と動画
- Build A Reasoning Model (From Scratch) 書籍(および下記の動画)
- Substack の Components of a Coding Agent 記事
下の動画は、こうしたシステムを動かす推論モデルの開発に焦点を当てている。
範囲と前提知識
reasoning-from-scratch シリーズの動画は、小さな事前学習済み Qwen3 モデルを土台に、各種の推論手法を Python と PyTorch で一から実装していく。事前学習済みモデルから始めることで、本当に面白い部分に集中できる。評価、推論時のスケーリング、強化学習、蒸留だ。
前提知識としては、Python と PyTorch に慣れていることを勧める。推論の部分は独立した教材として設計したので、Build A Large Language Model (From Scratch) の内容は必須ではなく推奨にとどまる。
計算資源について。初期のテキスト生成と評価の例は CPU でも動く。後半の実験、とくに学習は GPU があるほうが現実的だ。最初の動画では環境構築と補足のアドバイスを扱っている。コードリポジトリにもハードウェアと環境に関する推奨がある。
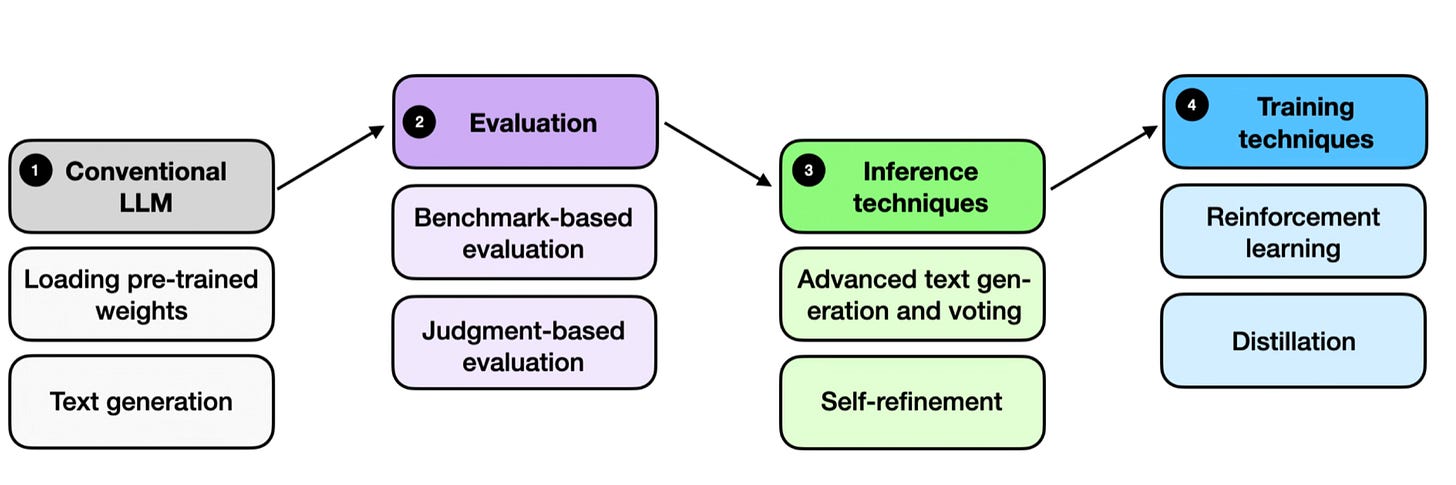
図 2:扱うトピックの全体像。
対応書籍
これらの動画は、私の著書 Build a Reasoning Model (From Scratch) の補助教材にあたる。解説をより詳しく、自分のペースで読みたい人、演習問題を解きたい人には、この本の併用を勧める。
最も深く学べる方法は、1 章読む → 対応する動画を見ながらコードを動かす → 演習問題を解く、という順番だ。
この本は Manning と Amazon で販売中だ。紙版はオールカラー。
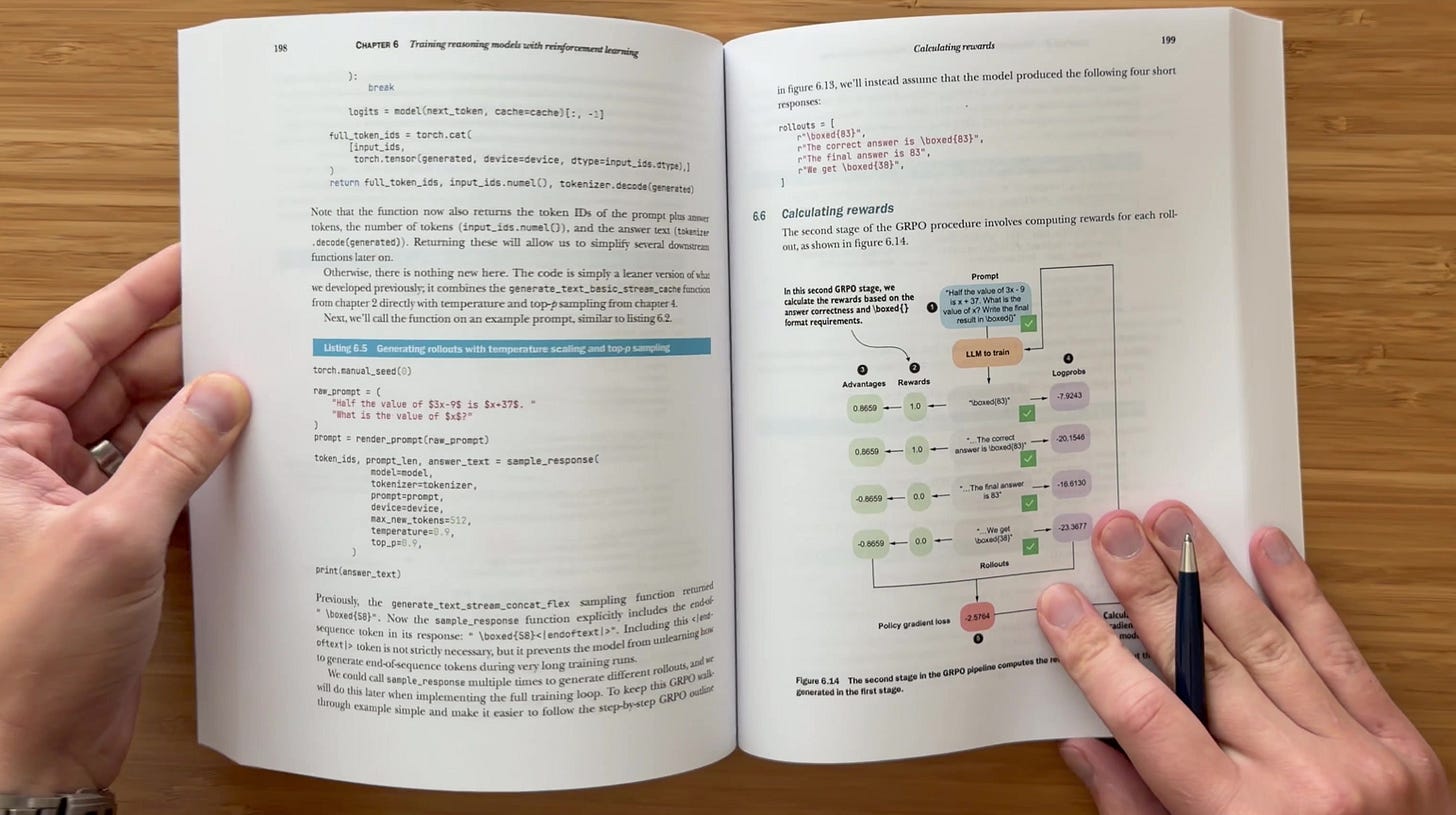
図 3:『ゼロから作る推論モデル』紙書籍からのランダムな抜粋。
本書を購入してくださった方、あるいは友人に勧めてくださった方、一人ひとりに感謝する。皆の支えのおかげで、こうしたコンテンツを作り続けられる。
動画
本編に入る前に、最後にひとつだけ。もっと短く、概念寄りの概要が欲しいという人には、LinkedIn Learning の AI 推論モデル講座もおすすめだ(そこのリンクからアクセスすれば 24 時間は無料で視聴できるはず。LinkedIn Premium の購読は不要)。
講座は約 90 分で、推論モデルの仕組みを解説する。推論時のスケーリング、強化学習、蒸留の背後にある主要な考え方を扱う。核心となる概念だけを知りたい、下の完全な実装を動かすつもりはない、という人には、任意の予習としてちょうどいいはずだ。
ここからが本編だ。主要な解説動画は全 8 本ある。
1. 動機とコード環境の構築
第 1 回ではまず、従来の LLM、推論モデル、agent の関係を説明する。続いて本題に入り、プログラミング環境を構築する。uv を使って Python や PyTorch などの依存関係をインストールするところまでだ。ハードウェアの選び方や、よくある環境設定のトラブルについても触れる。
この回の内容
- 従来の LLM、推論モデル、agent harness の関係
- コードを書いて実装しながら学ぶほうが効果的な理由
- このシリーズの範囲
- Python 依存関係のインストール
- ハードウェアの選択、CUDA または Apple Silicon 対応の確認
- VS Code でリモート GPU に接続する方法と、環境トラブルの切り分け
2. ベースモデルの読み込み、テキスト生成、KV キャッシュ
後の動画で推論手法を組み込む前に、動くベースモデルが必要だ。ゼロからの学習は別の本の話なので(Build A Large Language Model (From Scratch) を参照)、ここでは学習済みモデルから始める。
このステップでは Qwen3 0.6B の学習済み重みを読み込み、ストリーミングのテキスト生成器で生成パイプラインを実装する。さらに KV キャッシュとモデルのコンパイルを加えて、生成を効率化する。
この実装がベースラインになり、後の動画で評価・改善する土台のコンポーネントもここで揃う。
扱う内容
- テキストをトークンにエンコードし、テキストにデコードし直す
- Qwen3 の重みをダウンロードし、指定した計算デバイスにモデルを読み込む
- テンソルの形状、logits、次のトークンの予測を整理する
- 貪欲法によるデコードとストリーミング生成を実装する
- 系列終端トークンを処理し、生成速度を計測する
- KV キャッシュを導入し、アテンションの key と value を再利用する
- KV キャッシュと
torch.compileを組み合わせ、ハードウェアごとの性能を比較する
3. 評価と強化学習のためのバリデータを構築する
本講では数学の解答バリデータをゼロから作る。解答の抽出から正規化、数学的等価性の判定までを順に実装し、最後にそれを使って MATH-500 でモデルを評価する。
このバリデータを使えば、ベースモデルの MATH-500 評価データセット上での性能を測れる。
バリデータにはもう一つ用途がある。検証可能な報酬を用いた強化学習(RLVR)の報酬信号として使うことだ。これについては本シリーズの後半で扱う。
本講の内容
- バリデータの概要と、LLM の評価手法の中でそれが占める位置(他の手法は本書の付録で扱う)
- 解答の検証を RLVR の報酬信号として再利用する(第 6 章で詳しく述べる)
- バリデータの処理フロー:最終解答の抽出、解答の正規化、数学的等価性の判定
- 解答採点器と MATH-500 の評価ループの実装
- MATH-500 上でのベースモデルと推論モデルの比較
4. 推論時のスケーリング:サンプリングと自己整合性
次は、モデルの重みを固定したまま、どうすれば回答の質を上げられるかを見ていく。ただし、具体的な推論スケーリングの手法を実装する前に、同じプロンプトから複数の異なる回答を生成する手段が要る(ChatGPT のようなプロプライエタリな LLM チャットボットはどれもこれをやっている。標準的な手法だ)。
具体的には、温度スケーリング、多項分布サンプリング、top-p フィルタリングを実装し、多様な回答を生成する。そのうえで自己整合性を使って複数の回答をまとめ、最終的な答えを多数決で決める。
回答の精度と、候補を増やすためにかかる追加の計算コストとのトレードオフも見る。
扱うトピック
- 追加の計算が訓練段階と推論段階でそれぞれモデルの性能にどう影響するかの比較
- 思考連鎖プロンプティングから推論スケーリングに入る
- 温度スケーリングと多項分布サンプリングを実装し、多様な回答を生成する
- top-p フィルタリングを加え、多様な回答の質を制御する
- 最も普及している推論スケーリング手法のひとつである自己整合性で候補の回答をまとめる
- MATH-500 の精度と、推論にかかる追加の計算コストの関係を評価する
5. 推論時のスコアリング:スコアリングと自己改善
前回の動画を踏まえて、同じプロンプトから生成した複数の回答を比較するスコアリング関数を実装する。これらのスコアリング手法は、前回扱った自己整合性における同点の解消にも使える。
ここで扱うスコアリング手法には、トークンと系列の対数確率の計算が含まれる(後の強化学習の章でも使う)。続いて自己改善ループを実装する。モデルが回答に対して批評を述べ、修正版を出そうとする。
評価を通じて、こうした追加のステップがモデルにとってどれだけ役立つかを確かめられる。
この節の内容
- スコアリング関数で複数の回答を比較し、同点を解消する
- 簡単なヒューリスティックスコアラーを実装する
- トークン確率と系列の尤度を計算する(後の講義でも使う)
- 対数確率で数値的な安定性を高める
- 批評と修正済みの回答を生成する自己改善ループを構築する
- MATH-500 で自己改善の効果を評価する
6. 強化学習:RLVR のための GRPO の実装
ここからは、検証可能な報酬を用いた強化学習(RLVR)という訓練手法の実装に移る。まずは簡略版の GRPO(Group Relative Policy Optimization)を実装する。回答をグループ単位で生成し、検証器で採点し、その相対報酬を使って訓練中にモデルの重みを更新する。
この講義の内容
- 推論トレースを生成し、回答の長さと問題解決能力の関係を理解する
- LLM のポストトレーニングにおける 2 つの重要な手法、人間のフィードバックによる強化学習(RLHF)と検証可能な報酬を用いた強化学習(RLVR)を議論し、比較する
- 検証器のスコアを報酬と相対アドバンテージに変換する
- 系列の対数確率と簡略版 GRPO 損失を計算する
- ログ記録とチェックポイント保存を組み込んだ訓練ループを構築する
- チェックポイントを評価し、訓練の安定性とメモリ要件を確認する
7. 強化学習:追跡、クリップした方策比、KL 項
前回の講義で訓練ループは実装済みなので、ここでは訓練プロセスをもう少し細かく分析していく。
具体的には、この動画で検査と訓練に使う指標をいくつか追加する。エントロピーとアドバンテージの統計、クリップ後の方策比、KL 損失項の値、そしてフォーマット報酬だ。
その後、訓練ログと評価結果を見て、追加した項目がそれぞれ何の役に立つのか、クリップした方策比や KL 損失項のような変更が本当に効果があるのかを確かめる。
本講義の内容
- より長い訓練実験を回し、そのログを読み解く
- アドバンテージとエントロピーを追跡し、訓練の挙動を理解する
- 方策損失にクリップを実装し、その効果を分析する
- KL 損失項を加え、報酬ハッキングについて議論する
- 簡略化した KL 形式の限界を理解する
- フォーマット報酬を実装し、答えの正しさを条件にする
- MATH-500 で各 checkpoint を比較し、GRPO の今後の研究方向を探る
8. 推論モデルの蒸留
最後に、より小さな推論モデルを訓練するもう一つの方法を扱う。より強力で大規模な教師モデルが生成した回答から学ぶ、というアプローチだ。蒸留のさまざまな形態を整理し、推論用データを用意し、教師あり学習のループを実装する。
この講義はコース全体の締めくくりでもある。蒸留したモデルを MATH-500 で評価し、結果を比較する。ここまでで本シリーズは、強化学習で推論能力を育てる道だけでなく、もう一つの道筋も示したことになる。
本講義の内容
- 蒸留の組み合わせと手法を比較する。ソフト蒸留とハード蒸留、on-policy 蒸留と off-policy 蒸留を含む
- MATH データセット向けに、教師モデル(DeepSeek R1 を使用)の回答を生成・収集する
- 蒸留データセットを準備する。トークン化と訓練・検証・テストへの分割を含む
- 回答トークンの対数確率を計算し、交差エントロピー損失を理解する
- 教師あり学習を実装し、訓練損失と検証損失を追跡する
- 各チェックポイントを MATH-500 で評価し、蒸留の結果を比較する
最後に
講義を見ていて面白いアイデアが浮かんだら、ときどき手を止めて自分で小さな実験をしてみてほしい。
たとえば、サンプリングの設定を適当に変えてみる、間違えた例をいくつか眺めてみる、演習問題の提案をもとに別のアプローチのバリエーションを試してみる、そんなところだ。
動画に沿った全文解説、図表、演習をまとめて読みたい場合は、Build a Reasoning Model (From Scratch) が Manning と Amazon で入手できる。
Ahead of AI を読んで応援してくれてありがとう。しばらく休んで充電し、来月には新たな LLM 研究の記事を携えて戻ってくる。
それまでの間、どうぞ楽しんで、存分に手を動かしてほしい。