构建你自己的推理模型:完整视频课程
Sebastian Raschka 为其新书录制了八讲课程,从预训练的 Qwen3 0.6B 出发,依次讲解验证器、推理时扩展、GRPO 与蒸馏,全程使用 PyTorch。
中文
复制
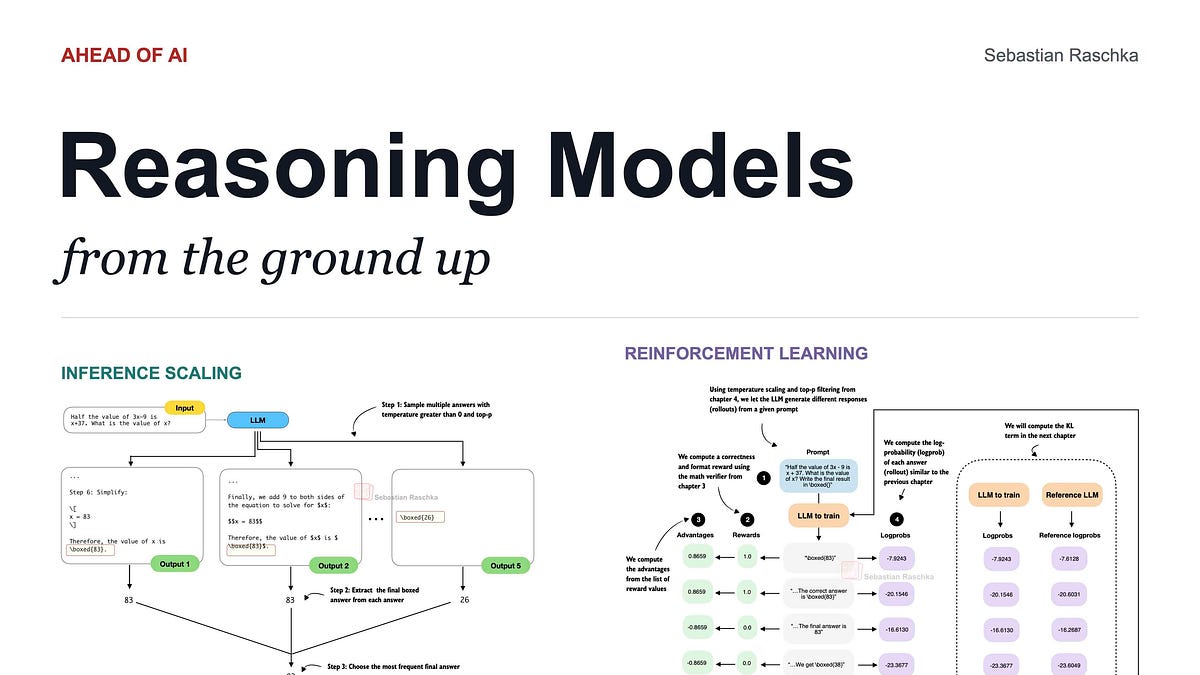
过去两年,我在 Ahead of AI 上写了不少关于推理模型的内容,最近一篇讲的是如何控制当代 LLM 的推理强度。推理模型的重要性丝毫未减。事实上,如今几乎所有当代 LLM 要么本身就是推理模型,要么提供推理模式。
如果你对推理模型的原理感兴趣,包括推理阶段的扩展、强化学习和蒸馏,可以看我最近写的 Build Reasoning Model (From Scratch),书中用 PyTorch 从零实现了这些方法。以我的经验,这仍然是理解和弄清事物真正运作方式的最佳途径。
最近几个月,我还坐下来录制了配套课程,想在这里分享给大家。下面就是八个从零构建推理模型的编程视频(共 11 小时内容)。
我们从预训练 LLM 出发,用 Python 和 PyTorch 实现评估和改进它的方法。如果你喜欢我去年的 Coding LLMs from the Ground Up 课程,这套视频基本上就是它的续集(不过没上过那门课也可以直接看)。
我目前正在短暂休息,下个月会带着更多有趣的 LLM 研究综述回来。在此期间,希望你看得开心、跟着一起写代码!
LLM、推理模型与智能体如何关联、如何配合
先补一小段说明。经常有人问我推理模型与如今的 AI 智能体是什么关系,所以在进入视频之前先简单讲讲。
推理模型本质上是常规 LLM 的升级版,通过带可验证奖励的强化学习增加更多后训练(也可以选用推理阶段的扩展技术),让它更有能力解决更难的问题。传统上,推理模型是为数学和代码开发的,但这些能力也可以泛化到其他问题领域。
推理模型随后充当智能体 harness 内部的引擎。harness 是围绕 LLM/推理模型搭建的软件或工具框架,用来应对更具挑战性的任务(更大的编程任务、旅行预订,以及各种个人助理类任务)。harness 的职责是精细的上下文管理,并让 LLM 能够使用工具。
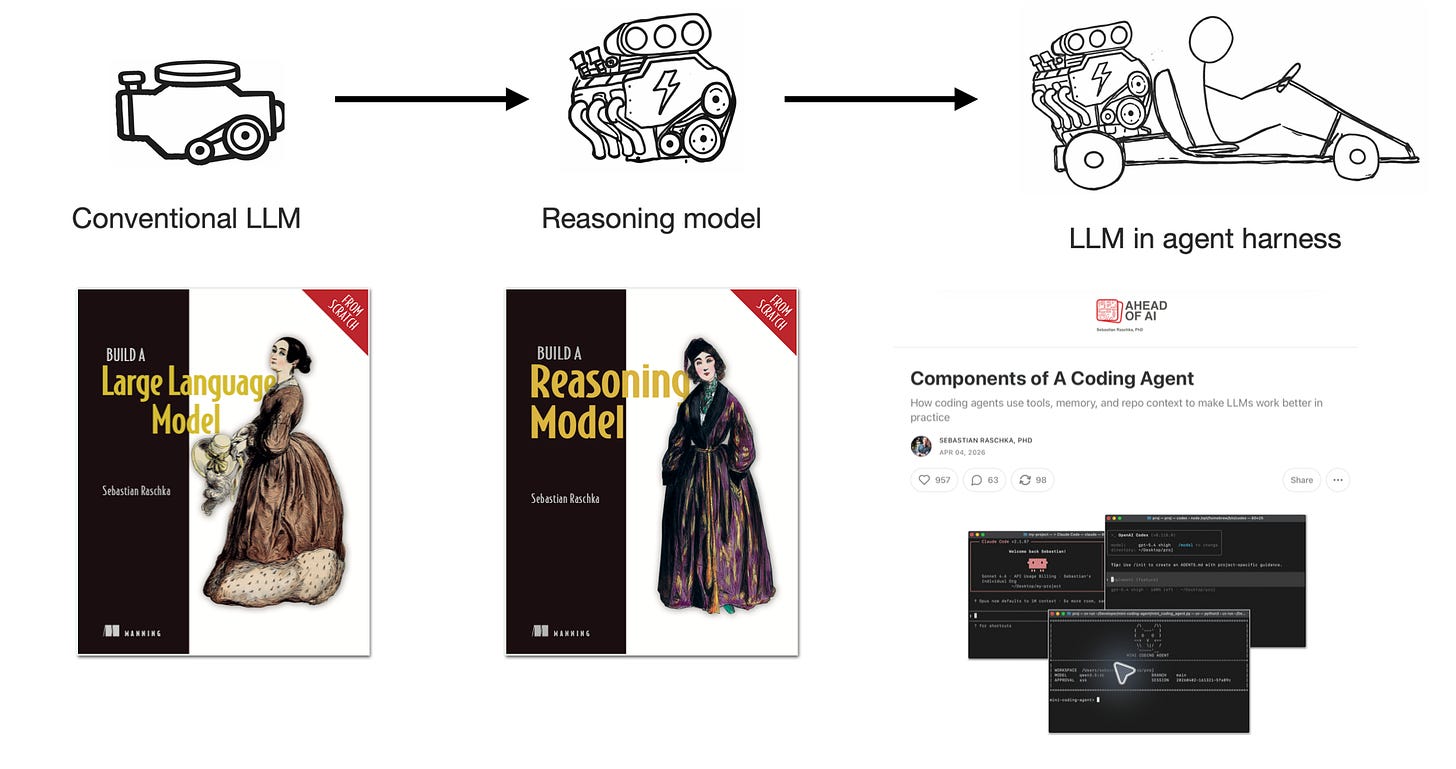
图 1:传统 LLM、推理模型与 agent harness 的引擎类比。图出自我的 Components of a Coding Agent 一文。
在上图的类比里,模型是引擎,agent harness 则加上了各种机械结构,让我们能把它用于不同用途(相当于从简单的聊天机器人界面升级而来)。agent 既可以搭配传统 LLM,也可以搭配推理模型,但推理模型更常见,因为能力更强。(如前所述,当前大多数 LLM 都是推理模型,只是推理强度设置可以调整。)
所以,作为“引擎”的推理模型,仍然是理解现代 LLM agent 的重要一环。
上述主题配套的资源如下。
- Build a Large Language Model (From Scratch) 书和视频
- Build A Reasoning Model (From Scratch) 书(以及下方的视频)
- Substack 上的 Components of a Coding Agent 文章
下面的视频聚焦于开发能为这类系统提供动力的推理模型。
范围与前置知识
reasoning-from-scratch 系列视频以一个小的预训练 Qwen3 模型为基础,我们用 Python 和 PyTorch 亲手实现各种推理方法。从预训练模型起步,可以让我们专注于真正有意思的部分,也就是评估、推理时扩展、强化学习和蒸馏。
关于前置知识,我建议你对 Python 和 PyTorch 比较熟悉。推理部分的内容我按独立材料来设计,所以此前 Build A Large Language Model (From Scratch) 的内容是推荐而非必需。
算力方面,早期的文本生成和评估示例在 CPU 上就能跑。后面的实验,尤其是训练,有 GPU 会实际得多。第一个视频讲了环境搭建和一些额外建议;代码仓库里也有硬件与环境建议。
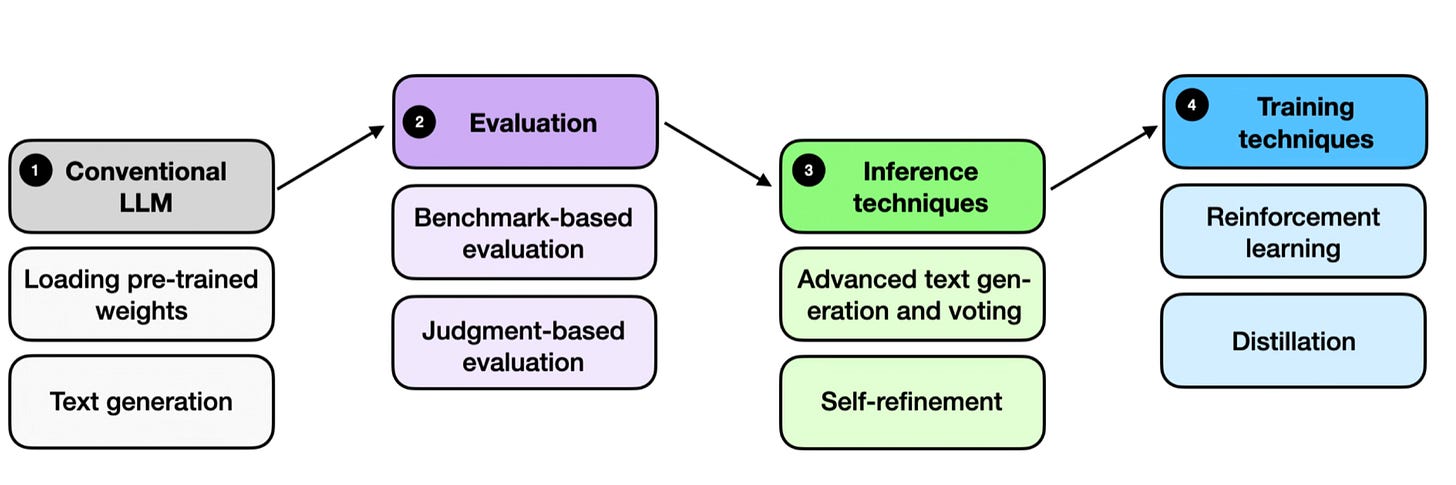
图 2:所涵盖主题的概览。
配套书籍
这些视频是我这本书 Build a Reasoning Model (From Scratch) 的配套内容。如果你想更详细地、按自己的节奏阅读讲解,做做习题,我推荐把这本书作为配套材料。
想要最深入的学习体验,我的建议是读一章,对照相应的视频把代码跑一遍,然后再做习题。
这本书在 Manning 和 Amazon 有售,纸质版是全彩的!
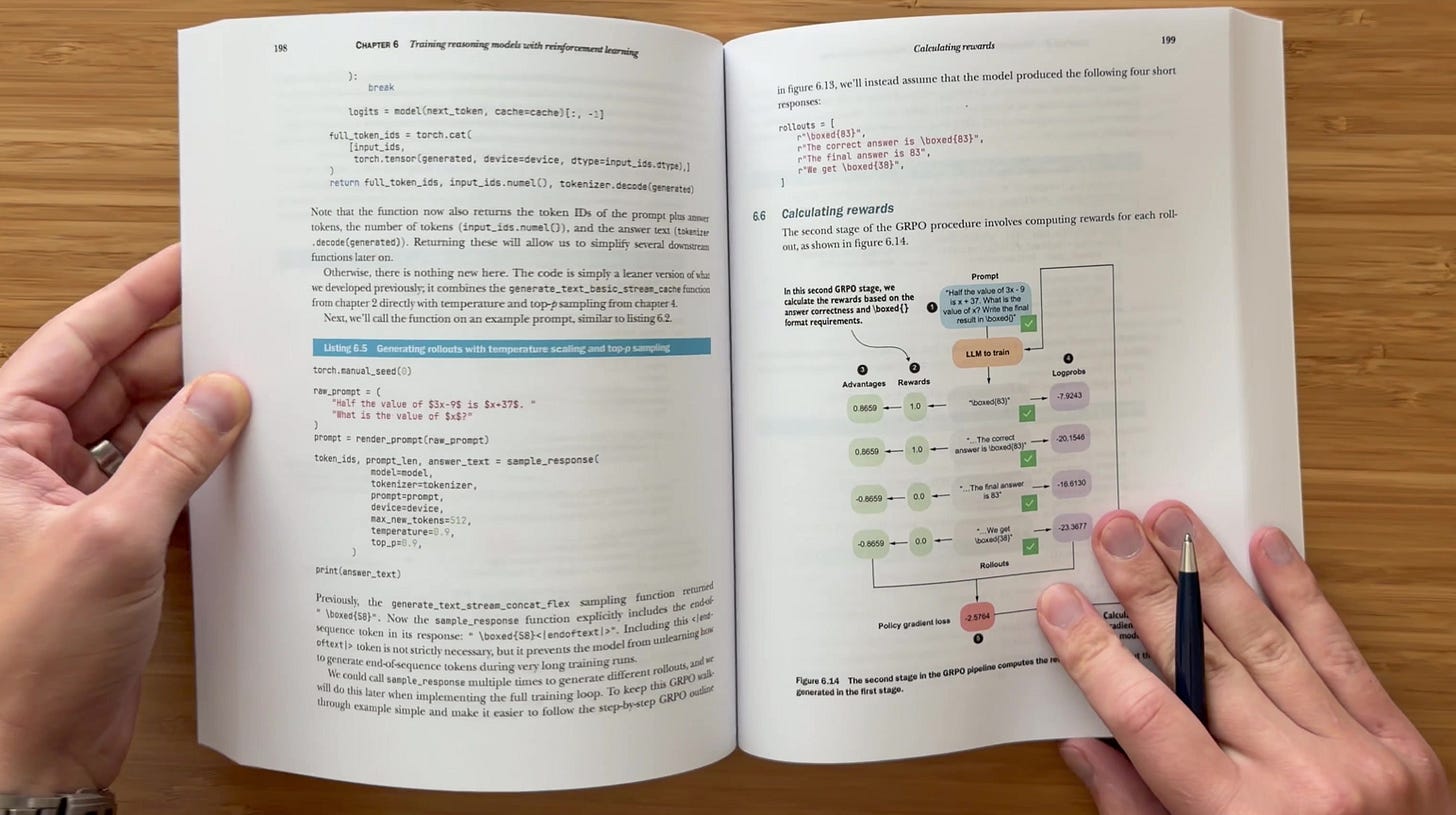
图 3:《从零构建推理模型》纸质书中的一段随机摘录。
感谢每一位购买本书或把它推荐给朋友的人。你们的支持让我能继续创作这些内容。
视频
在进入正片之前,最后再简单提一句:如果想要一个更短、更偏概念性的概览,我也推荐我在 LinkedIn Learning 上的 AI 推理模型课程(通过那里的链接访问时,24 小时内应该免费,且不需要 LinkedIn Premium 订阅)。
这门课大约 90 分钟,讲解推理模型的工作原理,涵盖推理时扩展、强化学习和蒸馏背后的主要思路。如果你只想了解核心概念、不想动手跑下面的完整实现,它可以作为一个不错的可选预览。
下面是正文部分:八集主要讲解视频。
1. 动机与代码环境搭建
第一集先解释传统 LLM、推理模型和 agent 之间的关系。接着进入本集的主题,搭建编程环境,包括用 uv 安装 Python 和 PyTorch 等依赖。我也会谈到硬件选择以及常见的环境配置问题。
本集内容
- 传统 LLM、推理模型与 agent harness 之间的关系
- 为什么通过写代码实现来学习更有效
- 本系列视频的范围
- 安装 Python 依赖
- 选择硬件,检查 CUDA 或 Apple Silicon 支持
- 用 VS Code 连接远程 GPU,以及环境问题的排查
2. 加载基础模型、文本生成与 KV 缓存
在后续视频中加入推理方法之前,我们需要一个能跑起来的基础模型。从头训练是另一本书的内容(见 Build A Large Language Model (From Scratch)),所以这里直接用一个预训练模型起步。
这一步加载 Qwen3 0.6B 的预训练权重,然后用流式文本生成器实现文本生成流程,并加入 KV 缓存和模型编译,让生成更高效。
这些实现给出了基线,也搭好了后续视频中要评估和改进的基础组件。
涵盖内容
- 将文本编码为 token,再解码回文本
- 下载 Qwen3 权重,并在选定的计算设备上加载模型
- 梳理张量形状、logits 与下一个 token 的预测
- 实现贪心解码与流式文本生成
- 处理序列结束 token,测量生成速度
- 加入 KV 缓存,复用注意力的 key 和 value
- 将 KV 缓存与
torch.compile结合,比较不同硬件的性能
3. 构建用于评估与强化学习的验证器
本讲从头搭建一个数学答案验证器,从答案抽取,到归一化,再到数学等价性判断,一步步实现。然后用它在 MATH-500 上评估模型。
我们用这个验证器评估基座模型在 MATH-500 评测数据集上的表现。
不过,验证器在本系列后面还有第二个用途,就是为带可验证奖励的强化学习(RLVR)提供奖励信号。
本讲内容
- 验证器简介,以及它在 LLM 评估方法中的位置(其他方法见本书附录)
- 复用答案验证作为 RLVR 的奖励信号(第 6 章会详细展开)
- 验证器的流程:抽取最终答案、归一化答案、判断数学等价性
- 实现答案判分器和 MATH-500 的评估循环
- 在 MATH-500 上对比基座模型与推理模型
4. 推理时扩展:采样与自洽性
接下来我们看看在模型权重固定的前提下,如何提升答案质量。不过在动手实现具体的推理扩展技术之前,先得有一种能从同一个提示生成多个不同答案的方法(专有 LLM 聊天机器人如 ChatGPT 都这么做,这属于标准做法)。
具体来说,我们实现温度缩放、多项分布采样和 top-p 过滤,以生成多样化的回答。然后用自洽性把多个回答组合起来,对它们的最终答案做多数投票。
我们还会考察答案准确率与生成更多候选答案所需的额外计算之间的权衡。
涵盖的主题
- 比较额外计算在训练阶段和推理阶段分别如何影响模型表现
- 通过思维链提示入门推理扩展
- 实现温度缩放和多项分布采样,生成多样化的答案
- 加入 top-p 过滤,控制多样化答案的质量
- 用自洽性组合候选答案,这是最流行的推理扩展技术之一
- 评估 MATH-500 准确率与额外推理计算成本之间的关系
5. 推理时扩展:打分与自我改进
在上一段视频的基础上,我们实现打分函数,用来比较同一个提示词生成的多个答案。这些打分方法也可以用来打破自一致性中的平局(上一讲已介绍过)。
这里介绍的打分方法包括计算 token 与序列的对数概率(后面的强化学习章节也会用到)。随后我们实现一个自我改进循环:模型对答案提出批评,并尝试给出修订版。
通过评估,我们可以检验这些额外步骤对模型到底有多大用处。
本节内容
- 用打分函数比较多个答案、打破平局
- 实现一个简单的启发式打分器
- 计算 token 概率与序列似然(后续课程也会用到)
- 用对数概率提升数值稳定性
- 构建自我改进循环,生成批评与修订后的答案
- 在 MATH-500 上评估自我改进的效果
6. 强化学习:实现用于 RLVR 的 GRPO
本讲转向一种训练技术的实现,即带可验证奖励的强化学习(RLVR)。我们先实现一个简化版的组相对策略优化(GRPO),生成成组的回答,用验证器为其打分,再在训练中用这些相对奖励更新模型权重。
本讲内容
- 生成推理轨迹,理解回答长度与解题能力之间的关系
- 讨论并比较两种重要的 LLM 后训练方法:基于人类反馈的强化学习(RLHF)与带可验证奖励的强化学习(RLVR)
- 将验证器分数转换为奖励和相对优势
- 计算序列对数概率和一个简化版 GRPO 损失
- 搭建训练循环,并加入日志记录和检查点保存
- 评估检查点,检查训练稳定性和内存需求
7. 强化学习:跟踪、裁剪策略比率与 KL 项
上一讲已经实现了训练循环,现在回过头来,可以更细致地分析训练过程。
具体来说,这个视频补充了更多用于检查和训练的指标,包括熵与优势统计、裁剪后的策略比率、KL 损失项的值,以及格式化奖励。
随后我们会查看训练日志和评估结果,弄清这些新增内容各自起什么作用,以及裁剪策略比率、KL 损失项这类改动是否真的有用。
本讲内容
- 运行更长的训练实验并解读其日志
- 跟踪优势与熵,理解训练行为
- 在策略损失中实现裁剪并分析其效果
- 加入 KL 损失项,并讨论奖励黑客
- 理解简化 KL 形式的局限
- 实现格式奖励,并使其以答案正确性为条件
- 在 MATH-500 上比较各 checkpoint,并探讨 GRPO 的后续研究方向
8. 蒸馏推理模型
最后,我们探讨另一种训练小型推理模型的方法,从更强大(也更大)的教师模型生成的答案中学习。我们会讨论蒸馏的不同形式,准备推理数据,并实现监督训练循环。
本讲也是整个课程的收尾,在 MATH-500 上评估蒸馏后的模型并比较结果。至此,本系列除了通过强化学习培养推理能力之外,还给出了另一条路径。
本讲内容
- 比较蒸馏的不同组合与做法,包括软蒸馏与硬蒸馏、on-policy 与 off-policy 蒸馏
- 为 MATH 数据集生成并收集教师模型给出的答案(使用 DeepSeek R1)
- 准备蒸馏数据集,包括分词以及训练/验证/测试划分
- 计算答案 token 的对数概率,理解交叉熵损失
- 实现监督训练,跟踪训练损失与验证损失
- 在 MATH-500 上评估各个检查点,比较蒸馏结果
最后几句话
看这些讲座时,如果冒出什么有意思的想法,不妨偶尔停下来,自己做个小实验。
比如,随意改动采样设置,翻看几个答错的例子,或者围绕练习题里的建议,试试不同思路的变体。
如果你想要配合视频的完整文字讲解、图表和练习,可以在 Manning 和 Amazon 找到 Build a Reasoning Model (From Scratch)。
感谢阅读和支持 Ahead of AI。我要短暂休息一下,给自己回回血,期待下个月带着新一轮 LLM 研究文章回来。
在那之前,祝你观看愉快,也祝你玩得开心。