ゼロからの分離型推論
Cerebras は prefill と decode を異なるハードウェアに分離:演算強度が異なり、スケジューリング目標も異なるため、分離後は同じハードウェア量でスループットが5倍向上し、生成速度は低下しない。記事は行列積から KV 転送と異種分離の選定までを解説。
日本語
コピー
ゼロから始めるディスアグリゲーテッド推論
推論のスループットを上げるには、従来ならハードウェアを増やすか、より多くのリクエストを並行処理させるしかなかった。だが並行度を上げれば、ユーザーごとのトークン生成速度は落ちる。そこで「ディスアグリゲーション」と呼ばれる手法を使い、初期の結果でスループットを5倍にした。Cerebras のシステム台数は変えず、トークン生成速度も一切落とさずに、だ。Cerebras では異種ディスアグリゲーション、つまり複数種類のチップを同じ推論システムに組み込む研究を主導している。推論のうちメモリ律速な部分と計算律速な部分を別々のハードウェアに担わせれば、同種構成のディスアグリゲーションでは得られない利点が得られる。これはシリーズの第1回だ。「ディスアグリゲーション」という言葉を聞いたことがある、あるいは「prefill は計算律速、decode はメモリ律速」という説明を聞いたことはあるが、それが具体的に何を指すのかはよく分かっていない——そんな人に向けて書いている。まずは一番基礎的なところから、この直感を組み立てていく。
- アクセラレータは計算とメモリ転送の間でどうバランスを取るのか
- 推論の各段階とは何か
- なぜ段階ごとにハードウェアへの要求が違うのか
- ディスアグリゲーションがシステム全体をどう改善するのか
アクセラレータの仕組み
アクセラレータとは、特定の種類の計算を速くするために作られたハードウェアだ。GPU はその一例にあたる。アクセラレータは、プログラムを協調して実行する2つの部分からなると考えられる。
- 計算ユニットは実際の算術演算——加算、乗算、ビット演算など——を担う。
- メモリはデータを保持する。通常はユーザー入力、モデルの重み、中間値、結果が含まれる。
GPU の計算 各ブロックが1つの計算ユニット。算術演算は並列に実行される。
算術演算はアクセラレータの計算ユニットの中だけで起きる。メモリの中では起きない。つまり、どんな計算にもデータの移動がつきまとう。アクセラレータを効率よく使うには、1回の転送でできるだけ多くの演算をこなすようエンジニアが工夫する。データをメモリから持ってきたあと、次の転送までの間に何回計算できるか? 算術強度はこの効率、すなわち一定量のデータを転送するのに対応する計算の「仕事量」を測る指標だ。より正確には、浮動小数点演算の回数を転送したバイト数で割ったものになる。
算術強度は FLOPs を転送バイト数で割った値。算術強度 = FLOPs / 転送バイト数
算術強度は1バイト動かすごとにどれだけ計算したかを教えてくれるが、ある演算がどれだけ速く走るかを直接教えてくれるわけではない。プロセッサがほとんどの時間をデータ待ちに費やしているならメモリ帯域が最も重要で、計算で忙しくしているなら演算能力のほうが重要になる。算術強度を腹に落とすことが、LLM の各計算段階を理解する鍵だ。実際の例をいくつか見ていこう。
2つの行列の加算
まずは単純な行列の加算から。これをアクセラレータで行うには、2つの行列をメモリから読み込み、計算コアで加算し、結果を書き戻す。具体的な例で見てみよう。ここではメモリから2つの数(各2バイト)をロードし、それらを足す1回の FLOP を実行し、2バイトの結果をメモリに書き戻す。つまり1 FLOP に対して6バイトの転送で、算術強度は0.167 FLOPs/バイトになる。
算術強度:1 FLOPs ÷ 転送6バイト:4バイトを計算ユニットにロード、2バイトをメモリに保存。1 FLOPs / 転送6バイト = 0.167 FLOP/バイト メモリ ロード4バイト 保存2バイト 計算 各値は2バイト。加算1回につき2つの値を読み、1つの結果を書く。6バイトで1 FLOP。任意のセルをホバーまたはクリックすると、対応する入力と出力を追跡できる。各行列内では矢印キーで移動でき、Escape で選択を解除する。
スライダーで行列のサイズを大きくすると、計算回数と転送バイト数が比例して一緒に増えることに注目してほしい。つまりこの例では、行列が大きくなるほど総 FLOPs は増えるが、相対的な算術強度は変わらない。
行列の乗算
次は別の例だ。行列の乗算も基本的な流れは同じで、2つの入力行列をメモリからロードし、計算ユニットでそれらの値を掛けて足し合わせ、結果の行列をメモリに書き戻す。ただし加算と違い、各出力値は1つ目の行列の行全体と2つ目の行列の列全体から計算される。ある出力値にマウスを重ねると、その計算に関わる入力値が見える。
算術強度:45 FLOPs ÷ 転送54バイト45 FLOPs54バイトの転送 = 0.833 FLOP/バイトメモリ ロード36バイト 保存18バイト 計算 各値は2バイト。各入力は1回の読み取り、各結果は1回の書き込みとして数える。N 行 N 列の行列では、各結果に N 回の乗算と N − 1 回の加算が必要になる。任意の入力にホバーまたはクリックすると影響を受ける出力が見え、出力をクリックすると計算に関わる入力が見える。各行列内では矢印キーが使え、Escape で選択を解除する。
行列の規模を大きくすると何が起きるかに注目してほしい。アクセラレータは依然として各入力値を1回だけロードし、各結果を1回だけ書き込む。だがロードされた各値は、より多くの出力値の計算に関与できるようになる。データ転送量は行列の要素数に比例して増えるが、演算量はそれよりも速く増える。行列の乗算では、片方の入力行列だけが変わっても算術強度を上げられる。次の例では2つ目の行列だけを操作できるようにしている。もう一度スライダーを試してほしい。
算術強度:15 FLOPs ÷ 転送30バイト15 FLOPs30バイトの転送 = 0.500 FLOP/バイトメモリ ロード24バイト 保存6バイト 計算 各値は2バイト。各入力は1回の読み取り、各結果は1回の書き込みとして数える。左側の行列は3×3で固定。右側の行列は3行で、列数は1から6まで。各結果には3回の乗算と2回の加算が必要になる。固定された左側の行列は18バイトを占め、入力列が1つ増えるごとに6バイト多くロードし、6バイト多く保存する。任意の入力にホバーまたはクリックすると影響を受ける出力が見え、出力をクリックすると計算に関わる入力が見える。各行列内では矢印キーが使え、Escape で選択を解除する。
入力がひとつ変わるだけでも、演算強度は入力規模とともに上がる。入力規模と演算強度のこの関係こそ、推論の各段階を理解する鍵になる。
推論の演算強度
推論とは行列積の連鎖だ。ここでは、これまでに学んだ概念を使って言語モデルを理解してみる。言語モデルのアーキテクチャの複雑さを全部掘り下げるつもりはない。だが今回の目的に限れば、言語モデルがトークンを1つ生成するとは、モデルの重みと入力トークンの間の行列演算にほかならない。
モデルの重み213352421135132413135241413524241352入力maytheforce321524142352213135352413135241413524 出力を計算be131113161825161711272125101613162320161922193235191515262233122113232721
左側の入力行列はモデルの重みを表す。訓練で得られた値であり、推論中は変わらない。右側の入力行列はモデルが処理すべき入力トークンを表す。各列はあるトークンの数値表現だと思えばいい。出力トークンを1つ生成するには、アクセラレータが重みと入力をメモリから計算ユニットへ運び、行列積の連鎖を実行する(ここでは1回の演算に単純化している)。再生をクリックして、下の流れを追ってみてほしい。
連続した1回の生成に見えるものは、実際にははっきり異なる2つの段階に分かれている。まずモデルがプロンプト全体(“may the force”)を処理し、最初の応答トークン“be”を出す。次に残りの応答“with”と“you”を1つずつ生成する。この2つの段階をそれぞれ prefill と decode と呼び、演算強度の性格が大きく違う。
注意 この例ではリクエストを1つだけ追っている。本番環境では、サーバーは通常複数のリクエストをバッチにまとめ、複数ユーザー分の新規トークンを一度に処理する。こうするとモデルの重みを読み込むコストを複数のリクエストで分担できる。ただしバッチが大きくなるほど、decodeの各ステップにかかる時間も長くなりうる。全体のスループットは上がっても、各ユーザーがトークンを受け取る速度は落ちる。
Prefill
prefill段階では、プロンプト全体が並列に処理される。前の節で見たとおり、行列積が大きいほどデータの再利用が進み、演算強度は高くなる。入力プロンプトを長くすると、これがはっきりする。
実際のプロンプトは数千、ときには数十万トークンに及ぶ。100ページのPDFをチャットボットにアップロードするとは、要するに処理すべき巨大な行列計算を生成することだ。
これがprefillの演算強度が相対的に高い理由だ。大きな行列演算1回だからである。
Decode
decode段階では、トークンが1つずつ生成される。一見すると、モデルは毎回、成長し続ける系列全体を同じ大きな行列積に送り込んでいるように見える。だが言語モデルは KV cache でこれを避けている。KV cacheはそれまでのトークンで計算したkeyとvalueを保持し、再計算を不要にする。コンテキストが伸びるにつれ、このキャッシュを読み込み使うコストも増える。KV cacheの複雑さを全部説明するつもりはないが、行列の灰色の部分は、トークン生成の各ステップでキャッシュされたデータだと考えればいい。結果として、はるかに小さな行列演算になる。
キャッシュのおかげで、以前のトークンのkeyとvalueを再計算せずに済む。
注意 アクセラレータはキャッシュされたkeyとvalueを依然としてメモリから読み込み、アテンション計算に使う。図で新しいトークンだけが計算に入るように描いているのは、以前のトークンのkeyとvalueが再計算ではなく再利用されている点を強調するためだ。実際の行列演算についてはHugging FaceのKV cacheガイドを参照。
PrefillとDecodeで負荷の性格が違う
どちらの段階でも、モデルの重みはすべて計算ユニットへ送らなければならない。数百GB、場合によっては数TBのデータを運ぶことになる。prefill段階が100万トークンのプロンプトを処理していようと、decode段階が新しい入力トークンを1つだけ処理していようと、トークンを1つ生成するにはこのデータ転送をやり切る必要がある。だからこそ、prefillとdecodeはメモリ転送量が近いのに、計算負荷はまったく違う。
メモリ転送 · 演算強度 「『炎のゴブレット』の映画で、カルカロフが誰が死喰い人か暴露した?」「Barty」「Crouch」「Jr.」
共通のスケジューリング問題
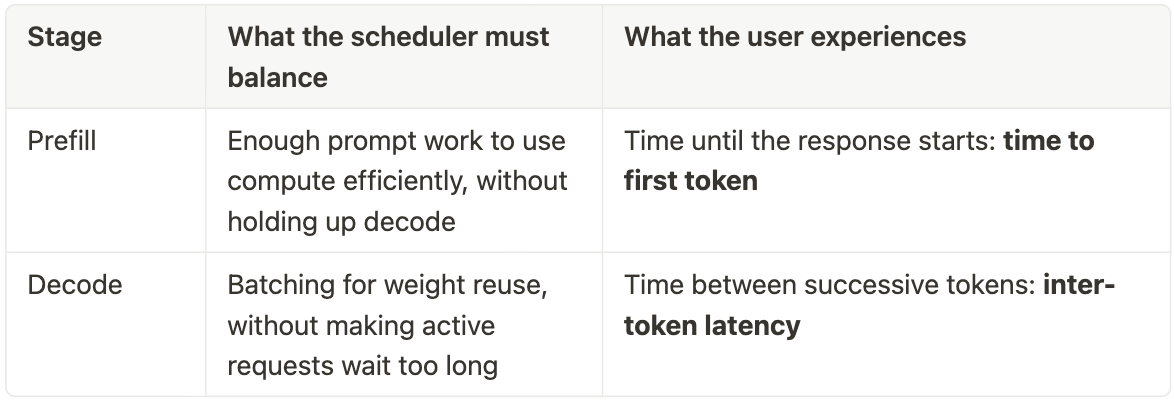
ここまでは、単一のリクエストがシステムを流れる様子だけを追ってきた。だが本番環境では、推論サーバーは通常多くのリクエストを同時に処理する。prefill段階にあるものもあれば、すでにdecode段階でトークンを生成しているものもある。prefillとdecodeが同じハードウェア上で動くと、両者は互いに干渉する。prefillは計算密度が極端に高く、進行中のdecodeリクエストを足止めしかねない。リクエストをどう割り当て、優先順位をどう並べるかはスケジューラが決める。スケジューリング戦略の違いがリクエスト処理にどう効くかを見てみよう。
Prefill · Decode · 最初のトークンリクエスト1『スター・ウォーズ』のあの有名な挨拶は何?その意味を説明して。MaytheForcebewithyou.これは、相手の前途に幸運と勇気、導きを願う言葉だ。リクエスト2このあらすじを6語でまとめて:一行が嵐の中で地図を失い、夜は星を頼りに進み、日の出前に故郷へたどり着いた。Thecrewreturnshomebeforesunrise.リクエスト3毎朝焼きたてのパンを出す地域の小さなパン屋の6語のキャッチコピーを書いて。Freshbread,warmsmiles,everymorning.時間 →
prefill を優先すれば新しいリクエストはすばやく処理に入れるが、すでにストリーミング中のユーザーを中断させることになる。decode を優先すれば進行中の応答は滑らかに流れ続けるが、新しいプロンプトは最初の応答が返るまで長く待たされる。こうした判断はエンドユーザー体験に実際に影響する。3 つのモードを切り替えて、各スケジューリング戦略がチャットボットをどう変えるか見てみよう。
You幸運を願うときの、スター・ウォーズの定番の言い回しは?その意味も説明して。Assistant…最初のトークンを待機中… 0.0 / 40123
集約型システム——prefill と decode が同じマシン群で動く——は、どちらの結果がアプリにとって重要かを決めなければならない。新しいリクエストに最初のトークンをすばやく返すことか、進行中の応答を滑らかに流し続けることか、それとも全体のスループットを最大化することか。
分離アーキテクチャ
ここまでの内容を振り返る:
- アクセラレータ(ハードウェア)が算術演算を実行する。データをメモリから計算ユニットへ運び、結果をメモリへ書き戻す、という流れだ。
- 同じ量のデータを運んでも、ワークロードによって実行される演算量は異なる。
- prefill と decode は推論の異なる 2 つの段階だ。
- prefill は計算量が多い。複数のトークンを並列に処理するからだ。
- decode は各ステップでリクエストごとに新しいトークンを 1 つしか処理しないが、モデルの重みと KV cache を読み込むために大量のメモリアクセスを必要とする。
- 同じハードウェア上でこの 2 つのワークロードのバランスを取るのは難しく、規模が大きくなれば必ずトレードオフが生じる。
分離はシステム設計のパターンだ。リソース要件の異なる処理をまず見つけ出し、それらを同じハードウェアに無理に同居させるのではなく、別々に動かす。分離型システムは 2 つの独立したハードウェアプールを使う。片方が prefill を、もう片方が decode を実行する。「Disaggregated」を選んで、スケジューリングがどう変わるか見てみよう。
プロンプトトークン · prefill · 応答トークン · decodeRequest 1Request 2Request 3Decode poolPrefill pool 時間 →
共有プールでは、初回トークン遅延とトークン間遅延が直接連動する。新しいプロンプトを起動すれば進行中の応答が遅くなりうるし、進行中の応答を守れば新しいプロンプトは待ち行列に並ぶ。分離アーキテクチャは、単に「ストリーミングを滑らかにする」だけのものではない。より根本的には、サービングシステムの制御インターフェースを変えるものだ。
トレードオフをより細かく制御できる
共有プールでは、容量・バッチ処理・スケジューリングの判断が prefill と decode の両方に同時に影響する。2 つの段階を分ければ、運用担当者はそれぞれの部分を独立に調整できる。プロダクトの要件に応じてハードウェアを配分し、バッチ処理の方針を決め、レイテンシとスループットの間でトレードオフを取る。たとえば初回トークン遅延に厳しい要件があるシステムなら、prefill に多くの容量を割り当てて新しいプロンプトを素早く処理に入れつつ、decode の容量は圧迫しない。逆にストリーミング体験の滑らかさを優先するシステムなら、decode に大きめのプールを与えるかスケジューリングを詰めて、プロンプトのトラフィックが急増しても進行中の応答が途切れず進み続けるようにできる。重要なのは、これらのプールを個別にスケールできる点だ。さまざまなシナリオをクリックして、プールがそれぞれの需要に応じてどうスケールするか見てみよう:
Prefill pool · GPU · GPU · GPU · GPU · Decode pool · GPU · GPU · GPU · GPU · プロンプト容量↑ · 同時応答数↑ · TTFT↓ · エンドツーエンド遅延↓ · 2 つの段階のバランスの取れた出発点。
分離アーキテクチャにより、システムは多様な負荷形態に適応できる。ただし、フェーズを切り分けると新たな要件が生まれる。プール間のデータ転送だ。なかでも最も重要な新しい設計が KV cache の転送である。
KV 転送
Prefill が KV cache を構築すると、システムはこの状態を decode プールへ送ってメモリにロードし、そこから生成が続く。モデルの重みはどちらのプールにもすでにロードされている。KV cache は違う。リクエストごとに固有のデータだ。この引き継ぎには追加のネットワークと調整のオーバーヘッドが伴う。だからこそ分離アーキテクチャは規模が十分に大きいときに最も価値を持つ。並行タスクが十分多ければ、prefill と decode を独立に構成・スケジューリングすることで得られる利益が、状態の転送と 2 つのプールの運用にかかるコストを上回る。Prefill が 1 つの prompt を処理し終えると、decode は prefill が生成したこのリクエスト固有の状態を必要とする。両方のプールにモデルの重みはすでにあるので、境界を越える必要があるのは KV cache だけだ。以下で 1 つのリクエストを追いながら、この引き継ぎを見ていく。
Incoming promptPrefillGPUInput · in memoryMay the force KV cache · Compute · KV transfer DecodeGPUInput · in memory KV cache · Compute · May the forceこの prompt を 2 つのプールに順に通す。Prefill が “be” を出力し、KV cache と次の token の情報を decode に渡す。Decode は “be” を使って “with” を出力し、次に “with” を使って “you” を出力する。token を処理するたびに cache へ追加していく。“You” は次のラウンドで cache に入る。アニメーションが示しているのは処理の順序であり、実測のハードウェア使用率ではない。
フェーズを分割することにもコストはある。KV cache はプール間で転送しなければならず、2 つのプールの容量と需要が噛み合わなければ、どちらかが遊んでしまう。レイテンシは cache が同一ラック内のマシン間を渡るのか、リージョンをまたぐのかによっても変わる。最終的に、この追加レイテンシを受け入れられるかは運用側が判断する。
異種分離
ここまでの例は、prefill と decode を同じハードウェアの 2 つのプールに分けるものだった。異種ハードウェアの組み合わせを持ち込むと、分離アーキテクチャはさらに力を発揮する。問題はどのアクセラレータでモデルを動かすかだけではなくなり、どのアクセラレータの組み合わせがこの負荷に最適かになる。プールごとに異なるハードウェアを割り当てられるなら、専用ハードウェアの価値が際立つ。ある次元で特に強いアクセラレータ——たとえば prompt 処理、メモリ帯域、token 速度、コスト効率——は、単一チップで分離する以上の性能向上をもたらしうる。Cerebras のオンチップ集約メモリ帯域は極めて高い。ウェハスケールのアーキテクチャはローカルメモリへの高速アクセスを中心に設計されており、推論のうち token を 1 つずつ生成する部分に特に向いている。
GPT-oss-120B 高推論強度 · 毎秒 10,000 入力 token 出力 token ↑ · Cerebras 毎秒 1,669 出力 tokenSambaNova 毎秒 708 出力 tokenGroq 毎秒 475 出力 tokenMicrosoft Azure 毎秒 319 出力 tokenNebius 毎秒 294 出力 tokenBaseten 毎秒 293 出力 token06001,2001,800Artificial Analysis ↗ · 2026 年 9 月 10 日
なぜ一部のアクセラレータは decode が得意なのか
decode の特殊性を思い出そう。新しい token を 1 つ出力するたびに、大量のデータを運ぶ必要がある。演算強度は相対的に低いので、生の FLOP を積み増しても token が速くなるとは限らない。演算ユニットにデータを供給するのはメモリだ。GPU では、モデルのデータは主に高帯域メモリ(HBM)に置かれる。計算ユニットがこれを使うには、より小さく高速なオンチップメモリとキャッシュ(SRAM を含む)を経由する。このメモリ階層は大容量と高速なローカルストレージの両方を提供するが、データは共有の外部メモリから計算コアまで結局は移動しなければならない。Cerebras は別の道を取る。SRAM と計算ユニットをウェハ全体に分散して配置するのだ。こうして演算は近くのストレージに高速にアクセスできる。
GPU 共有 HBM が多数の計算ユニットにデータを供給WSE ローカル SRAM ↔ 計算ユニット、各 cell の内部に配置
このウェハスケール設計によって、Cerebras は極めて高い集約メモリ帯域を得ている。
メモリ帯域 公表ピーク · プロセッサあたり TB/s ↑ · オンチップ SRAM · HBM · Cerebras WSE-3 · オンチップ SRAM · ウェハ21,000 TB/sオンチップ SRAM アクセラレータ · オンチップ SRAM150 TB/sHBM4 GPU 1 · HBM423.3 TB/sHBM4 GPU 2 · HBM422 TB/sHBM3e GPU 1 · HBM3e8 TB/sHBM3e GPU 2 · HBM3e8 TB/sHBM3e GPU 3 · HBM3e8 TB/sHBM アクセラレータ 1 · HBM7.38 TB/sHBM3e アクセラレータ 1 · HBM3e7 TB/sHBM3e アクセラレータ 2 · HBM3e4.9 TB/sHBM3e GPU 4 · HBM3e4.8 TB/s05k10k15k20k25kSRAM の数値はそのプロセッサのローカルメモリ帯域の合計。HBM の数値はオフチップメモリの流量を測ったもの。両者は異なるメモリ階層に属し、実測の token 速度ではない。出典とプロセッサの詳細 · 2026 年 9 月 10 日主要な AI アクセラレータを抜粋。新しく発表された設計と、本記事で用いたやや前のハードウェアを含む。各行はサーバーやラックではなく、1 つのプロセッサまたは 1 枚のウェハに対応する。公表ピークはワークロード、メモリ容量、消費電力、価格を考慮していない。Cerebras WSE-3 — オンチップ SRAM · ウェハ ↗オンチップ SRAM アクセラレータ — オンチップ SRAM ↗HBM4 GPU 1 — HBM4 ↗HBM4 GPU 2 — HBM4 ↗HBM3e GPU 1 — HBM3e ↗HBM3e GPU 2 — HBM3e ↗HBM3e GPU 3 — HBM3e ↗HBM アクセラレータ 1 — HBM ↗HBM3e アクセラレータ 1 — HBM3e ↗HBM3e アクセラレータ 2 — HBM3e ↗HBM3e GPU 4 — HBM3e ↗
分離の目的
同種分離と異種分離がもたらすのは異なる利得だ。同種システムは通常、滑らかな token 生成による応答改善を狙い、異種システムは専用ハードウェアから最大の価値を引き出すよう最適化される。Cerebras の場合、スループットを犠牲にせず極めて高い速度を提供する。5 枚の GPU で構成される集約システムを考えてみよう。各 GPU は実行時間の 80% を prefill に、20% を decode に費やす。ある応答が進むのは、それが載っている GPU が decode ステップを実行しているときだけだ。時間の 5 分の 4 を prefill に使えば、出力 token 生成の平均的なテンポは鈍る。
Prefill · Decode共有 GPU プールPrefill プールDecode プール KV 転送 GPU 1 · GPU 2 · GPU 3 · GPU 4 · GPU 5 · プロンプト応答模式的な想定模式的な prefill/decode の交互実行。decode ステップは 10 ms、転送オーバーヘッドは無視できる。総リクエストスループットは同じ。単一の decode GPU を流れるトラフィックはその 5 倍になり、応答は 5 倍速く完了する。アクティブなバッチサイズは変わらない。
この 5 枚の GPU のうち、decode が占める実行時間は GPU 1 枚分に相当する。この理想化された定常状態では、分離によってこの仕事を専用の GPU 1 枚に、prefill を残りの 4 枚に割り当てる。decode GPU は prefill と競合せずに応答を進められ、GPU の枚数を変えずに token のテンポが改善する。共有 GPU が prefill に費やす時間が長いほど、改善幅は大きい。もともと GPU が大半の時間を decode に使っているなら、同種システムで取り除ける干渉は少ない。だが干渉の削減は分離の理由の一つにすぎない。異種システムでは、分離はハードウェアの専用化をよりよく実現するためにある。5 枚の Cerebras WSE が現在どちらのフェーズも担っているとしよう。prefill を別のアクセラレータプールへ移せば、ウェハは decode に専念できる。そこが彼らの計算力にとって最も価値のある場所だ。
Prefill · Decode 共有ウェハプールprefill プールを追加Decode プール KV 転送 HW A HW B HW C WSE 1 · WSE 2 · WSE 3 · WSE 4 · WSE 5 · プロンプト応答模式的な想定模式的な 75% prefill / 25% decode の初期配分であり、ベンチマークではない。prefill、KV 転送、需要のすべてが追いついて初めて、回収した decode 時間は出力容量に変わる。Prefill プールの規模は模式的なものにすぎない。
これはWSE 1 枚あたりのスループット向上であり、追加の prefill ハードウェアによって実現する。Agentic アプリケーションは異種デカップリングと相性がいい。こうしたアプリは往々にして多ターンの長いワークフローを伴い、コンテキストは複数回のモデル呼び出しの間で増え続ける。agent が担うタスクが長く、結果の重いものになるほど、各ステップの遅延が積み上がる。推論速度が鍵になるのはそのためで、agent が触っていて快適かどうか、タスクがどれだけ速く完了するかを左右する。Cerebras のデカップリングは、推論のスケールを最上位の対話性と引き換えにせずに済ませる。
Cerebras、デカップリングによる超高速トークンのスケール拡大
超高速生成への需要は急速に高まっている。アプリケーションの agentic 化が進むにつれ、ボトルネックはモデル全体の容量ではなく、同時にどれだけの高速トークンをユーザーに届けられるかへと移った。Cerebras では、この需要に応えるために異種推論システムを構築している。狙いは総スループットの向上だけではない。推論をスケールさせながら、アプリケーションが即時応答と感じるあの超高速トークンの速度を維持することだ。従来の集約型システムでは、容量を増やすとはハードウェアを増やすことを意味した。プロンプト処理をパートナーのアクセラレータに任せることで、初期テストでは同じ WSE の占有量のまま容量を5倍に引き上げた。複数のハードウェアパートナーとの提携を発表し、より多くの超高速トークンを市場に届けようとしている。異種ハードウェアが今後の推論戦略の中心になるとの判断がそこに表れている。
プリフィルオプション · プロンプト KV 転送 Cerebras デコードプール · レスポンス
次のステップ
今後の記事では、異種デカップリング推論を本番環境に投入する方法を掘り下げる。必要となるハードウェアとソフトウェアスタックを分解し、大規模にデカップリング推論を運用する際の経済的なトレードオフも見ていく。X をフォローすれば、次回の公開時に通知が届く。