从零开始的分离式推理
Cerebras 把 prefill 与 decode 拆到不同硬件上:算术强度不同、调度目标也不同,分开后同样的硬件量下吞吐提升 5 倍、生成速度不降。文章从矩阵乘法讲到 KV 传输与异构分离的选型。
中文
复制
要提高推理吞吐量,传统做法无非是加硬件,或者让更多请求并发处理。但一味提高并发会拖慢每个用户的 token 生成速度。借助一种叫“分离”(disaggregation)的技术,我们在早期结果中把吞吐量提升了 5 倍——Cerebras 系统数量不变,token 生成速度也没有任何损失。在 Cerebras,我们正在主导异构分离的研发,也就是把多种类型的芯片组合进同一套推理系统。让不同的硬件分别承担推理中受内存限制或受算力限制的部分,我们就能获得同构分离无法带来的收益。这是本系列的第一篇。如果你听过“分离”这个词,或者听过“prefill 受算力限制、decode 受内存限制”这种说法,却不太清楚它们到底指什么,这篇文章就是为你写的。我们从最基础的地方把这个直觉建立起来:
- 加速器如何在算力和内存搬运之间取得平衡
- 推理的不同阶段分别是什么
- 为什么它们对硬件的要求不一样
- 分离如何改善整个系统
加速器如何工作
加速器是为加速特定类型的计算而构建的硬件。GPU 就是其中一例。我们可以把加速器看作协同执行程序的两个部分。
- 计算单元负责实际的算术运算——加法、乘法、按位逻辑等操作。
- 内存负责存储数据,通常包括用户输入、模型权重、中间值和结果。
GPU 计算 每个方块是一个计算单元。它们并行执行算术运算。
算术运算只发生在加速器的计算单元里,不在内存里。因此,每一次计算都离不开数据搬运。要想高效使用加速器,工程师会尽量让每次搬运换来尽可能多的算术运算:数据从内存搬过来之后,在搬运下一批之前,我们能做多少次计算?算术强度衡量的就是这种效率,即搬运一定量数据所对应的计算“工作量”。更准确地说,是浮点运算次数除以搬运的字节数。
算术强度等于 FLOPs 除以传输的字节数。算术强度 = FLOPs / 传输的字节数
算术强度告诉我们每移动一个字节做了多少计算,但它并不直接告诉我们一个运算跑得多快。当处理器大部分时间都在等数据时,内存带宽最关键;当它一直忙于计算时,算力更重要。吃透算术强度是理解 LLM 各个计算阶段的关键。下面看几个真实例子。
两个矩阵相加
先看一个简单的矩阵加法。要在加速器上完成它,需要从内存读取两个矩阵,在计算核心中做加法,再把结果写回去。来看一个具体例子。这里我们从内存加载两个数(各 2 字节),执行一次 FLOP 将它们相加,然后把 2 字节的结果写回内存。于是 1 FLOP 对应 6 个传输字节,算术强度为 0.167 FLOPs/字节。
算术强度:1 FLOPs 除以传输的 6 字节:4 字节加载进计算单元,2 字节存回内存。1 FLOPs / 6 传输字节 = 0.167 FLOP/字节 内存加载 4 字节 保存 2 字节 计算 每个值占 2 字节。每次加法读取两个值、写入一个结果:6 字节对应 1 FLOP。悬停或点击任意单元格,可追踪与之对应的输入和输出。在每个矩阵内可用方向键移动;按 Escape 清除选择。
注意,用滑块增大矩阵尺寸时,计算次数和传输字节数会按比例一起增长。所以在这个例子里,矩阵越大总 FLOPs 越多,但相对的算术强度保持不变。
矩阵乘法
再看一个不同的例子。矩阵乘法的基本路径相同:从内存加载两个输入矩阵,在计算单元中把它们的值相乘并累加,再把结果矩阵写回内存。但与加法不同的是,每个输出值都由第一个矩阵的一整行和第二个矩阵的一整列共同算出。把鼠标悬停在某个输出值上,就能看到参与计算它的输入值:
算术强度:45 FLOPs ÷ 54 字节传输量45 FLOPs54 字节传输量 = 0.833 FLOP/字节内存 加载36 字节 保存18 字节 计算 每个值占 2 字节。每个输入计一次读取,每个结果计一次写入。对于 N 行 N 列的矩阵,每个结果需要 N 次乘法和 N − 1 次加法。悬停或点击任意输入可查看受影响的输出,点击输出可查看参与计算的输入。在每个矩阵内可使用方向键;按 Escape 清除选择。
注意矩阵规模增大时发生了什么。加速器仍然只加载每个输入值一次、写入每个结果一次,但每个被加载的值现在可以参与更多输出值的计算。数据搬运量随矩阵元素数量增长,而算术量的增长更快。对于矩阵乘法,即使只有一个输入矩阵发生变化,我们也能提高算术强度。在下一个例子中,我们只让第二个矩阵可交互。再试一次滑块:
算术强度:15 FLOPs ÷ 30 字节传输量15 FLOPs30 字节传输量 = 0.500 FLOP/字节内存 加载24 字节 保存6 字节 计算 每个值占 2 字节。每个输入计一次读取,每个结果计一次写入。左侧矩阵固定为 3×3。右侧矩阵有 3 行、1 到 6 列。每个结果需要 3 次乘法和 2 次加法。固定的左侧矩阵占 18 字节;每新增一个输入列,就多加载 6 字节、多保存 6 字节。悬停或点击任意输入可查看受影响的输出,点击输出可查看参与计算的输入。在每个矩阵内可使用方向键;按 Escape 清除选择。
即使只有一个输入在变化,算术强度也会随输入规模增长!输入规模与算术强度之间的这种关系,是理解推理不同阶段的关键。
推理的算术强度
推理是一连串的矩阵乘法。本节中,我们将把前面学到的概念用于理解语言模型。本文不会深入语言模型架构的全部复杂性。但就我们的目的而言,从语言模型生成一个 token,本质上就是模型权重与输入 token 之间的一次矩阵运算:
模型权重213352421135132413135241413524241352输入maytheforce321524142352213135352413135241413524 计算输出be131113161825161711272125101613162320161922193235191515262233122113232721
左侧输入矩阵代表模型的权重。这些是训练得到的值,在推理过程中保持不变。右侧输入矩阵代表模型需要处理的输入 token。每一列可以看作某个 token 的数值表示。要生成一个输出 token,加速器会把权重和输入从内存搬入计算单元,执行一连串矩阵乘法(这里简化为一次运算)。点击播放,跟着下面的流程走一遍:
看起来连续的一次生成,实际上分为两个截然不同的阶段。首先,模型处理整个 prompt(“may the force”),产出第一个回复 token——“be”。然后它逐个生成剩下的回复:“with”和“you”。这两个阶段分别叫 prefill 和 decode,它们的算术强度特征差别很大。
注意 我们的示例只跟随一个请求。在生产环境中,服务器通常会把多个请求合批,一次为多个用户处理一个新 token。这样多个请求可以分摊读取模型权重的工作。但批次越大,每个 decode 步骤的耗时也可能越长。总吞吐量可以上升,而每个用户拿到 token 的速度反而变慢。
Prefill
在 prefill 阶段,整个 prompt 被并行处理。前面我们了解到,矩阵乘法越大,数据复用越多,算术强度就越高。用一个更长的输入 prompt 可以让这一点更明显:
真实场景中的 prompt 可以包含数千甚至数十万个 token。把一个 100 页的 PDF 上传给聊天机器人,本质上就是生成一个需要处理的巨大矩阵计算。
这就是 prefill 算术强度相对较高的原因!它是一次大矩阵运算。
Decode
在 decode 阶段,token 一个接一个地生成。乍看之下,模型似乎每次都要把整个不断增长的序列送进同一个大矩阵乘法。但语言模型用 KV cache 避免了这一点。KV cache 保存了此前 token 计算出的 key 和 value,不必重新计算。随着上下文增长,读取和使用这份缓存的开销也会增加。本文不会展开 KV cache 的全部复杂性,但你可以把矩阵中的灰色部分理解为 token 生成每一步中的缓存数据。结果就是一次小得多的矩阵运算。
得益于缓存,我们无需重新计算先前 token 的键和值。
注意 加速器仍会从内存中读取缓存的键和值,并在注意力计算中使用它们。图中只展示新 token 进入计算,是为了强调先前 token 的键和值是被复用而非重新计算。实际的矩阵运算参见 Hugging Face 的 KV cache 指南。
Prefill 与 Decode 的负载特征不同
无论哪个阶段,模型的全部权重都必须送入计算单元。这意味着可能要搬运数百 GB 乃至数 TB 的数据。无论 prefill 阶段处理的是百万 token 的提示,还是 decode 阶段只处理一个新输入 token,生成一个 token 都得完成这些数据传输。正因如此,尽管 prefill 和 decode 的内存搬运量相近,计算负载却截然不同:
内存搬运 · 算术强度 “在《火焰杯》电影里,卡卡洛夫揭发了谁是食死徒?”“Barty”“Crouch”“Jr.”
共同的调度问题
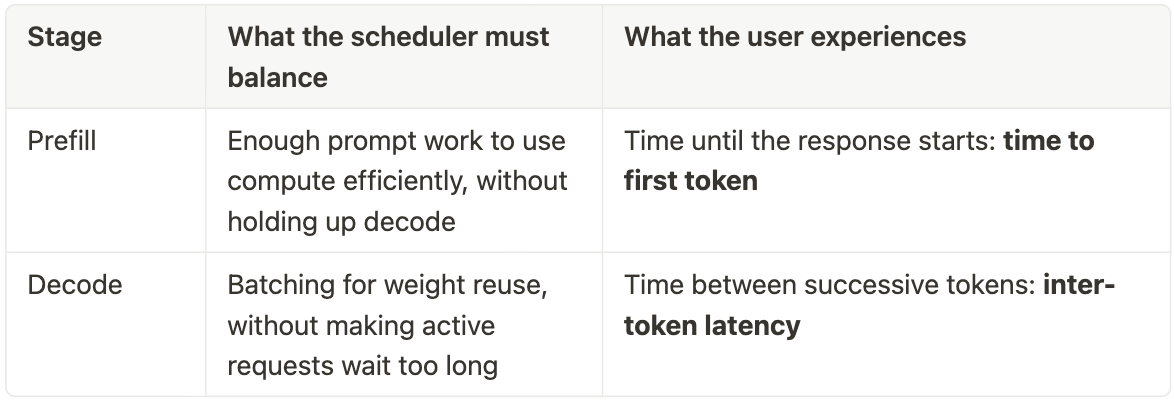
到目前为止,我们只跟踪了单个请求在系统中的流程。但在生产环境中,推理服务器通常要同时处理许多请求。有些请求可能还在 prefill 阶段,另一些已经在 decode 阶段生成 token。当 prefill 和 decode 跑在同一套硬件上时,二者会互相干扰。Prefill 计算密集度极高,可能拖住正在进行的 decode 请求。调度器决定请求如何分配、优先级如何排列。来看看不同调度策略对请求处理的影响:
Prefill · Decode · 首个 token请求 1《星球大战》里那句经典的祝福语是什么?解释它的含义。MaytheForcebewithyou.这是祝愿他人在前路拥有好运、勇气与指引的说法。请求 2用六个词概括这段故事梗概:一群人在暴风雨中丢失了地图,夜里循着星星前行,终于在日出前回到家乡。Thecrewreturnshomebeforesunrise.请求 3为一家每天早上现烤面包的社区小面包店写一句六词标语。Freshbread,warmsmiles,everymorning.时间 →
优先处理 prefill 能让新请求更快开始,但会打断已经在流式输出的用户。优先处理 decode 能让已有响应顺畅流出,但新提示可能要等很久才有第一个响应。这些决策会实实在在影响终端用户体验。在三种模式之间切换,看看每种调度策略如何影响一个聊天机器人:
YouWhat's the classic Star Wars wish for good luck? Explain what it means.Assistant…Waiting for the first token… 0.0 / 40123
聚合式系统——prefill 和 decode 跑在同一批机器上——必须确定哪种结果对其应用更重要:让新请求快速拿到第一个 token,让活跃响应顺畅流出,还是把整体吞吐量做到最大。
分离式架构
先回顾一下目前讲到的内容:
- 加速器(硬件)执行算术运算。过程是把数据从内存搬到计算单元,再把结果写回内存。
- 搬运同样多的数据,不同负载执行的算术量并不相同。
- prefill 和 decode 是推理的两个不同阶段。
- prefill 计算量大,因为它要并行处理多个 token。
- decode 每一步每个请求只处理一个新 token,但仍然需要大量内存访问来读取模型权重和 KV cache。
- 在同一套硬件上平衡这两种负载很困难,规模上去之后必然要做取舍。
分离是一种系统设计模式。它先找出资源需求不同的工作,再把这些负载分开运行,而不是硬让它们共用同一批硬件。分离式系统使用两个独立的硬件池:一个跑 prefill,一个跑 decode。选择“Disaggregated”,看看调度会因此发生什么变化。
Prompt tokens · prefill · Response tokens · decodeRequest 1Request 2Request 3Decode poolPrefill pool 时间 →
在共享池中,首 token 延迟与 token 间延迟直接耦合。启动新 prompt 可能拖慢正在进行的响应;而保护正在进行的响应又会让新 prompt 排队等待。分离架构远不只是“让流式输出更顺滑”。更根本的是,它改变了服务系统的控制接口。
对权衡的掌控更强
在共享池中,容量、批处理和调度决策会同时影响 prefill 和 decode。一旦把两个阶段分开,运维人员就能独立调整各自的部分——按产品需求分配硬件、设定批处理策略、在延迟与吞吐之间取舍。例如,对首 token 延迟有严格要求的系统可以为 prefill 预留更多容量,让新来的 prompt 迅速开始,同时不占用 decode 容量。而优先保证流式体验顺滑的系统,可以给 decode 分配更大或调度更紧凑的池,让正在进行的响应在 prompt 流量激增时依然持续推进。关键在于,这些池可以单独扩缩容。点击不同场景,看看池如何扩缩容以满足不同需求:
Prefill pool · GPU · GPU · GPU · GPU · Decode pool · GPU · GPU · GPU · GPU · Prompt 容量↑ · 并发响应数↑ · TTFT↓ · 端到端延迟↓ · 两个阶段的均衡起点。
可以看到,分离架构让系统能够适应不同的负载形态。但把阶段拆开也带来了新的需求:池与池之间的数据传输。其中最关键的新设计,就是KV cache 的传输。
KV 传输
Prefill 构建好 KV cache 之后,系统会把这份状态传到 decode 池并加载进内存,生成才能继续。模型权重在两个池里本来就已经加载好了,KV cache 不一样,它是每个请求独有的数据。交接会带来额外的网络和协调开销,这也是为什么分离架构在规模足够大时才最有价值:并发任务足够多时,独立配置和调度 prefill 与 decode 带来的收益,可以盖过传输状态和运维两套池子的成本。Prefill 处理完一个 prompt 后,decode 需要 prefill 生成的这份请求专属状态。两个池都已经有模型权重,所以真正要跨过边界的只有 KV cache。下面跟着一个请求走一遍这次交接:
Incoming promptPrefillGPUInput · in memoryMay the force KV cache · Compute · KV transfer DecodeGPUInput · in memory KV cache · Compute · May the force让这个 prompt 依次经过两个池。Prefill 产出 “be”,把 KV cache 和下一个 token 的信息交给 decode。Decode 用 “be” 产出 “with”,再用 “with” 产出 “you”,每处理一个 token 就把它加进 cache。“You” 会在下一轮进入 cache。动画展示的是工作顺序,不是实测的硬件占用。
拆分阶段同样有代价。KV cache 必须在池之间传输,而且只要两个池的容量与需求不匹配,任意一个池都可能空转。延迟还取决于 cache 是在同机架的机器之间传,还是跨区域传。最终,运维方要判断这点额外延迟是否可以接受。
异构分离
前面的例子展示的都是把 prefill 和 decode 拆到两套相同硬件的池子里。引入异构硬件组合后,分离架构的威力更大。问题不再只是该用哪种加速器跑模型,而是哪种加速器组合最适合这份负载。如果每个池都能分配不同的硬件,专用硬件的价值就凸显出来:某种加速器如果在某一个维度上特别强——比如 prompt 处理、内存带宽、token 速度或成本效率——它带来的性能提升可以超过只用一种芯片做分离。Cerebras 的片上聚合内存带宽极高。它的晶圆级架构就是围绕快速访问本地内存设计的,因此特别适合推理中逐 token 生成的那部分。
GPT-oss-120B 高推理强度 · 每秒 10,000 输入 token 输出 token ↑ · Cerebras 每秒 1,669 个输出 tokenSambaNova 每秒 708 个输出 tokenGroq 每秒 475 个输出 tokenMicrosoft Azure 每秒 319 个输出 tokenNebius 每秒 294 个输出 tokenBaseten 每秒 293 个输出 token06001,2001,800Artificial Analysis ↗ · 2026 年 9 月 10 日
为什么有些加速器更擅长 decode?
回想一下 decode 的特殊之处:每产出一个新 token,都要搬运大量数据。它的算术强度相对较低,所以堆更多原始 FLOP 算力并不一定能让 token 来得更快。算力需要靠内存喂进更多数据。在 GPU 上,模型数据主要存放在高带宽内存(HBM)里。计算单元要用这些数据,得先经过更小、更快的片上内存和缓存(包括 SRAM)中转。这种内存层级既提供了大容量,也提供了快速的本地存储,但数据仍然要从共享的外部内存一路走到计算核心。Cerebras 走的是另一条路:它把 SRAM 和计算单元一起分布在整个晶圆上。这样算力就能快速访问附近的存储:
GPU 共享 HBM 为众多计算单元供数WSE 本地 SRAM ↔ 计算单元,位于每个 cell 内部
这种晶圆级设计让 Cerebras 获得了极高的聚合内存带宽:
内存带宽公布峰值 · 每处理器 TB/s ↑ · 片上 SRAM · HBM · Cerebras WSE-3 · 片上 SRAM · 晶圆21,000 TB/s片上 SRAM 加速器 · 片上 SRAM150 TB/sHBM4 GPU 1 · HBM423.3 TB/sHBM4 GPU 2 · HBM422 TB/sHBM3e GPU 1 · HBM3e8 TB/sHBM3e GPU 2 · HBM3e8 TB/sHBM3e GPU 3 · HBM3e8 TB/sHBM 加速器 1 · HBM7.38 TB/sHBM3e 加速器 1 · HBM3e7 TB/sHBM3e 加速器 2 · HBM3e4.9 TB/sHBM3e GPU 4 · HBM3e4.8 TB/s05k10k15k20k25kSRAM 数字是该处理器本地内存带宽的总和;HBM 数字衡量的是片外内存的流量。二者属于不同的内存层级,并非实测的 token 速度。来源与处理器详情 · 2026 年 9 月 10 日精选的领先 AI 加速器,包括新发布的设计以及本文用到的较早硬件。每行对应一个处理器或一片晶圆,而非一台服务器或一个机架。公布峰值未考虑工作负载、内存容量、功耗或价格。Cerebras WSE-3 — 片上 SRAM · 晶圆 ↗片上 SRAM 加速器 — 片上 SRAM ↗HBM4 GPU 1 — HBM4 ↗HBM4 GPU 2 — HBM4 ↗HBM3e GPU 1 — HBM3e ↗HBM3e GPU 2 — HBM3e ↗HBM3e GPU 3 — HBM3e ↗HBM 加速器 1 — HBM ↗HBM3e 加速器 1 — HBM3e ↗HBM3e 加速器 2 — HBM3e ↗HBM3e GPU 4 — HBM3e ↗
分离的目标
同构分离与异构分离带来的是不同的收益。同构系统通常着眼于通过平滑 token 生成来改善响应,异构系统则被优化为从专用硬件中榨取最大价值。就 Cerebras 而言,它提供极高速度的同时不牺牲吞吐量。设想一个由五块 GPU 组成的聚合系统,每块 GPU 把 80% 的执行时间花在 prefill 上,20% 花在 decode 上。一个活跃响应只有在其所在 GPU 执行 decode 步骤时才会推进。把五分之四的时间花在 prefill 上,会拖慢输出 token 生成的平均节奏。
Prefill · Decode共享 GPU 池Prefill 池Decode 池 KV 传输 GPU 1 · GPU 2 · GPU 3 · GPU 4 · GPU 5 · 提示词响应示意性假设示意性的 prefill/decode 交替执行,decode 步骤为 10 ms,传输开销可忽略。总请求吞吐量相同:流经单块 decode GPU 的流量为其 5 倍,响应完成速度快 5 倍,同时其活跃批大小保持不变。
在这五块 GPU 中,decode 占用的执行时间相当于一块 GPU 的量。在这个理想化的稳态下,分离把这份工作交给一块专用 GPU,把 prefill 交给其余四块。decode GPU 无需与 prefill 竞争即可推进响应,在 GPU 数量不变的情况下改善 token 节奏。共享 GPU 花在 prefill 上的时间越多,改善幅度就越大。如果 GPU 本来就把大部分时间花在 decode 上,同构系统中可消除的干扰就更少。但减少干扰只是分离的理由之一。在异构系统中,分离是为了更好地实现硬件专用化。假设五块 Cerebras WSE 目前同时承担两个阶段。把 prefill 移到单独的加速器池后,晶圆便能专注于 decode——在那里,它们的算力最有价值。
Prefill · Decode 共享晶圆池新增 prefill 池Decode 池 KV 传输 HW A HW B HW C WSE 1 · WSE 2 · WSE 3 · WSE 4 · WSE 5 · 提示词响应示意性假设示意性的 75% prefill / 25% decode 初始分配,并非基准测试。只有当 prefill、KV 传输和需求都跟得上时,回收的 decode 时间才能转化为输出容量。Prefill 池的规模仅为示意。
这是每块 WSE 吞吐量的提升,靠额外的 prefill 硬件实现。Agentic 应用与异构解耦天然契合。这类应用往往涉及多轮的长工作流,上下文在多次模型调用之间不断增长。随着 agent 承担的任务更长、后果更重,每一步的延迟都会累积。推理速度因此变得关键,它决定了 agent 用起来是否跟手,以及任务完成得有多快。Cerebras 解耦让推理扩容不再以牺牲顶级交互性为代价。
Cerebras 用解耦实现超高速 token 的扩容
对超高速生成的需求正在快速上升。随着越来越多应用转向 agentic,瓶颈已不只是模型的总容量,而是我们同一时间能向用户交付多少高速 token。在 Cerebras,我们正在构建异构推理系统来满足这一需求。目标不只是提高总吞吐量——而是在扩大推理规模的同时,保住那种让应用感觉即时的超高速 token 速度。在传统的聚合式系统里,提升容量意味着部署更多硬件。通过借助合作方的加速器来处理 prompt 处理,我们在早期测试中用相同的 WSE 占用把容量提升了 5 倍。我们已宣布与多家硬件伙伴达成合作,把更多超高速 token 推向市场,这体现了我们的判断:异构硬件将成为未来推理策略的核心。
预填充选项 · 提示词 KV 传输 Cerebras 解码池 · 响应
下一步
在接下来的文章中,我们将深入探讨如何将异构解耦推理落地到生产环境。我们会拆解其中涉及的硬件与软件栈,以及大规模部署解耦推理在经济上的取舍。关注我们的 X,下一篇发布时即可收到通知!