GitHub のシークレット検出モデル:ノイズを減らし、より多くのシークレットを見つける
GitHub はリモート LLM のシークレットスキャナーを、微調整した ModernBERT 分類器に置き換えた。候補と周辺コードをまとめて読んで判断する方式で、受理率は 11.5% 上がり、スキャン時間の中央値は 86% 短くなった。
日本語
コピー
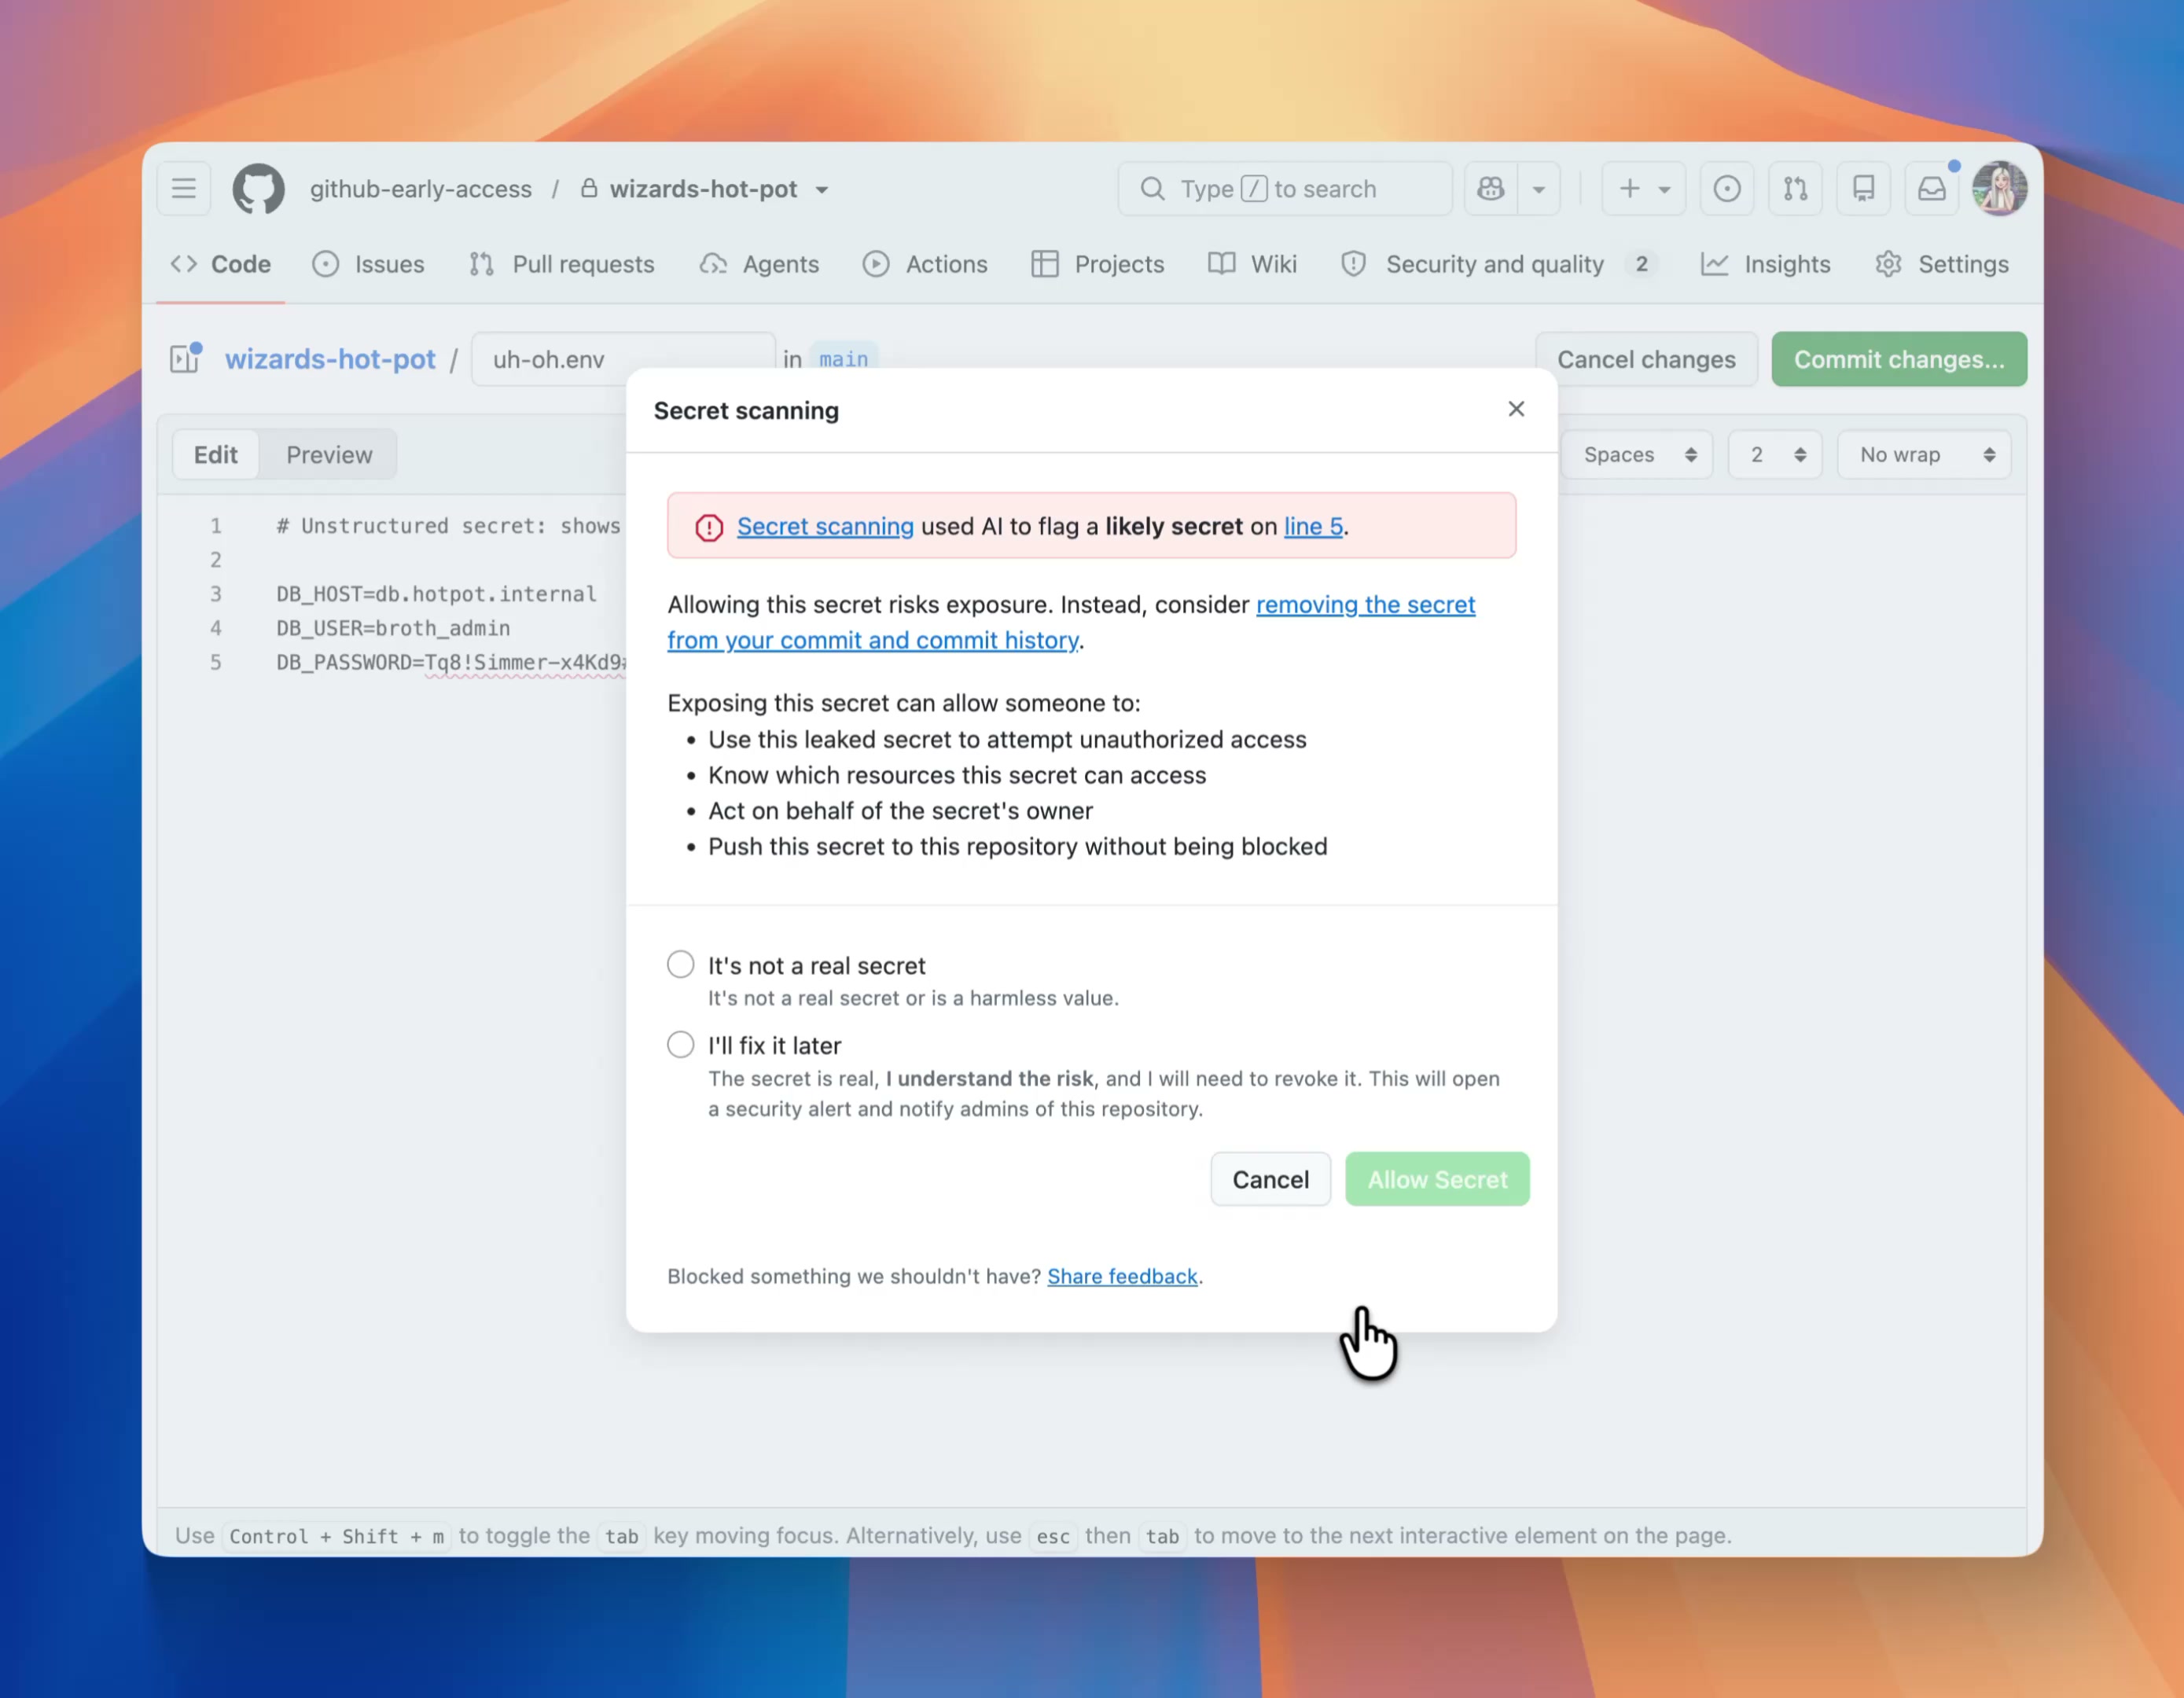
より賢いシークレットスキャン、コストはほんの一部
-
受容率が 11.5% 向上——リポジトリオーナーで重み付けしたアラート精度
-
スキャン実行時間の中央値が 86% 削減——プッシュ後のスキャン
-
サービスコストが 98% 削減——コンパクトモデルとリモート LLM 呼び出しの比較
シークレットスキャンは、開発者が結果を信頼してこそ最大の効果を発揮する。見逃しが多ければ、本物の認証情報がリポジトリに残ってしまう。アラートが頻繁すぎれば、開発者はシークレットですらない文字列の調査に時間を取られる。
汎用シークレットは特にこのバランスが難しい。同じ文字列が本物の認証情報にも、ドキュメント内のプレースホルダーにもなりうる。それがどちらなのかを判断するには、周囲のコードやテキストを理解する必要がある。
この問題を解決するため、私たちは GitHub の製品要件に特化したシークレット分類器を訓練した。本物の認証情報と認証情報に似た文字列を区別しつつ、大規模スキャンに求められる速度と効率を満たすものだ。
姉妹記事「シークレット保護はソフトウェアの規模に追いつかなければならない」では、AI によって加速する開発のペースにシークレット保護がなぜ追随しなければならないかを説明した。本記事では舞台裏に入り、この取り組みを支える文脈認識型分類器——その設計、訓練、評価の方法——を紹介する。ノイズを減らしながら、より多くの本物のシークレットを見つけるために。
何を達成したか
GitHub のシークレットスキャンは 2 つの重要なタイミングで機能する:
- プッシュ保護はプッシュが受け入れられる前に変更をスキャンし、シークレットがリポジトリに入るのを防ぎ、開発者に検出結果へ対処する機会を与える。
- プッシュ後のスキャンはコードがコミットされた後に実行され、リポジトリの内容を継続的にスキャンし、シークレットの可能性を検出するとアラートを作成して、開発者やセキュリティチームが調査・修正できるようにする。
私たちは高速な分類器を開発し、プッシュ後のスキャンの実行時間中央値を、以前の LLM ベースのパイプラインと比べて 86% 削減した。この効率性があって初めて、汎用シークレット検出をプッシュ保護へと拡張できる。コードがコミットされた後だけでなく、開発者が変更をプッシュする前に結果を返せるようになるのだ。
なぜ鍵の検出が難しいのか
構造化されたクレデンシャルには、固有のプレフィックス、長さ、文字セット、チェックサムが付くことが多い。しかし汎用的な鍵には、それらが当てはまらない。構文がビルド ID、チェックサム、リソースハッシュ、サンプル値など、機密ではない文字列と重なり合うのだ。判断を決めるのは文脈である。
| 本物のクレデンシャルである可能性が高い | 無害な似姿である可能性が高い |
|---|---|
| 本番データベースの URL のすぐ隣にあるパスワード | テストフィクスチャにある、同じくパスワードらしき値 |
| デプロイ設定内の接続文字列 | インストールガイドにある localhost の接続文字列 |
| API クレデンシャルに紐づく高エントロピー値 | 高エントロピーのチェックサム、ビルド ID、リソースハッシュ |
これらは難負例だ。クレデンシャルのパターンには一致するが、使えるクレデンシャルではない文字列。ルールを足せば一部は潰せるが、例外を一つ加えるたびに本物の鍵まで隠してしまう恐れがある。学習型の分類器なら、ファイルパス、鍵の種類、変数名、近傍のコードやテキストといったシグナルを利用して判断できる。
そこで登場したのが、2 段階パイプラインを採用した新しいスキャナだ。
- 候補生成:正規表現でフィルタリングしながら、高い再現率でコンテンツ内の潜在的な鍵を走査する。この段階では、できるだけ多くのクレデンシャル系パターンを高速かつ確実にカバーすることを狙う。
- 文脈を考慮した分類:微調整済みの ModernBERT 分類器が各候補とその文脈を評価する。プレースホルダー値、サンプル、ドキュメントの断片、生成されたコンテンツ、機密でない識別子など、本物の鍵と誤検知を分けるシグナルを学習する。モデルは小さく、自社の推論基盤上で効率よく動くため、LLM ベースのパイプラインよりはるかに低コストで運用でき、スケールも容易だ。
効果:
- ユーザーの採用率が 11.5% 向上し、誤検知が減少。
- push 後の鍵検出の実行時間が 86% 短縮。
- LLM ベースのパイプラインと比べてコストを 98% 以上削減。
パイプラインの仕組み
コンテンツを走査するとき、まず正規表現パターンが大きく網を張り、クレデンシャルらしく見えるものをすべて洗い出す。本物の鍵を最初の段階で取りこぼさないためだ。各候補は微調整済みの ModernBERT 分類器に渡され、ファイルパス、変数名、周辺のコードを踏まえてその値を読み、本物の鍵である確率を見積もる。確度の高い結果だけがアラートになり、プレースホルダー、テストフィクスチャ、チェックサムといった似姿は開発者の手元に届く前に除外される。
重要な設計上の選択は、モデルが決定論的スキャンを置き換えるのではなく補完するという点にある。候補文字列を高速に探す道具としては、正規表現が依然として適している。分類器は、機械学習が最も力を発揮する場面、つまり「鍵に見えるもの」と「鍵である可能性が高いもの」の区別に使う。
困難な負例という難題:本物の鍵に見える秘密
誤検知の多くはランダムに発生するのではなく、困難な負例、つまり資格情報のパターンには一致するものの有効な鍵ではない文字列から生じる。たとえばドキュメントのプレースホルダー、テスト用の玩具的なサンプル、マスク処理された値、機密性のない ID、生成されたテストフィクスチャなどだ。こうしたサンプルは正規表現に簡単に引っかかる一方、純粋なルールベースのシステムでは、本物の鍵を傷つけずに除外するのが難しい。
ここで ModernBERT が役に立つ。候補文字列を周辺のコードやテキストとまとめて読み込めるため、LLM に匹敵する文脈理解を得ながら、自然言語の出力を生成する際の遅延と計算コストを避けられる。たとえば候補文字列の周囲に「example」「dummy」「fake」「replace-me」といった語があれば、デプロイ用ファイル内で環境変数に代入された候補文字列よりもリスクが低い可能性がある。分類器はこうした文脈の違いをラベル付きサンプルから学習し、エンジニアが例外を一つひとつ新しいルールとして書き下す必要はない。
ModernBERT を選んだのは、この種のワークロードに非常によく合っているからだ。小さく、効率がよく、コード周辺のテキストの分類に適している。秘密のスキャンに使う場合、モデルは非常に短い候補ウィンドウ上で較正の取れた判断を下しつつ、高いスループットと低い遅延を維持する必要がある。
したがってパイプラインのこの段階では、汎用 LLM よりもファインチューニングしたエンコーダ分類器のほうが適したサービング形態だ。モデルは私たちの意思決定境界に直接合わせて訓練でき、秘密スキャンの品質に本当に関係する再現率と適合率の指標で評価できる。
どのように訓練したか
難しいのは、文法そのものが誤解を招くときに、代表的なデータを見つけることだ。訓練と評価の戦略は三つのソースを組み合わせている。
- GitHub リポジトリ由来のプロダクト派生サンプル。秘密検出の体験から得たフィードバックを活用し、追加の人手による検証を加えている。
- GitHub リポジトリのデータからの高再現率な正規表現候補。人手でラベル付けしたサンプルと、カバレッジを広げるための弱ラベルを含む。
- 疎で困難なシナリオ向けに構築した合成サンプル。たとえばドキュメント内の鍵、テストフィクスチャ、公開鍵、チェックサム、構造が似た模造文字列、近似ヒットのペアなど。
合成行は取り込む前に、決定論的な検証とモデルベースの品質審査を通す。訓練では本物の鍵、現実に近い誤検知、そして純粋な正規表現の手法がよく誤判定する困難な負例に重点を置く。各モデル入力には候補値、ファイルパス、鍵の種類、そして上限付きの文脈を含める。私たちはオフライン評価で閾値を選び、その後、より広い範囲で本番投入する前に、本番に近いトラフィックで挙動を検証する。
データを分割する前に、リポジトリ、候補値、またはサンプルの単位で行をグループ化し、近似した重複サンプルが訓練セットと評価セットの両方に現れないようにする。
訓練はアラートの品質に最も大きく影響するいくつかのケースに焦点を当てる。本物の鍵、現実に近い誤検知、そして正規表現がよく引っかかる困難な負例だ。入力表現には候補の鍵文字列、ファイルパス、種類、そして上限付きの文脈を含める。出力は分類スコアで、スキャナはこれに基づいてその候補を先へ進めるべきか判断する。
私たちはプロダクトレベルのトレードオフを中心に最適化する。再現率を維持または向上させながら、誤検知とサービングコストを下げる。実際には、まずオフライン評価で分類器の閾値を選び、本番投入前に本番に近いトラフィックで検証する。
最も重要な訓練原則は、モデルに紛らわしいサンプルを見せることだ。文法上は本物の鍵に似ているが意味が異なる候補を取り込むことで、モデルは鍵がどんな見た目かを学ぶだけでなく、誤検知が文脈の中でどんな見た目かを学ぶ。
訓練済みモデルは ONNX 形式でエクスポートし、8 ビット量子化を施すことで高速な推論を実現している。
評価結果
| オンライン結果 | 以前の LLM パイプラインとの比較 | 何を測っているか |
|---|---|---|
| リポジトリ所有者で重み付けした承認率 | 11.5% 高い | 顧客が検出結果を承認する度合い |
| push 後スキャンの実行時間の中央値 | 86% 低い | 本番環境でのスキャン実行時間 |
| サービングコスト | 98% 以上低い | コンパクトな分類器とリモート LLM 呼び出しのコスト差 |
顧客 A/B 評価の結果:ファインチューニングしたモデルと以前の LLM パイプラインの比較。
新しいパイプラインが本番環境でどう機能するかを二段階で評価した。まず同じ公開トラフィックのバッチで本番ベースラインと比較し、次に顧客 A/B 実験で検証した。
- オフライン評価: push 後スキャンにおいて、新しいパイプラインは同じ公開トラフィックのバッチで適合率 13% 向上、再現率 19% 向上という結果だった。比較対象は以前の LLM パイプラインだ。
- オンライン評価: その後 A/B 実験で以前の LLM パイプラインと比較し、これらの品質向上が顧客側の実際の利益につながるかを検証した。リポジトリ所有者で重み付けした承認率は 11.5% 向上した。 リポジトリ所有者で重み付けしたのは、大量のアラートを一度にまとめて処理する顧客の影響を弱めるためだ。そうしないと単純平均がそうした行為に引っ張られる。
重要なポイント
最高のセキュリティツールとは、開発者が進んで使うものだ。適合率が高ければ邪魔なアラートが減り、再現率が高ければより多くの本物の鍵を捕まえられ、コストが低ければスキャンが高すぎて手が出ないという事態を招かずにカバレッジを広げ続けられる。
開発者とセキュリティチームにとっては、誤検知が減り、鍵が最も現れやすい場所、つまりコミット、プルリクエスト、日々の開発フローでより速いフィードバックが得られるはずだ。
ハイブリッドシステムは強力だ。Regex は速度、透明性、広い候補カバレッジをもたらし、ModernBERT は学習した文脈理解と誤検知の削減をもたらす。このプロダクトの制約の下では、両者を組み合わせたほうがどちらか単独よりも優れている。
モデルサイズはモデルの有用性とイコールではない、というのも私たちの認識だ。タスクが十分に狭く、決定境界が測定可能で、サービング効率が重視されるなら、小さなファインチューニング済み分類器のほうが正解かもしれない。
これはシークレットスキャンをより正確に、よりスケールしやすく、より使いやすくするための一歩にすぎない。次は2つの方向に注力する。
- 継続的に改善するフライホイールを構築する。本番環境のフィードバックループで新たな偽陰性と偽陽性を見つけ、実環境のシグナルをより高品質な学習データと評価データに変える。
- 新しいモデルアーキテクチャを探る。シークレットの検出と抽出を単一ステップで完了させる手法を研究中で、精度と規模を維持しながらパイプラインの複雑さを下げる。
謝辞
新しいシークレットスキャナの学習データ、評価スイート、サービングスタック、ローンチ計画を支えてくれた GitHub と Microsoft の各エンジニアリング、サイエンス、プロダクトチームに心から感謝する。