GitHub 的密钥检测模型:用更少的噪声找出更多密钥
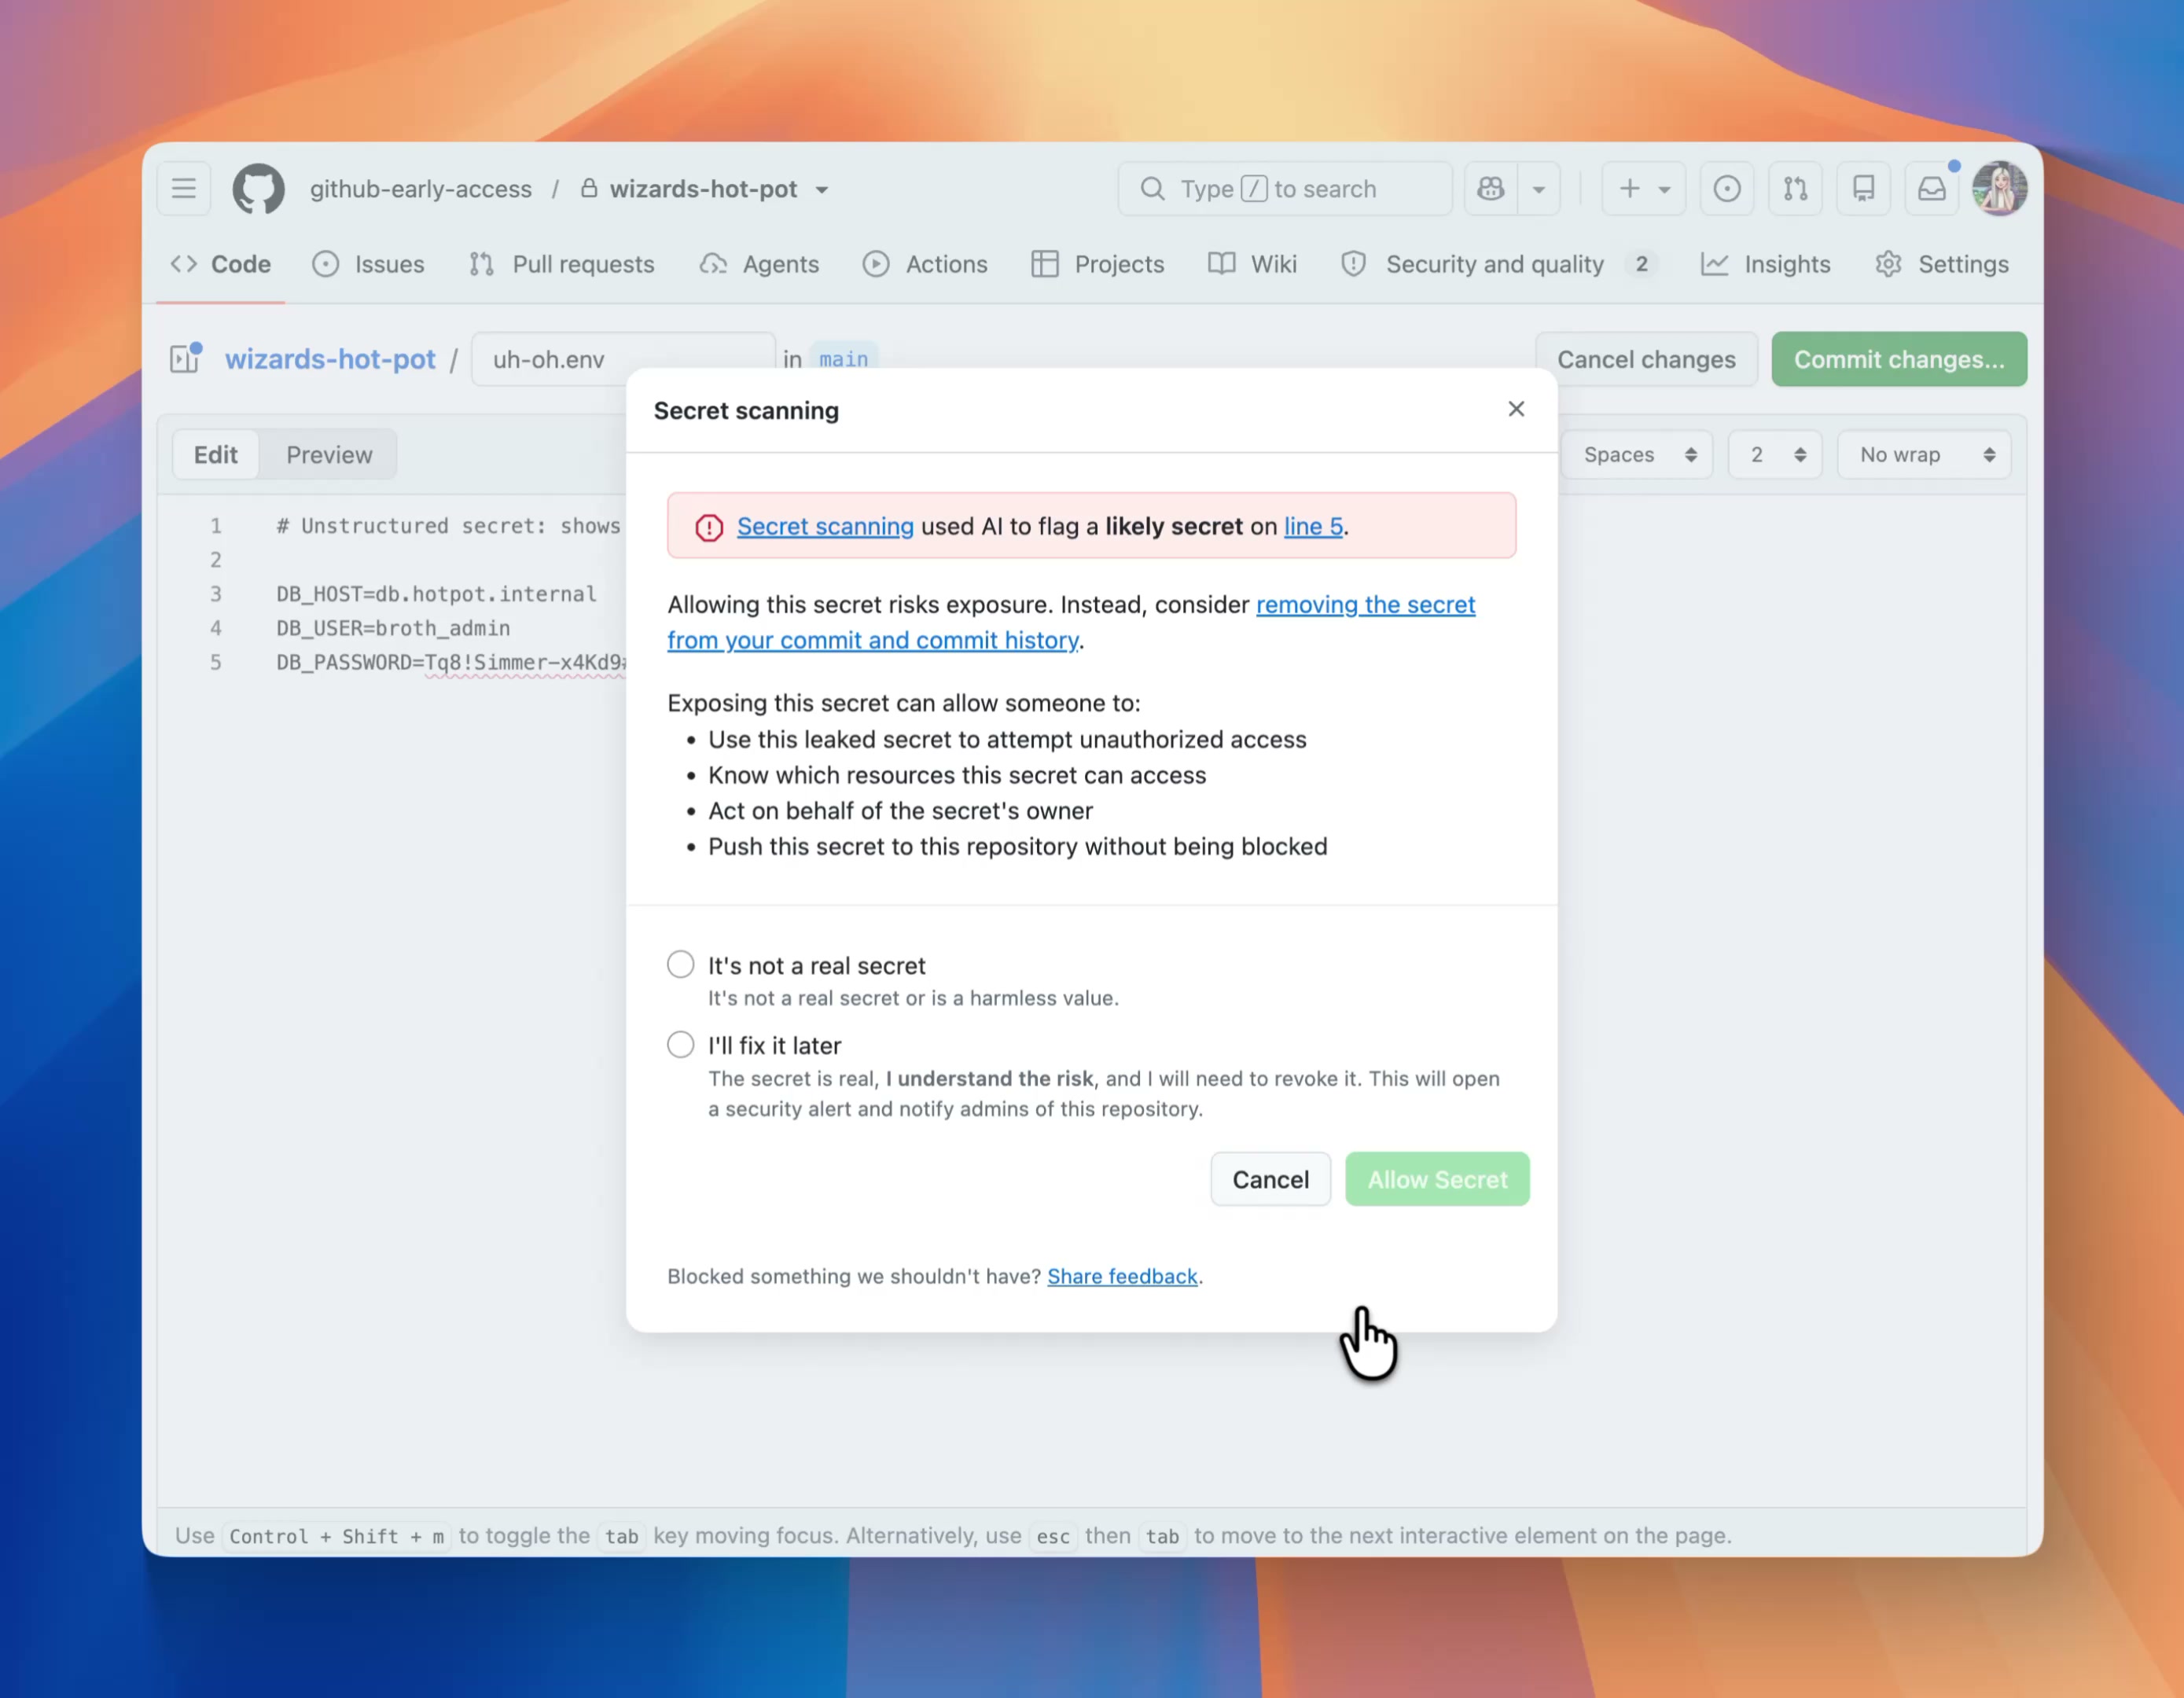
GitHub 用微调过的 ModernBERT 分类器换掉了远程 LLM 密钥扫描器。这个分类器会连候选内容和它周边的代码一起读,接受率提高 11.5%,扫描耗时中位数缩短 86%。
中文
复制
更智能的密钥扫描,成本仅为原来的一小部分
-
接受率提高 11.5%——按仓库所有者加权的告警精确率
-
扫描执行时间中位数降低 86%——推送后扫描
-
服务成本降低 98%——紧凑模型对比远程 LLM 调用
只有当开发者信任扫描结果时,密钥扫描才能发挥最大作用。漏报太多,真实凭据就可能留在仓库里;告警太频繁,开发者又要花时间排查那些根本不是密钥的字符串。
通用密钥尤其难以平衡。同一个字符串,可能是真实凭据,也可能是文档里的占位符,要判断它究竟是什么,就得理解周围的代码和文本。
为了解决这个问题,我们专门针对 GitHub 的产品需求训练了一个密钥分类器:既能区分真实凭据和形似凭据的字符串,又能满足大规模扫描对速度和效率的要求。
在配套文章《密钥保护必须跟上软件的规模》中,我们解释了为什么密钥保护必须跟上 AI 加速的开发节奏。本文则深入幕后,介绍支撑这项工作的上下文感知分类器:我们如何设计、训练和评估它,从而以更少的噪声找出更多真实密钥。
我们实现了什么
GitHub 密钥扫描在两个关键节点发挥作用:
- 推送保护在推送被接受之前扫描变更,阻止密钥进入仓库,让开发者有机会处理发现的问题。
- 推送后扫描在代码提交之后运行,持续扫描仓库内容,一旦检测到可能的密钥就创建告警,供开发者和安全团队调查和修复。
我们开发了一个快速分类器,将推送后扫描的执行时间中位数相比此前基于 LLM 的流水线降低了 86%。正是这样的效率,让通用密钥检测得以扩展到推送保护:在开发者推送变更之前就返回结果,而不只是在代码提交之后。
为什么密钥难以检测
结构化凭证通常带有独特的前缀、长度、字符集或校验和,通用密钥则未必如此。它们的语法与构建 ID、校验和、资源哈希、示例值以及其他非敏感字符串相互重叠。判断的关键在于上下文。
| 很可能是真实凭证 | 很可能是无害的形似值 |
|---|---|
| 紧挨着生产数据库 URL 出现的密码 | 测试夹具中同样形如密码的值 |
| 部署配置中的连接字符串 | 安装指南中的 localhost 连接字符串 |
| 绑定到 API 凭证的高熵值 | 高熵的校验和、构建 ID 或资源哈希 |
这些是难负样本:匹配凭证模式,却并非可用凭证的字符串。增加规则可以压掉其中一部分,但每加一条例外,都可能把真实密钥一并藏起来。学习型分类器则可以利用文件路径、密钥类型、变量名以及邻近代码或文本等信号来判断。
正因如此,我们上线了采用两阶段流水线的新扫描器:
- 候选生成:用正则过滤以高召回率扫描内容中的潜在密钥。这一阶段追求快速、确定地覆盖尽可能多的凭证类模式。
- 上下文感知分类:由微调过的 ModernBERT 分类器评估每个候选及其上下文。它学会识别区分真实密钥与误报的信号,包括占位值、示例、文档片段、生成内容和非敏感标识符。模型体积小,在我们的推理基础设施上运行高效,因此服务成本远低于基于 LLM 的流水线,扩展也更简单。
效果:
- 用户采纳率提升 11.5%,误报减少。
- push 后密钥检测的执行时间缩短 86%。
- 相比基于 LLM 的流水线,成本节省超过 98%。
流水线如何工作
扫描内容时,正则模式先撒下一张大网,凡是看起来像凭证的都标记出来,确保真实密钥在第一步不会被漏掉。每个候选随后交给微调过的 ModernBERT 分类器,由它结合文件路径、变量名和周边代码来读取该值,估计它是真实密钥的可能性。高置信度的结果生成告警,而占位符、测试夹具、校验和这类形似值则在到达开发者之前就被过滤掉。
重要的设计选择在于,模型并不取代确定性扫描,而是作为其补充。正则表达式仍然是快速查找候选字符串的合适工具。分类器则用在机器学习最能发挥优势的地方:区分“看起来像密钥”和“很可能是真密钥”。
困难负样本的难题:那些看似真密钥的秘密
大多数误报并非随机出现,而是困难负样本:它们符合凭据模式,却并非有效密钥。例如文档占位符、测试中的玩具示例、打码后的值、非敏感 ID,以及生成的测试夹具。这类样本很容易被正则表达式匹配到,而纯规则系统很难在不误伤真实密钥的前提下将其排除。
ModernBERT 在这方面能派上用场,因为它可以将候选字符串与附近的代码和文本一并读取,获得与 LLM 相当的上下文理解能力,同时避免生成自然语言输出所带来的延迟和算力开销。例如,当候选字符串周围出现 “example”“dummy”“fake” 或 “replace-me” 等词时,其风险可能低于部署文件中被赋给环境变量的候选字符串。分类器从标注样本中学习这些上下文差异,而无需工程师将每一种例外都写成一条新规则。
我们选择 ModernBERT,是因为它非常契合这类工作负载:体积小、效率高,适合对代码周边文本进行分类。用于密钥扫描时,模型需要在很短的候选窗口上做出校准良好的判断,同时保持高吞吐、低延迟。
因此,在流水线的这一阶段,微调过的编码器分类器比通用 LLM 是更合适的服务形态。模型可以直接在我们的决策边界上训练,并用与密钥扫描质量真正相关的召回率和精确率指标来评估。
我们如何训练
难点在于,当语法本身就具有误导性时,如何找到有代表性的数据。训练和评估策略结合了三个来源:
- 来自 GitHub 仓库的产品衍生样本,利用了密钥检测体验中的反馈,并辅以额外的人工验证。
- 来自 GitHub 仓库数据的高召回正则候选,包括人工标注样本和用于扩大覆盖范围的弱标签。
- 针对稀疏和困难场景构造的合成样本,例如文档中的密钥、测试夹具、公钥、校验和、结构相似的仿冒串,以及近似命中对。
合成行在纳入前会经过确定性校验和基于模型的质量审查。训练重点放在真实密钥、贴近实际的误报,以及经常让纯正则方案误判的困难负样本上。每个模型输入包含候选值、文件路径、密钥类型,以及一段有上限的上下文。我们通过离线评估选定阈值,然后在更大范围上线前,用接近生产环境的流量验证其行为。
在切分数据之前,我们先按仓库、候选值或样本对行进行分组,避免近似重复的样本同时出现在训练集和评估集中。
训练聚焦于对告警质量影响最大的几类情况:真实密钥、贴近实际的误报,以及正则经常命中的困难负样本。输入表示包含候选密钥字符串、文件路径、类型,以及一段有上限的上下文。输出是一个分类分数,扫描器据此判断该候选是否应继续处理。
我们围绕产品层面的权衡做优化:在保持或提升召回率的同时,降低误报和服务成本。落到实践中,就是先用离线评估选定分类器阈值,再在上线前用接近生产环境的流量进行验证。
最重要的训练原则是让模型看到那些容易混淆的样本。我们纳入了在语法上与真实密钥相似、但语义上不同的候选,这样模型不仅学会密钥长什么样,也学会误报在上下文中长什么样。
训练好的模型以 ONNX 格式导出,并做 8 位量化,从而实现快速推理。
评估结果
| 线上结果 | 相比此前 LLM 流水线的变化 | 衡量的是什么 |
|---|---|---|
| 按仓库所有者加权的接受率 | 高 11.5% | 客户对检出结果的接受程度 |
| push 后扫描执行时间中位数 | 低 86% | 生产环境中的扫描执行时间 |
| 服务成本 | 低 98% 以上 | 紧凑分类器相比远程 LLM 调用的成本 |
客户 A/B 评估结果:我们的微调模型与之前的 LLM 流水线对比。
我们分两个阶段评估了新流水线在生产环境中的效果:先在同一批公开流量上与生产基线对比,再通过客户 A/B 实验验证。
- 离线评估: 在推送后扫描中,新流水线在同一批公开流量上的评估结果为精确率提升 13%、召回率提升 19%,对比对象是之前的 LLM 流水线。
- 在线评估: 随后我们通过 A/B 实验对照之前的 LLM 流水线,验证这些质量提升是否转化为客户侧的实际收益。按仓库所有者加权的接受率提升了 11.5%。 我们按仓库所有者加权,是为了削弱那些一次性批量处理大量告警的客户的影响——否则简单平均会被这类行为拉偏。
关键要点
最好的安全工具,是开发者愿意用的那个。精确率更高,意味着干扰性告警更少;召回率更高,意味着更多真实密钥被捕获;成本更低,意味着我们可以持续扩大覆盖范围,而不至于让扫描贵到无法承受。
对开发者和安全团队来说,这应当体现为更少的误报,以及在密钥最可能出现的地方获得更快的反馈:提交、拉取请求,以及日常开发流程。
混合系统很强大。Regex 带来速度、透明度和广泛的候选覆盖;ModernBERT 带来学到的上下文理解能力和误报削减。在这一产品的约束条件下,两者结合优于任何单一方案。
我们还认识到,模型大小不等于模型有用。当任务足够窄、决策边界可度量、服务效率又至关重要时,一个更小的微调分类器可能就是正确答案。
这只是让密钥扫描更准确、更可扩展、更易用的一步。接下来,我们聚焦两个方向:
- 构建持续改进的飞轮。我们利用生产环境中的反馈闭环发现新的漏报和误报,将真实场景中的信号转化为更高质量的训练与评估数据。
- 探索新的模型架构。我们正在研究能够在单步内完成密钥检测与提取的方案,在保持准确率和规模的同时降低流水线复杂度。
致谢
衷心感谢 GitHub 和 Microsoft 各工程、科学与产品团队,他们为这款新密钥扫描器的训练数据、评估套件、服务栈和上线方案提供了支持。