SAIL:反復的精錬によるテスト時スケーリングで、ロボット軌道生成器としての視覚言語モデルを実現
SAIL は基礎モデルに再構成した場景の中で軌道を探索させ、その結果を実機のロボットに実行させる。モデルの更新は不要。3 つの限界と直接推論との比較も書かれている。
日本語
コピー
シミュレーションで軌道最適化を終えた後の実機実行。 SAIL は再構成したシーンで候補軌道を評価・改善し、選ばれた軌道をロボット上で実行する。
基盤モデルでロボットを制御する
ロボットに新しいタスクを覚えさせるには、まず何を用意すればよいのか。よくある方法は、デモデータを集め、そこから得た軌道でポリシーを訓練するというものだ。しかし基盤モデルは、画像、動画、コード、言語、そしてロボット関連のデータからすでに何かを学んでいる。ならば問いはこうなる。モデルの重みを更新せずに、そこからロボット制御に使える知識をどれだけ引き出せるのか。
実際、GPT-6 Astra は言語と視覚の汎用的な能力に加えて、実機ロボットで多様な操作タスクをこなす能力を示している。カメラ画像とロボットの状態から運動目標を指定するのだ [Robocurve, 2026]。さらに早い段階の研究では、トークン化した視覚観測と少数のデモを使い、言語モデルの文脈内学習によって軌道を生成した [Di Palo and Johns, 2024]。下図は VLM や LLM で直接軌道を生成する流れを示している。
コンテキスト
+
観測 軌道
プロンプト
ロボットポリシー
VLM/LLM
軌道を1本生成
生成
生成された軌道
e1→e2→…→eT 位置と姿勢 グリッパ状態
VLM や LLM で直接軌道を生成する。 モデルはコンテキストを使って、エンドエフェクタの姿勢列とグリッパ状態を生成する。
基盤モデルが生成する軌道の限界、そして我々の手法(SAIL)
だが基盤モデルが、1回の生成で信頼できるロボット軌道を出せるとは限らない。予測結果は与えられたコンテキスト、たとえばデモデータやそれが現在のシーンにどれだけ関係しているかに左右され、サンプリングによっても変わる。意図した動作が適切であっても、モデルが生成した運動目標にわずかな誤差があれば失敗につながりうる。単一の予測を評価せずに実行するだけでは、ロボットが動く前にこうした誤りを正す機会がない。
言語モデルも似た制約を抱えており、訓練だけが解決策ではない。テスト時スケーリングは重みを更新せず、推論段階で候補となる答えを生成・評価・修正することで精度を高め、単一予測を上回る。計算量と精度のこのトレードオフは、物理的な動作にも当てはまるのだろうか。
我々は SAIL(Scaling In-Context Imitation Learning)を提案する。テスト時スケーリングによって、VLM ベースのロボット軌道生成をより信頼できるものにする手法だ。SAIL はポリシー VLM を使い、コンテキストとして与えられた少数の成功デモから候補軌道を生成する。SAIL はそれらをシミュレーションで実行し、評価 VLM でタスクの進捗を判定してステップ単位のフィードバックを返し、モンテカルロ木探索(MCTS)で軌道の改善を導く。候補軌道のテストはシミュレーション内で完結し、選ばれた軌道だけが実機ロボットに送られる。
次に、推論時の計算量を増やすことでこのフレームワークが成功率をどこまで上げられるかを検証した。シミュレーション上の6つの操作タスクで、探索予算を1ノードから45ノードに増やすと、成功軌道を見つけられる平均割合は25%から73%に上がった。実機ロボットでも SAIL を評価した。すべての実験で、ポリシー VLM と評価 VLM の両方に Gemini Robotics-ER 1.5 を使い、その重みは更新していない。
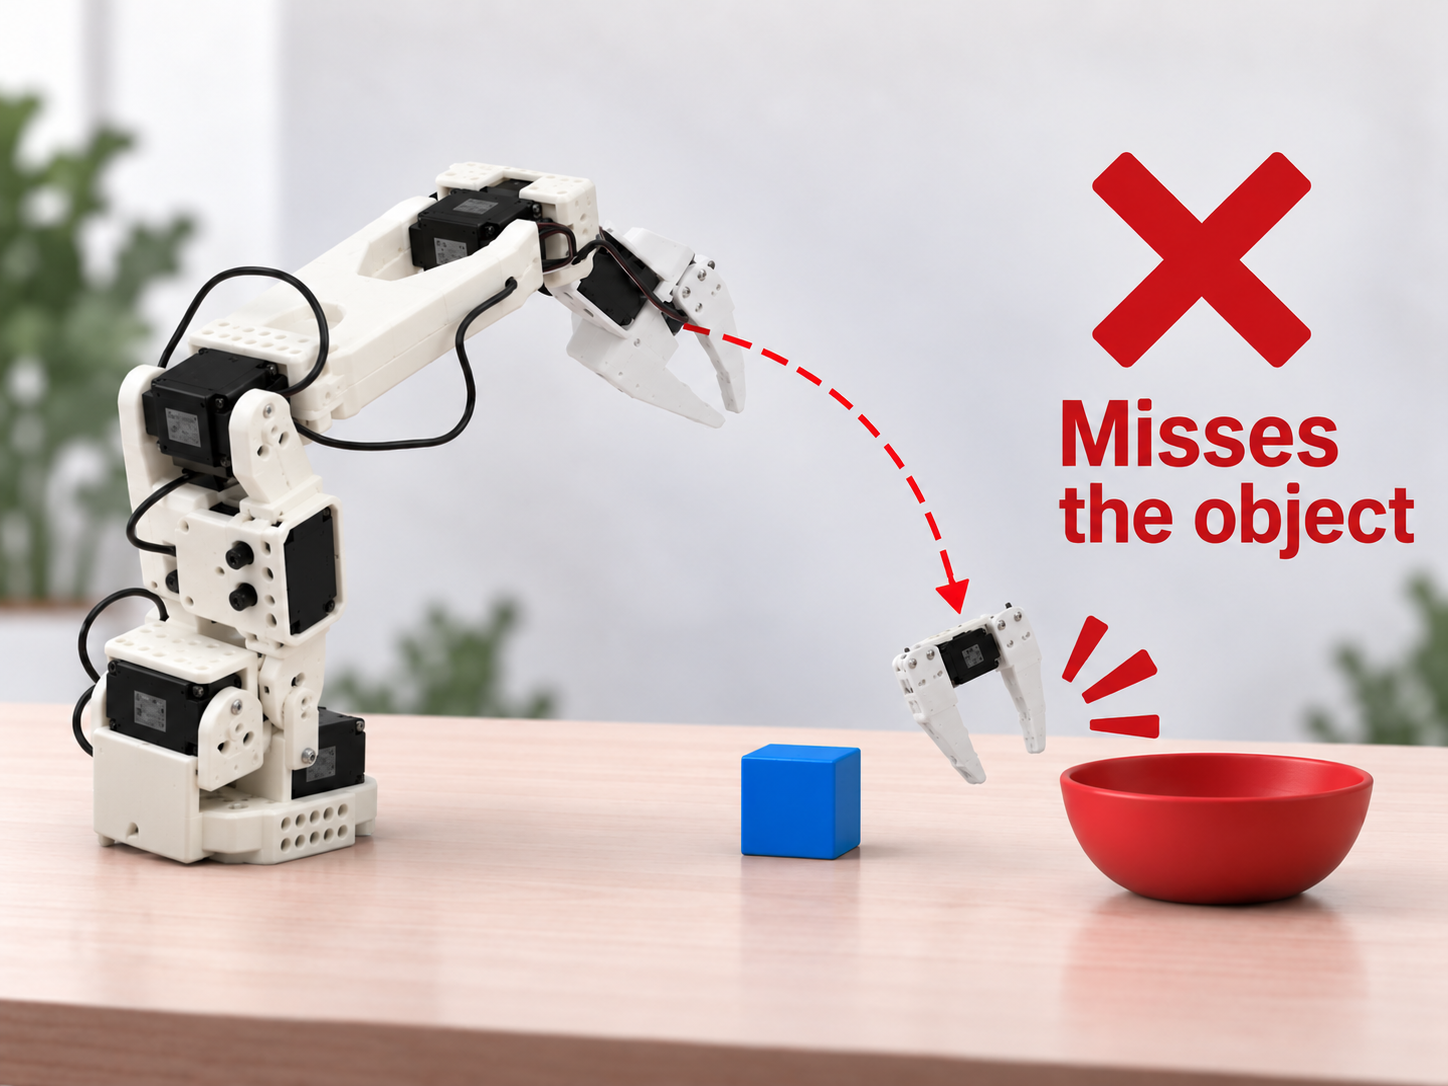
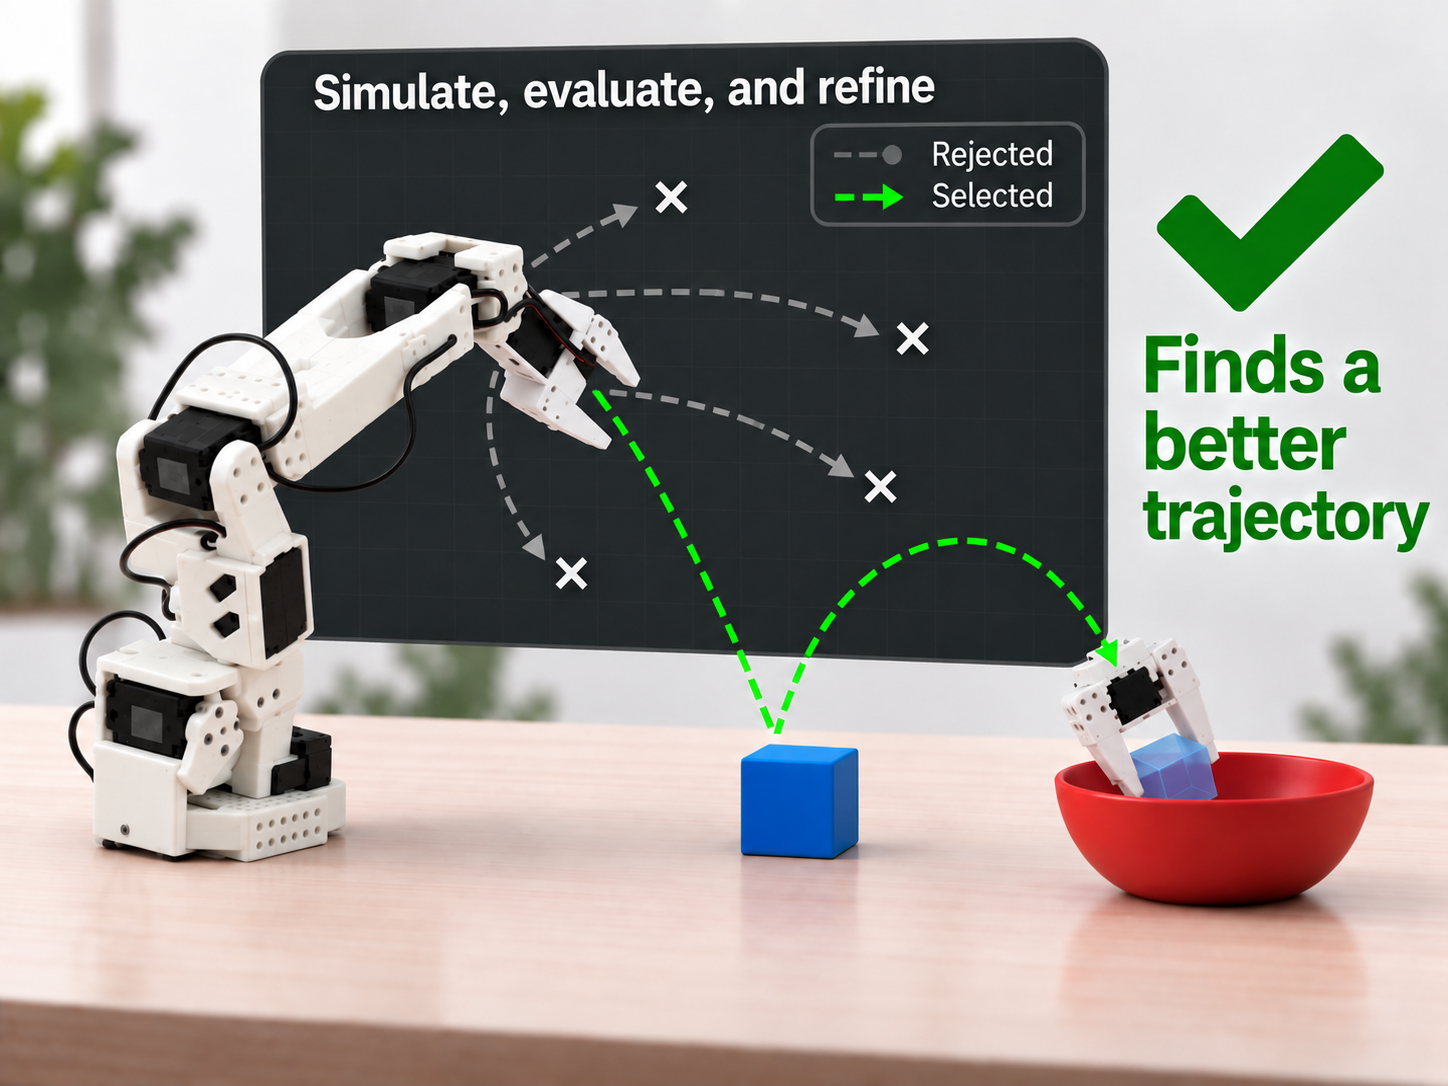
シミュレーションにおける軌道の誤りと改善。 左図は軌道の誤りの一例として把持失敗を示す。右図は候補軌道をシミュレーションで評価・改善する過程を示す。いずれも概念図である。
SAIL はどう軌道を改善するか
SAIL は MCTS を使い、有望な軌道の改善と、その他の可能性の探索を両立させる。探索は3つの要素に依存する。(1) 類似したデモからの生成。 各ノードは1本の完全な軌道を表し、検索されたデモを組み合わせて VLM が文脈内学習で生成する。(2) タスク完了度の評価。 軌道はシミュレーションで実行され、評価 VLM が実行動画からタスクの完了度を見積もる。(3) ステップ単位のフィードバックによる改善。 親軌道は選ばれたランドマーク点に進捗スコアを付けて生成 VLM に渡され、修正された軌道を子ノードとして出力する。各エッジがこうした改善1回分にあたる。

SAIL による軌道改善。 (1) システムがデモンストレーションを検索し、軌道を1本生成する。(2) シミュレーション上の実行結果からタスクの達成度を推定する。(3) 選択した軌道のウェイポイントに紐づけた達成度スコアが、次の改善ラウンドを導く。
1. 類似したデモンストレーションからの生成
アーカイブには成功軌道が蓄積されている。システムは現在のシーンに似たシーンのデモンストレーションを検索する。生成 VLM はそれらを受け取り、現在の物体配置とロボットの状態とあわせて、軌道を1本まるごと生成する。探索中に見つかった成功軌道はアーカイブに追加され、以降のラウンドで使われる。
2. タスク達成度の評価
ステップ1で生成した軌道をシミュレーション上で実行し、実行動画を得る。評価 VLM は、動画の中で定義済みのサブタスクがどこまで進んだかを見て、タスクがどれだけ完了したかを推定する。実行全体にわたる達成度の推定値は1つの軌道スコアにまとめられるため、どちらの候補もタスクを完了していなくても比較できる。この評価は、タスクの進捗を時間方向に採点する ROVER の手法 [Schroeder et al., 2025] に基づいている。
3. ステップ単位のフィードバックによる改善
サンプリングした動画フレームから得た達成度スコアを、選択した軌道のウェイポイントに紐づけて、軌道を生成した VLM に返す。フィードバックは、うまくいった区間を残し、進捗が止まった部分を修正するようモデルに促す。修正後の軌道は子ノードとなり、シミュレーション上で再評価されて以降の探索を導く。
探索予算を増やすと成功率が上がる
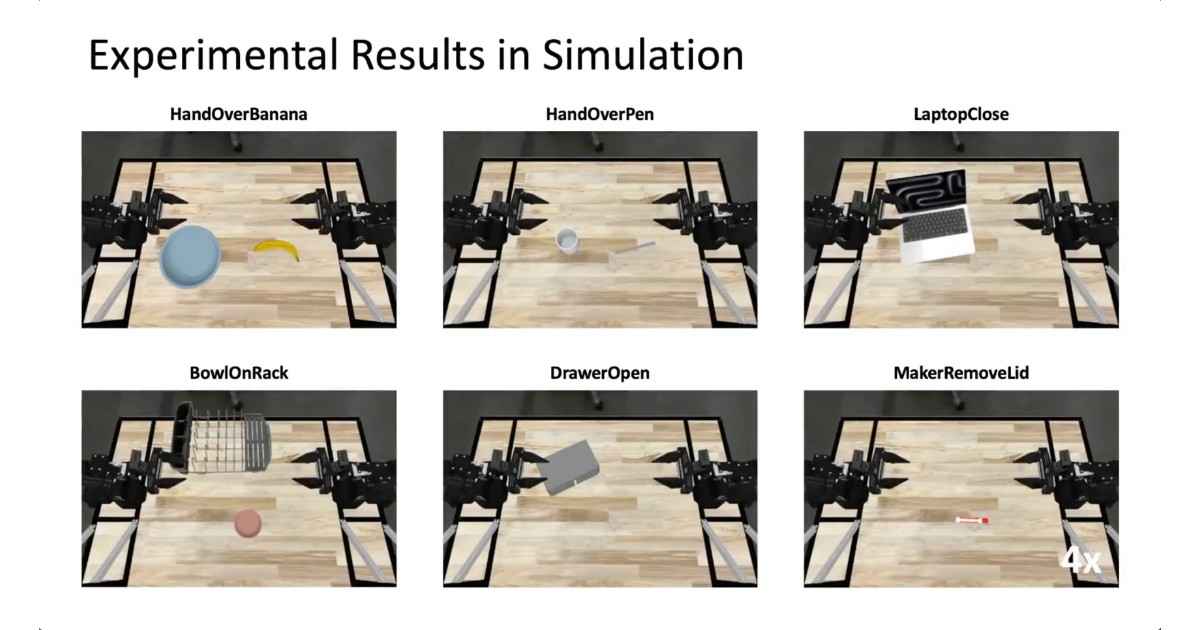
ALOHA シミュレータ上で6つの操作タスクを評価した。各タスクにつき初期配置は20通り。探索予算を増やすと、平均成功率は軌道を1本だけ生成した場合の 25% から、候補軌道45本(探索ノード最大45)の予算で 73% まで上がった。
評価した6タスクのシミュレーション例。
ここでの成功率は、探索予算内で、シミュレータの真値による成功チェックを通過した軌道を探索が見つけた頻度を指す。この二値のチェックは、探索を導くのに使う VLM のタスク達成度推定とは別物である。
表 1. 各タスク20通りの初期配置で成功軌道が見つかった割合(%)

| 手法 | ノード | Banana | Pen | Bowl | Drawer | Laptop | Marker | 平均 | |
|---|---|---|---|---|---|---|---|---|---|
| ベースライン | |||||||||
| 単発生成 | 1 | 40 | 40 | 40 | 10 | 15 | 5 | 25 | |
| 幅優先探索 | 15 | 85 | 50 | 60 | 35 | 60 | 15 | 51 | |
| 深さ優先探索 | 15 | 45 | 50 | 80 | 5 | 30 | 10 | 37 | |
| 提案手法(SAIL) | |||||||||
| 単発生成(再掲) | ノード数 | ||||||||
| 増 | 1 | 40 | 40 | 40 | 10 | 15 | 5 | 25 | 成功率 |
| 向上 | |||||||||
| SAIL | 6 | 80 | 55 | 100 | 20 | 50 | 25 | 55 | |
| SAIL | 15 | 90 | 70 | 100 | 40 | 50 | 40 | 65 | |
| SAIL | 30 | 95 | 80 | 100 | 50 | 55 | 45 | 71 | |
| SAIL | 45 | 95 | 80 | 100 | 50 | 70 | 45 | 73 |
試したどの予算でも平均成功率は向上し、6、15、30、45ノードでそれぞれ 55%、65%、71%、73% に達した。探索と改善によるテスト時スケーリングが実際に効くことを示している。VLM の重みを更新しなくても、推論時の計算量を増やせば成功率が上がる。
シミュレーションから実機実行へ
LeRobot SO-101 アームでのブロック配置タスクを実機で評価した。手法はカラー観測と深度観測からシーンを再構成し、シミュレーション上で成功軌道を探索してからロボット上で実行する。物体位置はランダム化し、候補軌道の予算は15本、6回の試行中5回成功した。残る1回の失敗は、姿勢推定の誤差と、接触ダイナミクスにおけるシミュレーションと実環境の差に起因すると考えている。

ブロックをボウルに入れるタスクのシミュレーション環境と実機環境。
さらに、探索で得た成功軌道は模倣方策の訓練データとしても使える。この方法も6回の試行中5回成功し、報告されている実行時間は MCTS 探索より短かった。
限界と今後の課題
SAIL には主な限界が三つある。第一に、軌道は開ループで実行されるため、動作中に視覚フィードバックが入らない。第二に、シミュレーション上での軌道探索と細分化には追加の計算コストがかかる。第三に、実環境での評価はタスク1件・手法ごとに6試行にとどまっており、より広範な検証が必要だ。
SAIL は、推論の計算資源をシミュレーションフィードバックと反復的な細分化に配分することで、VLM が生成するロボット軌道を改善できることを示した。手法と実験の詳細は論文を参照。