SAIL:通过迭代精炼实现测试时扩展,用于视觉语言模型作为机器人轨迹生成器
SAIL 让基础模型在重建出的场景里先搜索轨迹、再交给实体机器人执行,不用更新模型权重;文章交代了它的三处限制,以及与直接推理的对照。
中文
复制
在仿真中完成轨迹优化后的实体执行。 SAIL 在重建场景中评估并优化候选轨迹,然后在机器人上执行选中的轨迹。
用基础模型控制机器人
要让机器人上手一项新任务,需要先准备什么?常见的做法是收集演示数据,再用得到的轨迹训练策略。但基础模型已经从图像、视频、代码、语言以及机器人相关数据中学到了东西。那么问题就变成:在不更新模型权重的前提下,我们能从中提取多少知识用于机器人控制?
事实上,GPT-6 Astra 除了具备语言和视觉上的通用能力,还展现出在实体机器人上完成多种操作任务的能力——它根据相机图像和机器人状态指定运动目标 [Robocurve, 2026]。更早的工作则用 token 化的视觉观测和少量演示,通过语言模型的上下文学习生成轨迹 [Di Palo and Johns, 2024]。下图展示了用 VLM 或 LLM 直接生成轨迹的过程。
上下文
+
观测 轨迹
提示词
机器人策略
VLM/LLM
生成一条轨迹
生成
生成的轨迹
e1→e2→…→eT 位置与姿态 夹爪状态
用 VLM 或 LLM 直接生成轨迹。 模型利用上下文生成一串末端执行器位姿和夹爪状态。
基础模型生成轨迹的局限,以及我们的方法(SAIL)
但基础模型未必能一次生成就给出可靠的机器人轨迹。预测结果取决于所提供的上下文,比如演示数据以及它们与当前场景的相关程度,也会随采样而变化。即便意图中的动作是合适的,模型生成的运动目标里只要有一点小误差,就可能导致失败。只执行单次预测而不做评估,就没有机会在机器人动作之前纠正这类错误。
语言模型也面临类似的限制,而训练并非唯一的解决途径。测试时扩展无需更新权重,而是在推理阶段生成、评估并修正候选答案,从而提升准确率,使其超过单次预测的水平。我们想知道,计算量与准确率之间的这种权衡是否同样适用于物理动作。
我们提出 SAIL(Scaling In-Context Imitation Learning),一种通过测试时扩展实现更可靠的基于 VLM 的机器人轨迹生成方法。SAIL 使用一个策略 VLM,根据上下文中提供的少量成功演示生成候选轨迹。SAIL 在仿真中执行这些轨迹,用评估 VLM 判断任务进展,并返回步骤级反馈,通过蒙特卡洛树搜索(MCTS)引导轨迹的改进。候选轨迹的测试在仿真中完成,只有被选中的轨迹才会发送给物理机器人。
随后我们测试了这套框架通过增加推理时的计算量能把成功率提升到什么程度。在仿真中的六项操作任务上,将搜索预算从 1 个节点增加到 45 个节点,找到成功轨迹的平均比例从 25% 提升到 73%。我们还在物理机器人上评估了 SAIL。所有实验中,我们都使用 Gemini Robotics-ER 1.5 同时作为策略 VLM 和评估 VLM,且不更新其权重。
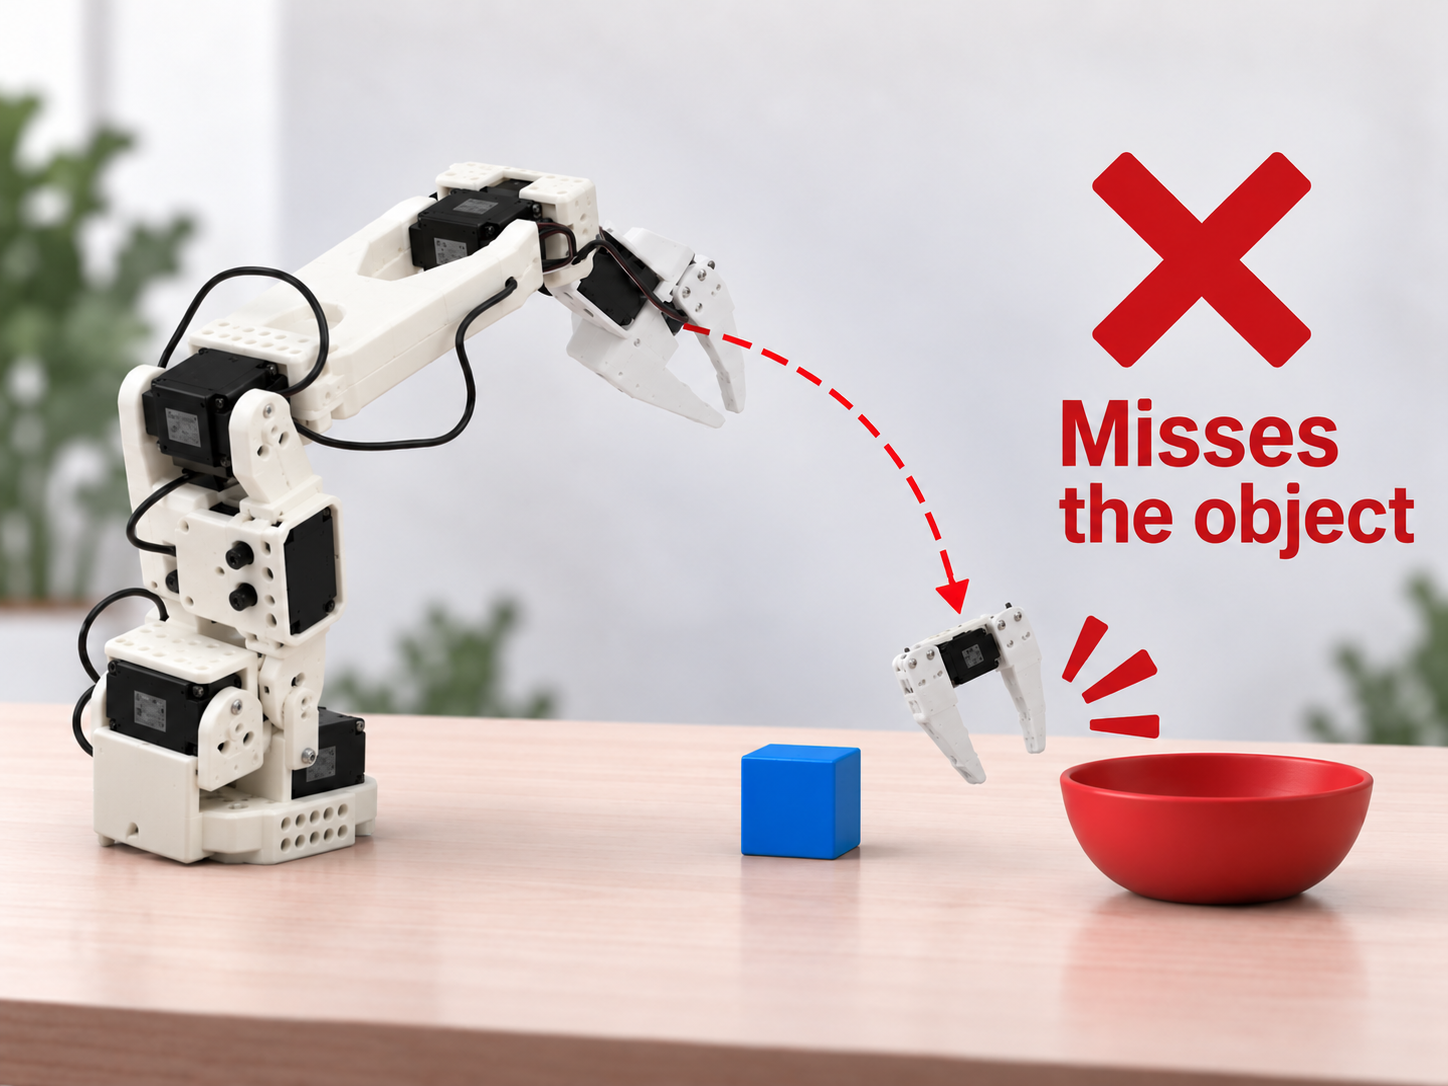
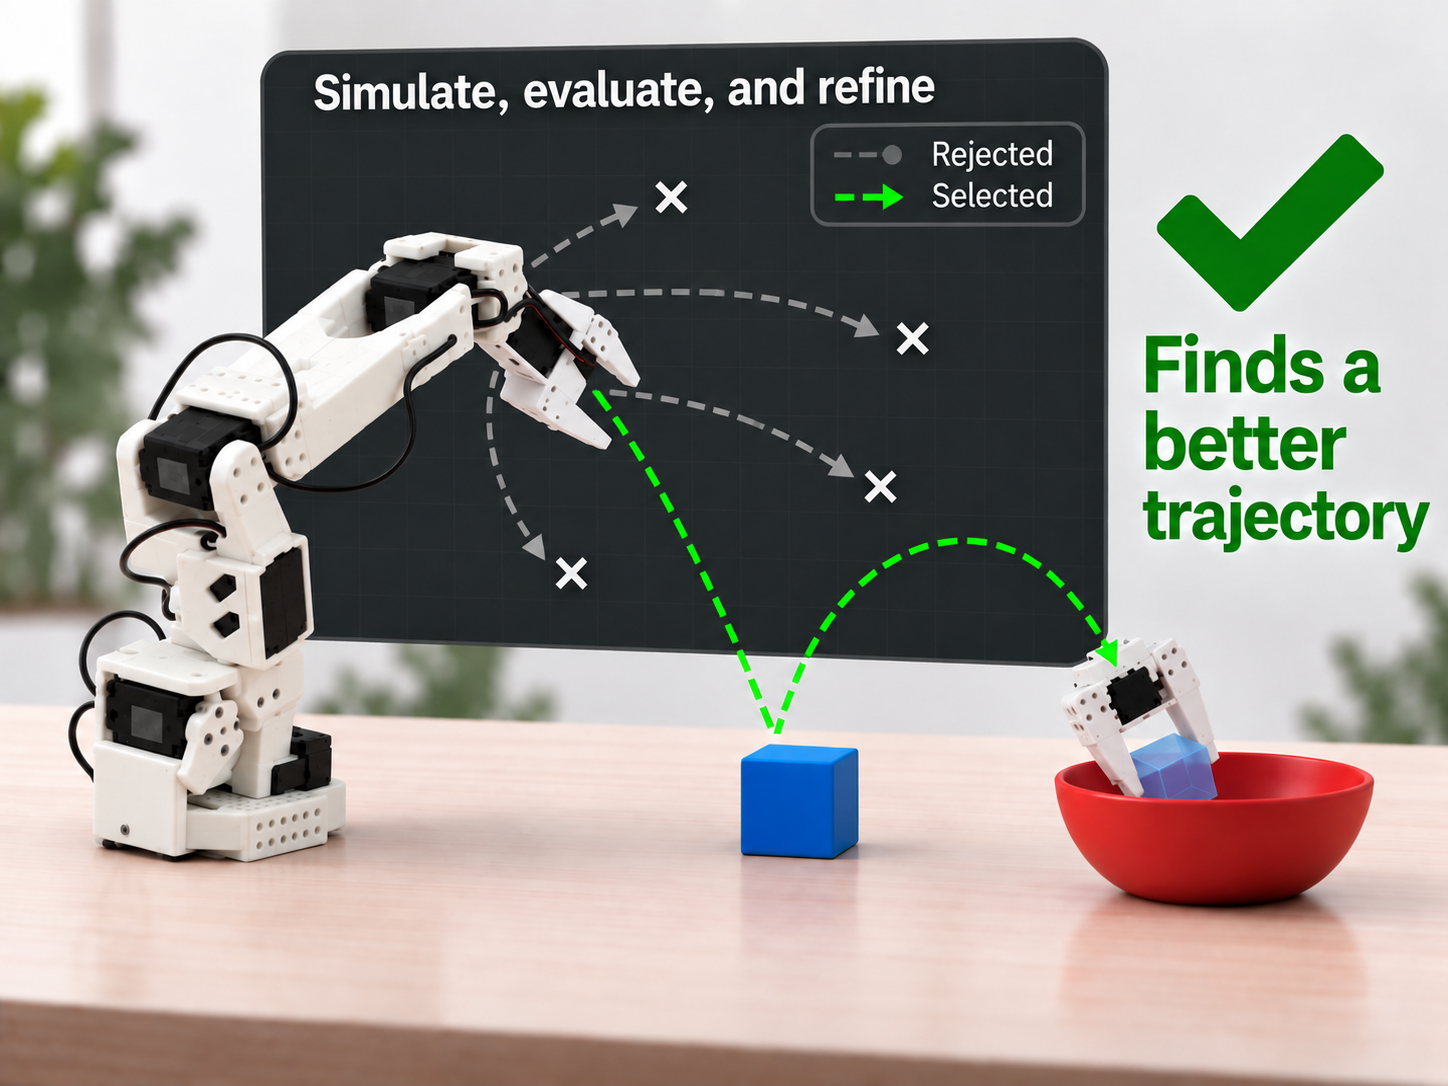
仿真中的轨迹错误与改进。 左图展示了一次抓取失败,作为轨迹错误的一个例子。右图展示了在仿真中评估和改进候选轨迹的过程。二者均为概念示意图。
SAIL 如何改进轨迹
SAIL 用 MCTS 将有望轨迹的改进与其他可能性的探索结合起来。搜索依赖三个部分。(1) 从相似示范中生成。 每个节点代表一条完整轨迹,由 VLM 通过上下文学习、结合检索到的示范生成。(2) 评估任务完成度。 轨迹在仿真中执行,再由一个评估 VLM 根据执行视频估计任务完成情况。(3) 借助步骤级反馈改进。 父轨迹在选定的路标点上标注进度分数后传给生成 VLM,后者产出修改后的轨迹,作为子节点。每条边代表一次这样的改进。

SAIL 中的轨迹改进。 (1) 系统检索示范并生成一条轨迹。(2) 它根据仿真执行结果估计任务完成度。(3) 与选定轨迹路标点对齐的完成度分数指导下一轮改进。
1. 从相似示范中生成
档案库存储成功轨迹。系统从与当前场景相似的场景中检索示范。生成 VLM 接收这些示范,连同当前物体配置和机器人状态,生成一条完整轨迹。搜索过程中找到的成功轨迹会加入档案库,供后续使用。
2. 评估任务完成度
第 1 步生成的轨迹在仿真中执行,产生一段执行视频。评估 VLM 通过判断视频中预定义子任务的推进程度,估计任务完成了多少。整个执行过程中的完成度估计被合并为一个轨迹分数,因此即使两个候选都没完成任务,也能进行比较。这一评估建立在 ROVER 对任务进度随时间打分的方法之上 [Schroeder et al., 2025]。
3. 利用步骤级反馈进行细化
从采样视频帧得到的完成度评分与选定的轨迹路点对齐,再返回给生成轨迹的 VLM。反馈会提示模型保留成功的片段,并修改进展停滞的部分。修改后的轨迹构成一个子节点,在仿真中再次评估,以指导后续搜索。
成功率随搜索预算增加而提高
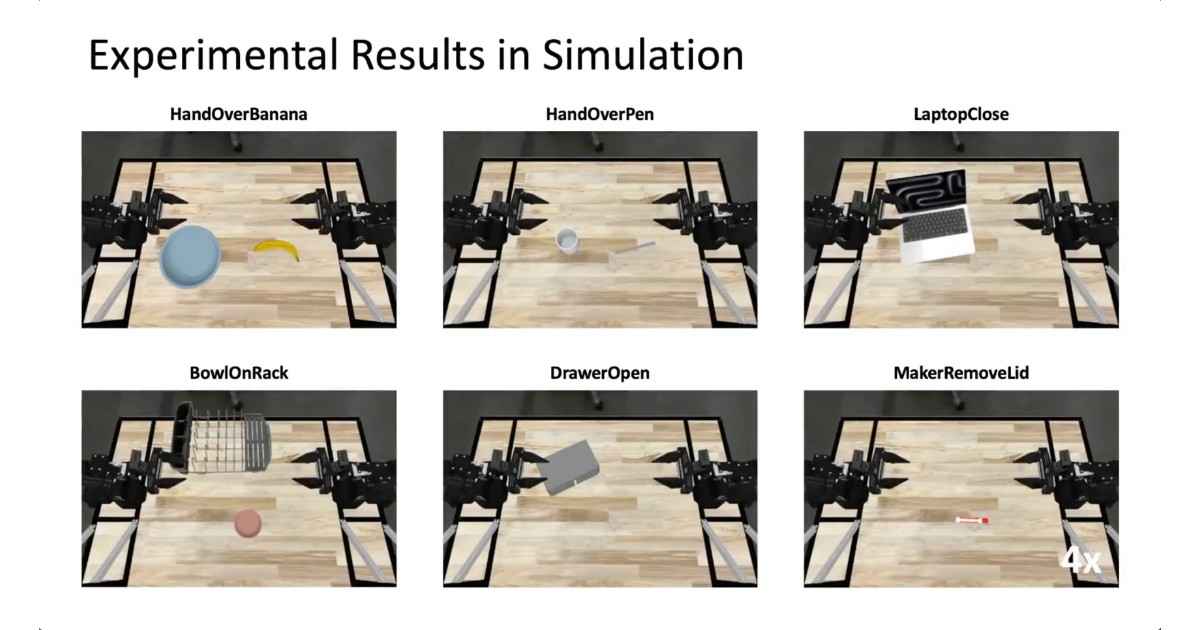
我们在 ALOHA 仿真器中评估了六项操作任务,每项任务有 20 个初始配置。增加搜索预算后,平均成功率从单条生成轨迹的 25% 提升到预算为 45 条候选轨迹(最多 45 个搜索节点)时的 73%。
六项评估任务的仿真示例。
这里的成功率衡量的是:在搜索预算内,搜索找到通过仿真器真值成功检查的轨迹的频率。这一二值检查与用于指导搜索的 VLM 任务完成度估计是分开的。
表 1. 每项任务 20 个初始配置下找到成功轨迹的比例(%)

| 方法 | 节点 | Banana | Pen | Bowl | Drawer | Laptop | Marker | 平均值 | |
|---|---|---|---|---|---|---|---|---|---|
| 基线 | |||||||||
| 单次生成 | 1 | 40 | 40 | 40 | 10 | 15 | 5 | 25 | |
| 广度优先搜索 | 15 | 85 | 50 | 60 | 35 | 60 | 15 | 51 | |
| 深度优先搜索 | 15 | 45 | 50 | 80 | 5 | 30 | 10 | 37 | |
| 我们的方法(SAIL) | |||||||||
| 单次生成(重复) | 更多 | ||||||||
| 节点 | 1 | 40 | 40 | 40 | 10 | 15 | 5 | 25 | 更高 |
| 成功率 | |||||||||
| SAIL | 6 | 80 | 55 | 100 | 20 | 50 | 25 | 55 | |
| SAIL | 15 | 90 | 70 | 100 | 40 | 50 | 40 | 65 | |
| SAIL | 30 | 95 | 80 | 100 | 50 | 55 | 45 | 71 | |
| SAIL | 45 | 95 | 80 | 100 | 50 | 70 | 45 | 73 |
在测试的各个预算下,平均成功率均有提升:6、15、30、45 个节点时分别达到 55%、65%、71% 和 73%。这些结果表明,通过搜索与细化实现的测试时扩展确实有效——在不更新 VLM 权重的前提下,增加推理计算量即可提高成功率。
从仿真到实体执行
我们在 LeRobot SO-101 机械臂上评估了积木放置任务的实体执行。方法从彩色和深度观测重建场景,在仿真中搜索出一条成功轨迹,再在机器人上执行。物体位置随机化,候选轨迹预算为 15 条,六次试验中成功五次。剩下的一次失败,我们归因于位姿估计误差以及仿真与真实环境在接触动力学上的差异。

将积木放入碗中的仿真环境与实体环境。
此外,搜索得到的成功轨迹还可以作为模仿策略的训练数据。这一做法同样在六次试验中成功五次,并且相比 MCTS 搜索缩短了所报告的执行时间。
局限与未来工作
SAIL 有三项主要局限。第一,轨迹以开环方式执行,运动过程中没有视觉反馈。第二,在仿真中搜索和细化轨迹需要额外的计算量。第三,真实环境评估只覆盖一个任务、每种方法六次试验,还需要更广泛的验证。
SAIL 表明,把推理计算分配给仿真反馈和迭代细化,可以改进 VLM 生成的机器人轨迹。方法与实验细节见论文。