面向编码智能体的挽具设计的实证研究
编码框架决定了自主编码智能体如何将模型能力转化为长周期软件工程表现,但通常被作为单体系统进行评估。本研究固定执行循环,在SWE-Bench Verified和Terminal-Bench上针对四个模型逐一改变三个组件:规划、动作空间和上下文管理。
中文
复制
编码智能体运行框架设计的实证研究
Run-Ze Fan, Zihao Zhang, Simin Ma, Yebowen Hu, Shouju Wang, Kaiqiang Song, Fei Liu, Hamed Zamani, Xiaoyang Wang
摘要
编码运行框架决定了自主编码智能体如何将模型能力转化为长周期软件工程表现,但现有工作通常把运行框架当作一个整体来评估,各个组件各自的作用因此并不清楚。为了在组件层面进行比较,我们用一个轻量级编码运行框架来研究这个问题:执行循环固定不变,只改变三个组件——规划、动作空间和上下文管理。我们在 SWE-Bench Verified 和 Terminal-Bench 2.1 上评估了四个模型,覆盖 176 组匹配设置,涉及五种上下文管理策略、四档上下文窗口预算,以及针对规划和动作空间的定向消融。我们发现:(1) 上下文窗口预算越紧,上下文管理的价值越大,其收益主要来自避免上下文溢出导致的失败。(2) 在基于 LLM 的摘要之前先做基于规则的裁剪,在各类上下文管理策略中整体效率最高;而让被裁剪的内容可恢复则会引入额外机制,模型很少使用,准确率也没有提升。(3) 规划的作用会随模型能力变化:对较弱模型是准确率的支撑,对较强模型则只是省成本,准确率变化不大。(4) 预定义工具能提升 bash 能力较弱的模型的表现;而 bash 能力强的模型仅用 bash 接口即可有效工作,成本显著更低,在以命令行为主的任务上尤其如此。 轨迹层面的分析解释了这些效应:上下文管理延长了执行轨迹,但没有明显改变智能体的行为;规划改变的是轨迹在何处停止;动作空间改变的是代码写出来的粒度。这些发现可为兼顾模型与预算的运行框架设计提供依据,也为评估未来的运行框架组件提供了一个模块化框架。
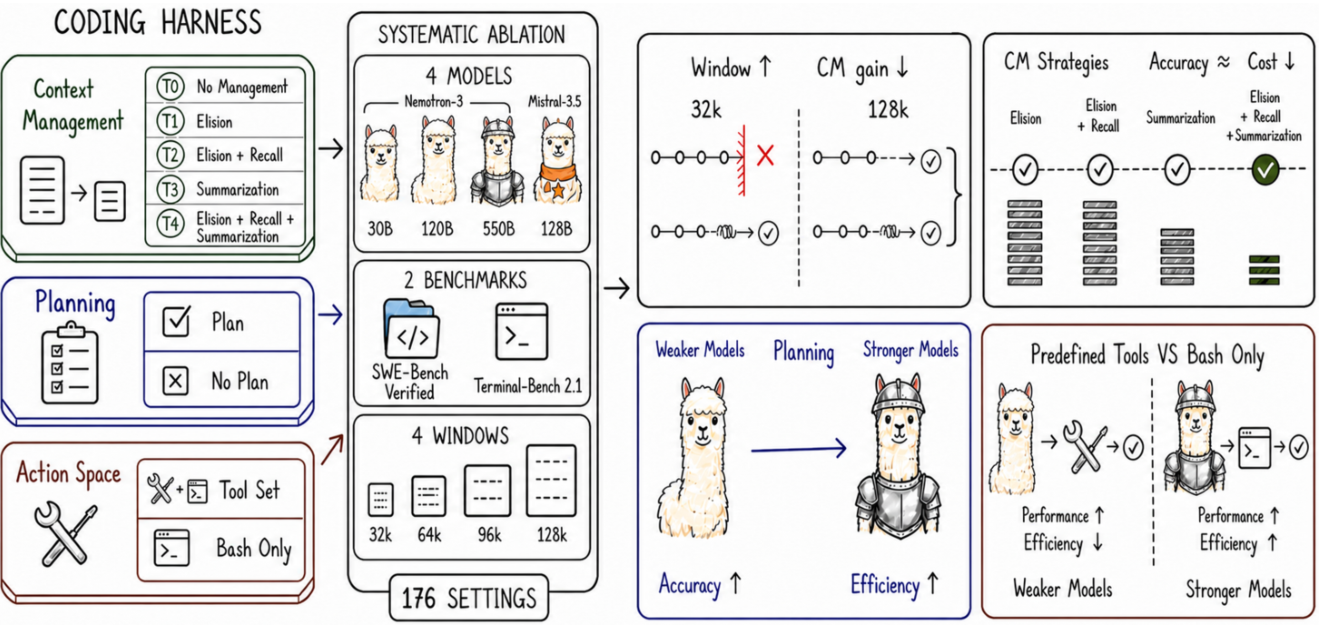
图 1:拆解编码 harness。我们系统性地消融了上下文管理、规划与动作空间,揭示出四类条件性效果,它们分别取决于上下文预算、模型能力与任务类型。
1 引言
大语言模型(LLM)正越来越多地被用于自主解决真实的软件工程任务,包括关闭 GitHub issue(Jimenez et al., 2024)以及完成端到端的终端任务(Merrill et al., 2026)。这一表现来自让 LLM 在编码 harness 中运行——harness 是一层软件,其各个组件介入 agent 行为的不同方面:规划脚手架维持任务结构,动作接口决定模型意图如何变成可执行操作,上下文管理策略则决定在有限窗口下哪些交互历史仍然可用(Yang et al., 2024; Wang et al., 2025; Rombaut, 2026)。这些选择并非无关紧要的实现细节:在模型固定的前提下更换 harness,模型表现可能发生显著变化(Yang et al., 2024; Wang et al., 2024; Lewis, 2026)。
尽管编码 harness 在实证上取得了成功,许多现有研究仍把它们当作完整系统来评测(Wang et al., 2025; Wong et al., 2025; Xia et al., 2024; Arora et al., 2024)。例如,Cao et al. (2026) 的跨 harness 评测报告称,在所评测的 harness 中,Claude-Opus-4.5 搭配 OpenHands 表现最好,而 Claude-Sonnet-4.5 搭配 SWE-Agent 表现最好,说明 harness 的偏好会因模型而异。然而,完整 harness 之间的比较混杂了多种机制,因此两个 agent 之间的性能差异并不能说明收益来自规划、工具设计、上下文管理,还是它们与底层模型的交互。这就引出一个研究问题:harness 组件是否在各类设置下普遍有用,还是每个组件的有效性都取决于模型能力、任务类型与资源预算?已有工作考察过跨模型的组件交互与架构选择(Liu, 2026; Bogavelli et al., 2025; Mehtiyev and Assunção, 2026; Rombaut, 2026),但没有在长时程编码任务上,同时结合显式的上下文窗口扫描与同系列模型的规模轴,对实现层面的规划、工作区动作接口和上下文管理策略做出联合刻画。因此,现有证据无法解释哪些组件造成了不同 harness 之间的差异,也无法说明这些组件何时可以迁移。
为应对这一挑战,我们构建了一套 coding harness,其外围执行循环保持不变,只改变三个核心组件:规划、动作空间和上下文管理。我们聚焦这三个组件,是因为已有系统将它们视为长时程 coding agent 的互补需求:规划用于维持任务推进(Bairi et al., 2024),动作空间把模型意图转化为可执行的工作区操作(Yang et al., 2024; Wang et al., 2024),上下文管理则在轨迹不断增长时保留有用信息(Packer et al., 2023; Wu et al., 2025)。其他运行机制,如权限处理、编辑后诊断和卡死检测,均保持固定,以提供统一的执行底座。规划组件维护一份显式的任务计划,模型可在整条轨迹中随时更新。动作空间要么暴露一组预定义的工作区工具,要么只提供 bash 接口。上下文管理方面,我们定义了五种策略。T0 不做额外的跨轮压缩,一旦超出上下文窗口便终止。T1 丢弃过期的工具观测结果。T2 增加外部存储和 recall_event,使被丢弃的观测结果可以恢复。T3 使用 LLM 摘要,但不做丢弃。T4 将丢弃、可恢复的外部存储和摘要组合成分阶段策略,先执行丢弃,再调用摘要。这种模块化设计让我们能够固定模型、任务、执行循环和未消融的组件,同时估计每项已实现干预的条件效应。
借助这套 harness,我们评估了 Nemotron-3(Blakeman et al., 2025)的三个规模——30B、120B 和 550B——作为同一模型家族内的能力轴,并以 Mistral-Medium-3.5-128B(Mistral AI, 2026)作为跨家族对照。 我们把这些模型当作能力与交互风格的探针,而非长期的优化目标。 因此,我们的发现能为未来面临同样上下文、动作空间和规划权衡的模型提供可迁移的诊断依据。 我们在两个互补的长时程 coding 基准上评估每个模型:SWE-Bench Verified(Jimenez et al., 2024)考察仓库级 issue 解决能力,Terminal-Bench 2.1(Merrill et al., 2026)考察端到端的终端任务完成能力。上下文管理方面,我们在 32k、64k、96k 和 128k token 四种上下文窗口预算下比较五种策略。我们另外在 128k 上下文窗口预算、采用 T4 上下文管理策略的条件下,分别对规划和动作空间做消融,共得到 176 种实验设置。除成功率和成本外,我们还进行轨迹级分析,刻画每项干预如何改变任务推进、终止行为、上下文使用和工具调用。主要发现总结如下:
- •
上下文管理在上下文窗口预算紧张时最为关键。它能防止上下文溢出导致执行提前终止,让 agent 得以推进到代码修改与验证阶段。随着上下文窗口扩大,它在准确率上的收益逐渐减弱。
- •
在 LLM 摘要之前先做分阶段省略(T4)是各种上下文管理策略中效率最高的。T4 在将峰值上下文控制在合理范围、减少对摘要调用依赖的同时,平均成功率与其他受管理的策略相当。相比之下,让省略可逆的召回机制很少被触发,也无法在省略之外进一步提升准确率。
- •
随着模型能力增强,规划的作用从准确率支架转变为效率辅助。对较弱的模型,规划能让轨迹维持足够长的时间以尝试一次编辑,以额外成本换取更高的成功率;对较强的模型,它主要是去掉编辑后多余的验证,在准确率仅有小幅变化的情况下降低成本。
- •
预定义工具能提升 bash 能力较弱的模型的表现,而纯 bash 接口则能降低 bash 能力较强的模型的成本。预定义工具减少了对 shell 命令的依赖,而 bash 能力强的模型可以在一次调用中组合多个操作。由此产生的准确率与成本之间的权衡因任务类型而异。
2 Harness 设计
为考察各 harness 组件的贡献如何随模型和计算预算而变化,我们从零构建了一个轻量级 harness。现有许多 harness 把实现选择耦合在一起,难以独立调整。我们的模块化设计允许各组件独立配置与组合,从而支持受控的组件级分析。该 harness 遵循 ReAct 循环(Yao et al., 2022),每一轮包含一个推理步骤、一个动作和一个观察(图 2)。我们改变三个组件:规划(§2.1)、动作空间(§2.2)和上下文管理(§2.3),具体如下。其他支撑组件,如工作区访问控制、编辑后诊断和卡死检测,在各消融实验中保持不变,以隔离每项干预的效果。
2.1 规划
规划为模型提供了一种显式、持久化的任务进度表示,由模型自行维护。启用后,系统指令定义协议(图 15),并在首轮提醒模型在行动前先给出初始计划(图 16)。模型通过 update_plan 工具维护该计划(图 30)。后续轮次会把计划追加到模型输入中,但不写入对话历史(图 17);附录 7.2 说明了这些块在运行时如何组装。在禁用规划的设置中,我们移除规划指令、提醒、计划注入和该工具,同时保持执行循环、动作接口和上下文管理不变。因此,我们的结果估计的是这一持久化规划脚手架的效果,而非规划作为一种通用推理策略的效果。
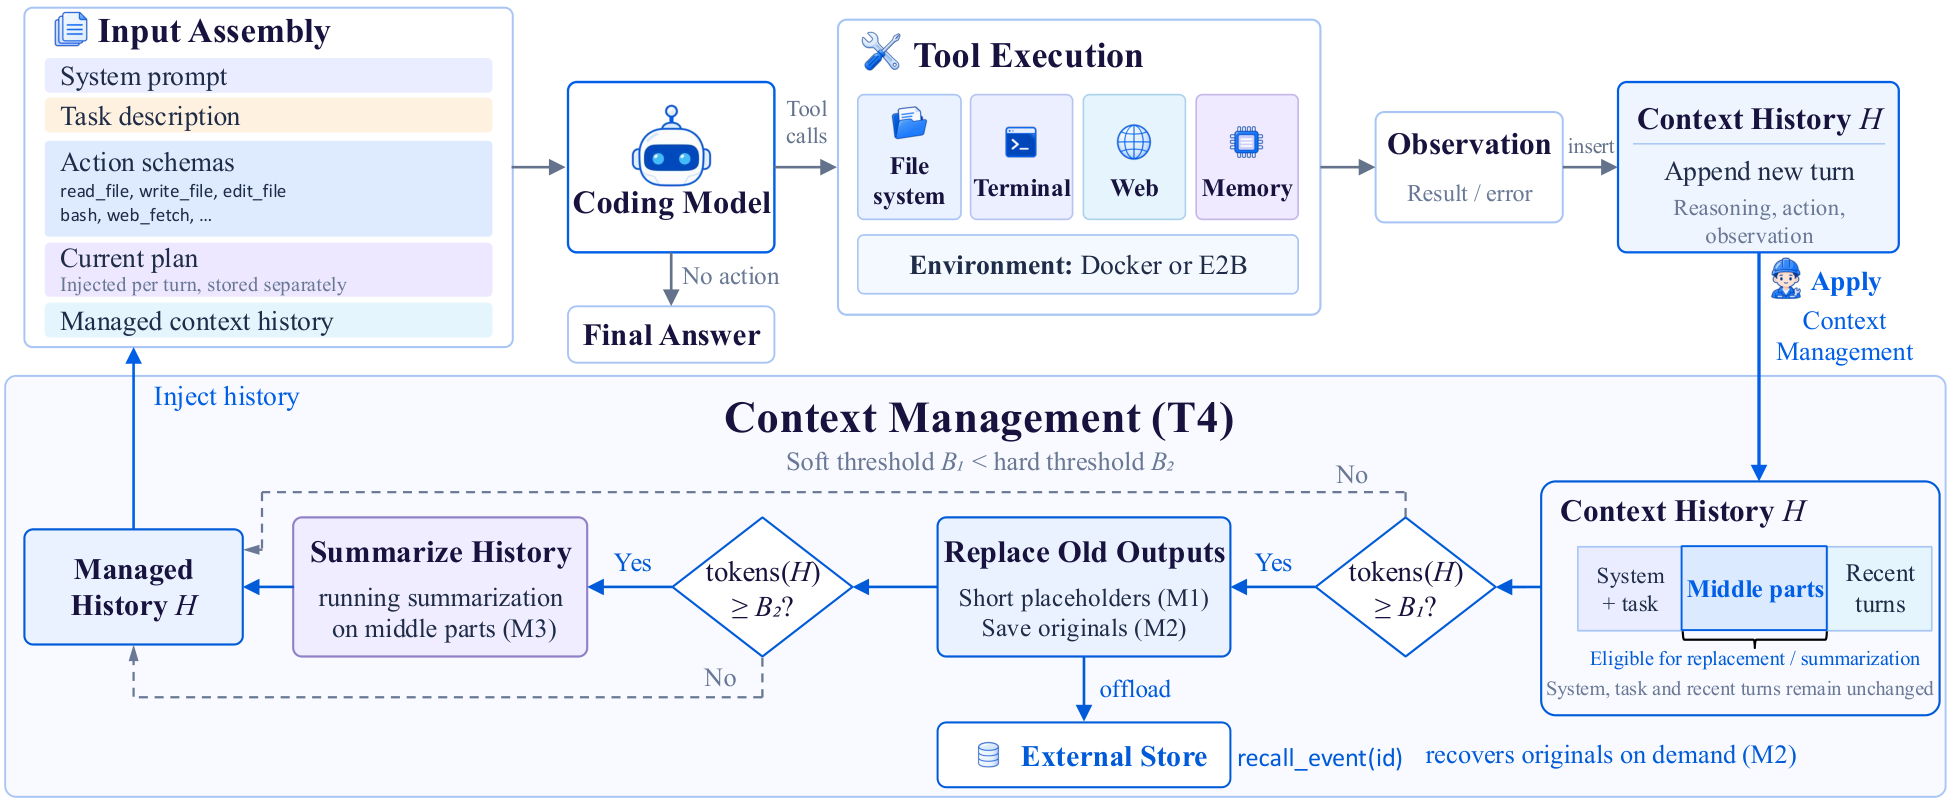
图 2:编码 harness 总览。上:ReAct 循环,每一轮组装模型输入、在任务容器中执行模型发出的工具调用,并把观测结果追加到历史 HH 中。规划通过注入的计划进入,动作空间通过暴露的 schema 进入,上下文管理通过模型看到的历史进入。下:T4 策略。M1–M3 是三种上下文管理机制。超过软阈值 B1B₁ 后,体积较大的中间区域工具输出被替换为占位桩(M1),并转存到外部存储,可通过 recall_event 取回(M2);超过硬阈值 B2B₂ 后,最旧的中间事件被摘要(M3)。前导部分和最近若干轮保持原文不变。
2.2 动作空间
动作空间定义了 agent 与环境交互的方式。 预定义工具集提供 read_file、write_file、edit_file、list_files、glob_files、grep_text、web_fetch 和 bash,汇总见表 1(系统提示见图 13)。每个工具都有带类型的参数 schema,以及说明其协议、错误和副作用的描述;附录 8 汇总了参数与只读状态。 我们排除了 web 搜索,因为 SWE-Bench 任务源自公开的 GitHub issue,搜索可能暴露对应的 pull request 和真实补丁(Cao et al., 2026)。仅 bash 设置移除了预定义的文件、搜索和 web 工具,只保留 bash 用于通用环境交互(图 14)。由其他 harness 组件控制的辅助工具保持不变:在 T4/128k 中启用规划时,两种条件都保留 update_plan 和 recall_event。附录 7.1 和 8 给出了其余提示和工具描述。这一干预同时改变了工作区修改的跟踪与校验方式。预定义文件工具会强制执行写前读取检查、更新 harness 的文件状态,并在支持的编辑后触发自动诊断。因此,这一比较应被理解为完整动作接口的效果,包括工具可用性、接口指令、状态跟踪和校验支持,而不是工具数量或动作粒度的孤立效果。
表 1:harness 暴露的工具。只读工具不会修改工作区或 harness 状态,且可在单个模型回合内并发执行。仅 bash 的动作空间条件会移除预定义的工作区工具,但保留 bash,以及已启用的规划和上下文管理组件所需的辅助工具。表中列出的是主要参数。附录 8 复现了完整的自然语言描述。
| 工具 | 只读 | 主要参数 | 说明 |
|---|---|---|---|
| 文件 I/O | |||
| read_file | ✓ | path, offset, limit | 读取文件,返回时带行号 |
| write_file | ✗ | path, content, overwrite | 创建文件或覆盖已有文件 |
| edit_file | ✗ | path, old_text, new_text, replace_all | 替换文件中的精确字符串 |
| 搜索 | |||
| list_files | ✓ | path, recursive | 列出目录内容 |
| glob_files | ✓ | pattern, path | 查找匹配 glob 模式的文件 |
| grep_text | ✓ | query, path, include | 按正则表达式搜索文件内容 |
| 执行 | |||
| bash | ✗ | command, timeout_seconds, cwd | 执行 shell 命令 |
| Web | |||
| web_fetch | ✓ | url, format | 以文本或 markdown 抓取网页 |
| 规划 | |||
| update_plan | ✗ | plan | 创建或更新已存储的任务计划 |
| 上下文管理 | |||
| recall_event | ✓ | id | 返回已存储事件的原文内容(仅 T2 和 T4) |
2.3 上下文管理
上下文管理决定如何在有限的上下文窗口内表示不断增长的交互历史。现有方法分为有损和无损两类。省略和摘要等有损方法能压缩上下文,但可能删掉之后才有用的信息(Xiao et al., 2024; Jiang et al., 2023; Wu et al., 2021);无损方法则通过外部存储与检索保证信息可恢复,但需要额外的机制,且依赖模型检索到正确的信息(Packer et al., 2023; Park et al., 2023; Ehrlich and Blackman, 2026; Xu et al., 2026)。我们的 harness 通过三种可组合的机制同时借鉴这两类方法。省略(M1)把过期的工具观测结果正文替换成一段简短的 stub。召回(M2)把被省略的观测结果存入文件系统,并提供一个 recall_event 工具按需读回,使省略可逆。摘要(M3)把较早的消息折叠进一份持续更新的自然语言摘要。摘要由对同一个被评测模型的单独一次无工具调用生成,所用 prompt 见附录 7.3。省略以低成本回收 token,但丢弃细节;召回在需要时恢复这些细节;摘要则压缩那些过于久远、无法逐字保留的历史。我们在两个 token 阈值下组合使用它们:软阈值 B1B₁ 和硬阈值 B2B₂。前导部分(system prompt 和初始任务描述)以及至少两轮的、受 token 预算限制的近期窗口保持逐字不变;只有中间区域会被压缩。一旦历史超过 B1B₁,harness 就省略中间区域中体积庞大的工具观测结果,把原文存到外部,并在原处留下 stub(M1 和 M2)。如果历史仍超过 B2B₂,harness 就把中间区域最旧的事件摘要进那份持续更新的摘要中(M3)。 算法 1 给出了完整流程,recall_event 在每一轮都可用。附录 7.3 复现了摘要 prompt,以及插入模型输入的 stub 片段和摘要片段。
表 2:五种上下文管理层级,每一层分别启用省略(M1)、召回(M2)和摘要(M3)中的一部分。
| M1 | M2 | M3 | |
|---|---|---|---|
| 层级 0 | ✗ | ✗ | ✗ |
| 层级 1 | ✓ | ✗ | ✗ |
| 层级 2 | ✓ | ✓ | ✗ |
| 层级 3 | ✗ | ✗ | ✓ |
| 层级 4 | ✓ | ✓ | ✓ |
为分离各机制各自的贡献,我们定义了五种策略变体,见表 2。层级 4 是算法 1 所述的三机制完整配置。层级 0 关闭上下文管理;一旦轨迹超出窗口便报错终止。层级 1 仅使用省略(M1),将过期的工具观测正文替换为短桩,并丢弃原始内容。层级 2 加入召回(M2):被省略的观测存入外部存储,可通过 recall_event 取回,因此省略是可逆的。层级 3 仅使用摘要(M3),将中间区域折叠为一份滚动摘要,不做省略。层级 1–3 各自只含一个动作,因此在硬阈值 B2B₂ 处触发;层级 4 则在 B1B₁ 处省略、在 B2B₂ 处摘要。
算法 1 每轮上下文管理(层级 4)
1:
历史 HH;软阈值与硬阈值 B1 < B2,B₁ < B₂
2:
将新的 think、action 和 observation 追加到 HH
3:
若模型本轮调用了 recall_event(id) 则
4:
从外部存储将观测 idid 读回 HH ⊳\triangleright M2
5:
end if
6:
原样保留前导部分和一段预算大小的近期窗口(至少包含最近两轮);令 MM 为中间区域
7:
若 tokens(H) ≥ B₁ 则
8:
对 MM 中每一条体积较大的工具观测 do
9:
将原文存入外部存储 ⊳\triangleright M2
10:
用桩替换其正文 ⊳\triangleright M1
11:
end for
12:
若 tokens(H) ≥ B₂ 则
13:
将 MM 中最旧的事件摘要为一份滚动摘要 ⊳\triangleright M3
14:
end if
15:
end if
16:
return HH
2.4 其他组件
除上述三个组件外,harness 还包含若干辅助组件,我们在所有消融实验中均保持其不变。下面重点介绍其中最重要的三个。
安全
所有读取或修改工作区的操作都要经过三道关卡。工作区守卫会解析每个路径,拒绝任何逃出项目根目录的路径,包括通过符号链接逃出的情况。写前读取检查会拒绝编辑或覆盖当前会话中尚未读取过的文件,并通过内容哈希检测外部修改。权限层随后将每个操作分类为 allow、ask 或 deny。工具错误作为观察结果返回给模型,而不是抛出异常,因此失败的操作不会让循环崩溃,模型可以从中恢复。
编辑后诊断
agent 编辑或写入 Python 文件后,harness 会用 ruff、pyflakes 或仅做语法检查的兜底方案对其运行一次快速、只读的检查,并把结果追加到工具返回值中。这样语法错误、未定义名称和未使用的 import 会立即暴露出来,模型可以在把一轮消耗在测试上之前先修好它们。
卡死检测
基于轮次的 agent 可能空转,反复发出同一个失败的操作,直到耗尽步数预算。harness 会监控工具日志中是否存在连续重复的调用,即工具名和参数都相同的连续调用。当这种连续重复达到阈值时,它会注入一次性的提醒,要求改变做法;当连续重复的失败调用持续增长时,它会提前结束运行,而不是一路磨到预算上限。提醒文本和阈值见附录 7.4。
3 实验
3.1 设置
模型。
实验中我们使用 Nemotron-3 系列的三个规模(Blakeman et al., 2025)(30B、120B 和 550B)。此外还加入了来自另一模型系列的 Mistral-Medium-3.5-128B(Mistral AI, 2026),以检验我们的结论是否能推广到单一系列之外。token 价格按 OpenRouter11 计算 1
https://openrouter.ai/,访问于 2026 年 8 月。每 100 万输入/输出 token 的价格:0.20(Nemotron-3-30B)、0.45(Nemotron-3-120B)、2.20(Nemotron-3-550B)、7.50(Mistral-Medium-3.5)。
基准测试
我们在两个长时程编程基准上进行评估:SWE-Bench Verified(Jimenez 等,2024),包含 500 个经人工核验的真实 GitHub issue;以及 Terminal-Bench 2.1(Merrill 等,2026),包含 89 个命令行环境下的端到端任务。两者均报告两项指标:任务成功率,即 agent 解决的任务占比;以及每任务平均成本,计价方式如上所述。
实现细节
- •
模型与服务 三个 Nemotron-3 模型和 Mistral-Medium-3.5-128B 均以 BF16 精度通过 SGLang 本地服务。Temperature 设为 0,top-p 为 0.95。每轮输出上限为 16,384 token。
- •
Harness 配置 Harness 基于 LangGraph 构建,22 2
https://www.langchain.com/langgraph,基准测试通过 Harbor 驱动,33 3
https://www.harborframework.com/,由 Harbor 持有每个任务的容器与验证器,宿主 agent 在容器上执行操作。每个任务最多运行 300 步。上下文管理方面,软阈值和硬阈值分别为可用窗口的 0.6 和 0.85,逐字保留的近期窗口预算为 0.3,下限为两轮。工具结果截断至 24k 字符,每步最多可并行运行八个只读工具。卡死检测在连续五次相同的工具调用或连续五次相同的失败调用后发出提醒,并在连续八次相同的失败调用后终止。
消融设置
我们在 32k、64k、96k 和 128k 上下文窗口预算下评估 T0–T4,每个模型–基准组合产生 20 种设置。所有设置均使用预定义工具集并启用 planning。T4/128k 设置作为其余组件消融的基线。一种匹配设置禁用 planning,另一种将预定义工具集替换为仅 bash 接口,其余组件保持不变。Planning 与动作空间仅在 T4/128k 下评估。20 种上下文管理设置加上两项额外的组件消融,每个模型–基准组合共 22 种设置,四个模型、两个基准合计 176 种实验设置。对每个基准,我们定义三个比较族:管理策略 vs. T0、planning 开 vs. 关、完整工具集 vs. 仅 bash。在每个族内,我们用双侧精确 McNemar 检验比较任务配对结果的成功率,并应用 Benjamini–Hochberg 方法将错误发现率控制在 0.05。
3.2 主要结果
表 3:SWE-Bench Verified 上的主要结果,报告成功率(SR,%)与每任务平均成本($)。每一行将一个上下文窗口预算与一个上下文管理档位配对:T0 不做任何上下文管理,T1 仅做省略,T2 省略加召回,T3 仅做摘要,T4 三种机制全开。最后两行在 128k/T4 设置下消融单个组件:−-plan 关闭规划,bash 用裸 shell 替换结构化工具集。加粗表示各模型的最高 SR。 表示在双侧精确 McNemar 检验、Benjamini–Hochberg 校正后 q<0.05q<0.05 的条件下,与匹配基线存在显著差异。*
| Nemotron-3 30B | Nemotron-3 120B | Nemotron-3 550B | Mistral-3.5-128B | ||
|---|---|---|---|---|---|
| 设置 | SR (%) | 成本 ($) | SR (%) | Cost ($) | SR (%) |
| 32K | T0 | 09.40 | 0.04 | 11.40 | 0.05 |
| T1 | 20.60* | 0.09 | 43.00* | 0.35 | 51.40* |
| T2 | 20.80* | 0.09 | 42.20* | 0.36 | 53.60* |
| T3 | 23.80* | 0.11 | 39.60* | 0.18 | 58.40* |
| T4 | 21.20* | 0.11 | 42.20* | 0.17 | 55.60* |
| 64K | T0 | 20.80 | 0.07 | 34.00 | 0.10 |
| T1 | 23.40 | 0.09 | 45.40* | 0.39 | 63.80* |
| T2 | 24.40 | 0.09 | 43.20* | 0.32 | 64.60* |
| T3 | 26.40* | 0.10 | 43.60* | 0.23 | 65.80* |
| T4 | 25.80* | 0.08 | 41.80* | 0.21 | 63.40* |
| 96K | T0 | 24.00 | 0.09 | 39.60 | 0.20 |
| T1 | 23.20 | 0.09 | 43.20 | 0.33 | 65.00* |
| T2 | 23.60 | 0.09 | 45.40* | 0.37 | 67.20* |
| T3 | 23.60 | 0.09 | 46.20* | 0.36 | 66.80* |
| T4 | 24.80 | 0.09 | 43.40 | 0.30 | 66.80* |
| 128K | T0 | 24.80 | 0.09 | 40.20 | 0.25 |
| T1 | 25.00 | 0.10 | 44.40 | 0.39 | 65.20* |
| T2 | 26.00 | 0.10 | 45.20* | 0.35 | 67.40* |
| T3 | 23.60 | 0.11 | 44.00 | 0.35 | 65.80* |
| T4 | 25.20 | 0.09 | 44.00 | 0.34 | 65.80* |
| T4 w/o plan | 13.60* | 0.02 | 46.60 | 0.25 | 67.80 |
| T4 bash only | 10.20* | 0.03 | 42.40 | 0.35 | 69.40* |
表 4:Terminal-Bench 2.1 上的主要结果,报告成功率(SR,%)与每任务平均成本($)。每一行将一个上下文窗口预算与一档上下文管理策略配对:T0 不做任何上下文管理,T1 仅做省略,T2 省略加召回,T3 仅做摘要,T4 三种机制全开。最后两行在 128k/T4 设置下消融单个组件:−-plan 关闭规划,bash 用裸 shell 替换结构化工具集。加粗表示各模型的最高 SR。 表示在双侧精确 McNemar 检验、Benjamini–Hochberg 校正后 q<0.05q<0.05 的条件下,与匹配基线存在显著差异。*
| Nemotron-3 30B | Nemotron-3 120B | Nemotron-3 550B | Mistral-3.5-128B | ||
|---|---|---|---|---|---|
| Setting | SR (%) | Cost ($) | SR (%) | Cost ($) | SR (%) |
| 32K | T0 | 06.74 | 0.04 | 19.10 | 0.09 |
| T1 | 11.24 | 0.12 | 33.71* | 0.44 | 33.33 |
| T2 | 07.87 | 0.12 | 25.84 | 0.46 | 33.33 |
| T3 | 14.61 | 0.11 | 22.47 | 0.13 | 38.20* |
| T4 | 17.98* | 0.11 | 21.35 | 0.14 | 32.58 |
| 64K | T0 | 11.24 | 0.08 | 20.22 | 0.13 |
| T1 | 14.61 | 0.12 | 29.21 | 0.28 | 41.57 |
| T2 | 11.24 | 0.12 | 26.97 | 0.32 | 40.45 |
| T3 | 14.61 | 0.12 | 26.97 | 0.20 | 43.82* |
| T4 | 13.48 | 0.10 | 25.84 | 0.22 | 44.94* |
| 96K | T0 | 12.36 | 0.11 | 19.10 | 0.28 |
| T1 | 15.73 | 0.14 | 22.47 | 0.23 | 42.70 |
| T2 | 11.24 | 0.15 | 21.35 | 0.37 | 43.82* |
| T3 | 17.98 | 0.16 | 28.09 | 0.32 | 34.83 |
| T4 | 13.48 | 0.13 | 25.84 | 0.25 | 44.94* |
| 128K | T0 | 11.24 | 0.12 | 25.84 | 0.27 |
| T1 | 10.11 | 0.15 | 22.47 | 0.40 | 40.45 |
| T2 | 16.85 | 0.15 | 25.84 | 0.32 | 40.45 |
| T3 | 12.36 | 0.16 | 26.97 | 0.30 | 37.08 |
| T4 | 13.48 | 0.14 | 28.09 | 0.28 | 44.94* |
| T4 w/o plan | 08.99 | 0.08 | 28.09 | 0.38 | 46.07 |
| T4 bash only | 03.37* | 0.02 | 23.56 | 0.41 | 50.56 |
图 3:成功率与窗口溢出率随上下文窗口预算的变化。左轴:成功率;右轴(橙色):T0 因窗口溢出而失败的任务比例。每个子图中,黑线为 T0,浅蓝线分别为 T1–T4,实心蓝线为四者的均值。在所有预算下,每个受管理的层级溢出任务数都恰好为零,因此只需一条溢出曲线。
上下文窗口预算越小,上下文管理的价值越大。
对每个模型和每个上下文窗口预算,我们将上下文管理的价值定义为受管理层级(T1–T4)与无管理(T0)之间的成功率差距。在各模型上取平均,受管理–T0 的差距随窗口从 32k、64k、96k 到 128k 稳步收窄:SWE-Bench 上从 35.7 降到 15.9、5.5、2.7 个百分点,Terminal-Bench 上从 9.5 降到 7.5、4.8、2.8(表 3 和表 4)。图 3 显示,受管理–T0 差距的收窄与 T0 窗口溢出失败的减少同步发生。在这些预算下,模型平均的 T0 溢出率在 SWE-Bench 上从 78.7% 降至 8.7%,在 Terminal-Bench 上从 61.0% 降至 12.1%,而所有受管理层级的溢出失败始终为零。可见上下文管理的价值主要在于窗口吃紧时避免过早截断;当越来越多的无管理轨迹能装进窗口,它带来的精度增益随之缩小,也越来越取决于具体模型。
在各类上下文管理策略中,T4 的精度–成本权衡最佳。
图 4 显示,T4 的成功率与 T1–T3 相当,并在八个模型–基准组合中的七个里成本最低。为解释这一成本特征,我们用对应的名义上下文窗口预算对平均峰值上下文做归一化。图 5(a) 显示,在 32k 下 T1 和 T2 的轨迹仍会逼近整个窗口,而 T3 和 T4 把峰值上下文压得远低于窗口。在所有模型–基准组合上,T4 在四个窗口预算下的平均峰值上下文比例都是最低的。图 5(b) 比较了 M1 省略与 M3 摘要调用。在 32k 和 64k 下,T4 调用 M1 的次数少于 T1 和 T2,在更大窗口下调用频率同样很低;在每个预算下,它平均调用 M3 的次数也都少于 T3。在八个模型–基准组合上取平均,T4 在每个窗口预算下的单任务平均成本都是最低的(图 5(c))。这些结果表明,T4 的提前省略在需要摘要之前就处理掉了许多情况,减少了昂贵的 LLM 摘要调用,这也有助于解释它为何成本更低。
图 4:各上下文管理档位的成功率与成本。每个档位在左轴上以胶囊形区间表示 32k、64k、96k 和 128k 上下文窗口预算下成功率的最小值与最大值,横线标出均值;因此胶囊的高度反映其对窗口预算的敏感程度。默认档位 T4 以绿色标出。橙色折线对应右轴,报告同样四种预算下每个任务的平均成本。
图 5:各上下文窗口预算下的上下文压缩、机制使用情况与成本。每条曲线为四个模型、两个基准的等权平均。(a) 平均峰值上下文除以对应的名义上下文窗口预算;数值越低表示上下文压缩越有效。(b) 每个任务中 elision(M1)与 summarization(M3)的平均调用次数,采用对数坐标。实线为 T1、T2、T4 的 M1 调用次数,虚线为 T3、T4 的 M3 调用次数——只有这两个档位启用了 summarization。(c) 每个任务的平均成本,单位为美元($)。
Recall(M2)很少被使用,且相比单独使用 elision 并不能提升准确率。
Recall(M2)将被 elide 的观测结果存储在外部,并暴露 recall_event 供按需检索,从而使 elision 可逆。T1 与 T2 的唯一差别就是是否启用 M2,因此二者构成了对其价值的配对比较。 在 32 组模型–基准–窗口的对比中,T2 在 15 种设置下优于 T1,在 14 种下劣于 T1,另有三种持平;等权平均差值为 −0.36 个百分点(SWE-Bench 上 +0.40,Terminal-Bench 上 −1.12)。 表 13 显示 recall 很少被调用。 在 64 个 T2 与 T4 设置中,有 36 个(56.3%)从未调用 recall_event,调用率的中位数为零,等权均值从 32k 下的每任务 0.540 次降至 64k、96k、128k 下的 0.069、0.011 和 0.007 次;T4/128k 下的 16 个 planning 与 action-space 设置完全没有 recall 调用记录。 可见 recall 的使用集中在上下文压力最大的情形,且几乎全部来自 Nemotron-3 30B;Nemotron-3 550B 与 Mistral-Medium-3.5-128B 很少调用它。 即便是使用最频繁的配置——T2 下 32k 的 Nemotron-3 30B 跑 Terminal-Bench——平均每任务也仅调用 4.326 次,得分却比 T1 低 3.37%。 这些结果表明,无损存储增加的机制大多数模型很少使用,而检索被 elide 的观测结果并不能稳定地转化为任务完成。
图 6:开启与关闭 planning 时的绝对性能和成本。柱状图使用 T4 上下文管理、128k 上下文窗口预算和完整工具集。在每一对模型中,左侧空心柱表示关闭 planning,右侧实心柱表示开启;两个面板均采用这一表示方式。(a) 报告成功率,(b) 报告每个任务的平均成本。
Planning 提升了较弱模型的成功率,并为较强模型节省了成本。
我们在 T4/128k 和完整工具集下比较了开启与关闭 planning 的情况(图 6)。对于 Nemotron-3 30B,planning 在 SWE-Bench 上将成功率提高 11.6 个百分点,在 Terminal-Bench 上提高 4.5 个百分点,但两个基准上的成本都更高。对于 Nemotron-3 120B,planning 没有带来一致的成功率提升;它在 SWE-Bench 上增加了成本,但在 Terminal-Bench 上降低了成本。对于 Nemotron-3 550B 和 Mistral-Medium-3.5-128B,planning 在两个基准上都降低了成本,同时成功率略有下降。在 SWE-Bench 上,二者的成本分别下降约 30% 和 32%,成功率则分别下降 2.0 和 0.4 个百分点(表 3 和表 4)。 执行统计有助于解释这些成本变化(表 5)。对于 Nemotron-3 30B,planning 在两个基准上都增加了轮次、工具调用次数和每次调用的平均输入 token 数。对于 Mistral,三项指标在两个基准上都下降;对于 Nemotron-3 550B,三项指标在 SWE-Bench 上下降,在 Terminal-Bench 上的变化较小。第 4 节将这些变化追溯到单条轨迹:planning 延长了 Nemotron-3 30B 原本会在编辑前终止的运行,而 Nemotron-3 550B 和 Mistral-Medium-3.5-128B 减少的轮次主要是编辑后的验证。
表 5:在 T4、128k 上下文窗口预算和完整工具集下,从关闭 planning 到开启 planning 的百分比变化。正值表示开启 planning 后增加,负值表示减少。输入 token 平均值是指每次 agent 调用的平均输入 token 数。
| SWE-Bench Verified | Terminal-Bench | |||||
|---|---|---|---|---|---|---|
| 模型 | 轮数 | 工具调用数 | 输入 Token 均值 | 轮数 | 工具调用数 | 输入 Token 均值 |
| Nemotron-3 30B | +293.2%+293.2% | +474.0%+474.0% | +104.1%+104.1% | +66.7%+66.7% | +83.8%+83.8% | +24.0%+24.0% |
| Nemotron-3 120B | +20.1%+20.1% | +42.7%+42.7% | +10.3%+10.3% | −15.0%-15.0% | −23.1%-23.1% | −12.0%-12.0% |
| Nemotron-3 550B | −24.3%-24.3% | −24.5%-24.5% | −12.4%-12.4% | +6.8%+6.8% | +7.9%+7.9% | −1.7%-1.7% |
| Mistral-Medium-3.5-128B | −23.2%-23.2% | −23.3%-23.3% | −15.1%-15.1% | −22.5%-22.5% | −21.9%-21.9% | −13.0%-13.0% |
图 7:动作空间的影响。结果对比了仅 bash 与完整工具集,均在 T4 上下文管理、128k 上下文窗口预算、开启 planning 的条件下测得。(a) 报告成功率,(b) 报告每任务平均成本,(c) 报告启用完整工具集时通过 bash 发起的工具调用占比。
预定义工具集对较弱模型起脚手架作用,而仅 bash 反而有利于更强的模型。
在默认的 T4/128k 配置并开启 planning 的条件下,我们将完整工具集与仅 bash 进行对比。图 7 显示,预定义工具集对较弱的 Nemotron-3 模型帮助最大(表 3 和表 4)。 对 Nemotron-3 30B,预定义工具集在 SWE-Bench 上把成功率提高 15.0%,在 Terminal-Bench 上提高 10.1%。这些增益来自模型学到的动作词表与 harness 接口之间的对齐。没有预定义工具时,模型会退回到训练中习得的工具调用模式,而不是把预期操作转写成 bash。由于仅 bash 的注册表里没有这些工具,harness 无法把发出的调用解析为可执行动作。在 Terminal-Bench 上,66% 的仅 bash 轨迹在出现这类接口外调用后即告终止,平均轨迹长度从 71 轮缩短到 15 轮。预定义工具集为 Nemotron-3 30B 提供了脚手架,暴露出一个它能可靠调用的动作词表。 对 Nemotron-3 120B,准确率增益缩小到 SWE-Bench 上 1.6%1.6%、Terminal-Bench 上 4.5%4.5%,但伴随更高效的执行。与 30B 不同,120B 并不从更长的轨迹中获益:预定义工具集把 SWE-Bench 上的平均轮数从 101101 缩短到 7777,Terminal-Bench 上从 9696 缩短到 7070,且成本没有增加。 对 Nemotron-3 550B,仅 bash 在 SWE-Bench 上把成功率提高 3.6%3.6%,在 Terminal-Bench 上提高 5.6%5.6%,同时分别降低成本 53%53% 和 30%30%。仅 bash 的轨迹在 SWE-Bench 上发出的调用少 32%32%,在 Terminal-Bench 上少 24%24%。这与该模型使用更密集、更复合的 shell 命令、而非把工作分散到预定义动作上的做法一致。对这个模型来说,预定义工具集带来的似乎是动作选择与交互上的开销,而不是有用的脚手架。第 4 节从编辑层面考察这一转变。
Mistral-Medium-3.5-128B 暴露了这种交叉的工作负载边界。完整工具集在 SWE-Bench 上把成功率提高了 23.2%23.2%,但仅用 bash 在 Terminal-Bench 上提升了 6.7%6.7%。图 7(c) 解释了这一反转:使用全部工具时,Mistral 在 Terminal-Bench 上有 71.9%71.9% 的工作区操作通过 bash 发出,而在 SWE-Bench 上这一比例为 40.4%40.4%,同时预定义工具的使用从每任务 31.431.4 次降至 13.113.1 次。因此,Terminal-Bench 更偏向 shell,去掉与之竞争的工作区工具更契合模型偏好的操作;而在 SWE-Bench 上,预定义的读取、搜索和编辑操作依然重要。 另一些仅用 bash 的失败出现在修复之前:Mistral 仅用 bash 的 SWE-Bench 运行中有 32.8% 在未编辑任何文件的情况下结束,而使用完整工具集时这一比例为 1.2%(表 12);在未解决的运行中,从未触及正确文件的比例从 16.0 上升。因此,Mistral 的结果体现的是准确率与成本之间的权衡,而非全面占优,说明偏好的操作空间同时取决于模型能力和任务类型。
图 8:不同 harness 配置下的 SWE-Bench 轨迹分布。列对应模型,行对应 harness 设置,均在 T4 上下文管理和 128k 上下文窗口预算下。堆叠区域显示每一轮仍在运行的轨迹比例,分解为 Localize、Reproduce、Fix、Verify 和 Other 行为。虚线竖线标出轨迹长度的中位数。
图 9:不同 harness 配置下的 Terminal-Bench 轨迹分布。列对应模型,行对应 harness 设置,均在 T4 上下文管理和 128k 上下文窗口预算下。堆叠区域显示每一步仍在运行的轨迹比例,分解为 Understand、Write Code、Verify 和 Other 行为。虚线竖线标出轨迹长度的中位数。
4 分析
本节分析标注后的轨迹,揭示主要结果背后的行为机制。总体结果说明了哪些 harness 组件重要,却未解释这些效应如何产生。我们用一个 LLM judge 按附录 9 的分类体系为 agent 轨迹的每一轮标注其工作流阶段;judge 与人工标注者的一致率见附录 9.2。我们首先说明,上下文管理延长了执行轨迹,但未实质改变 agent 行为,因此在后续分析中统一采用 T4/128k。接着我们考察:为什么 planning 会拉长最弱模型的轨迹,却缩短最强模型的轨迹;以及 bash-only 接口如何改变动作的表达方式。
上下文管理延长执行轨迹,但不实质改变 agent 行为。
| 无编辑 (%) | 定位处 (%) | |
|---|---|---|
| 模型 | 关 | 开 |
| Nemotron-3 30B | 68.6 | 27.8 |
| Nemotron-3 120B | 15.6 | 24.4 |
| Nemotron-3 550B | 1.4 | 2.4 |
| Mistral-Medium-3.5-128B | 2.0 | 1.2 |
表 6:未做任何编辑便终止的 SWE-Bench 运行,以及在定位阶段卡住的子集(附录 9 编码中每个带标签的轮次仍处于 Localize 阶段),分别在关闭和开启规划的情况下(T4/128k,完整工具集)。
在 32k 下,各档位的差异主要体现在轨迹长度上。没有上下文管理时,活跃的 SWE-Bench 运行占比急剧下降,四个模型的中位长度都在 20–30 轮。多数运行在 Localize 阶段终止,很少进入 Verify(图 32)。所有启用管理的档位都延长了执行,同时在相近轮次上基本保持了各阶段顺序与占比。中位长度增至约 50–180 轮,具体取决于模型和档位,运行得以推进到验证阶段。Terminal-Bench 呈现类似模式(图 36)。在 128k 下,各档位之间的差异大体消失。Nemotron-3 30B 的中位轨迹长度为 39–42 轮,Nemotron-3 550B 为 70–74 轮。每个任务的重复打补丁次数相差不到两次,而四个模型中有三个未做编辑便终止的运行占比相差不到四个百分点(图 35 和图 39;表 11 和表 12)。这些结果表明,上下文管理主要延长执行轨迹,而不会实质性改变智能体的行为。因此,在后续分析中我们把上下文管理固定为 T4/128k,以考察规划和动作空间如何影响轨迹结构。
规划让最弱模型的轨迹维持到足以尝试一次编辑。
图 8 有助于解释 Nemotron-3 30B 的性能提升。关闭规划后,SWE-Bench 的中位轨迹长度从 40 轮降到 5 轮。没有规划时,68.6% 的运行未做编辑便终止,58.4% 在 Localize 阶段终止;开启规划时这两个数字分别为 27.8% 和 10.4%(表 6)。这些结果表明,规划帮助能力最弱的模型把执行维持到完成一次初始编辑尝试,而多出来的轮次也带来了更高的成本。对 Nemotron-3 120B 而言,轨迹长度分布几乎重合,这与准确率没有提升相一致。
规划缩短了更强模型在 SWE-Bench 上的轨迹,主要减少的是编辑后的验证。
图 8 显示,规划将 Nemotron-3 550B 的轨迹长度中位数从 108 轮降至 74 轮,将 Mistral-Medium-3.5-128B 从 68 轮降至 53 轮。从阶段构成来看,这一缩减主要来自验证,而非定位或修复。与此一致,规划几乎没有改变未做任何编辑便终止、或在文件定位阶段失败的运行占比(见表 12 和表 10),却大幅减少了轮数和工具调用(见表 11)。这些结果表明,规划改善的主要是停止行为——减少了编辑后多余的验证,而非加快了定位或修复。
规划对 Terminal-Bench 成本的影响,取决于它如何改变轨迹长度的分布。
图 9 显示规划有两种相反的效果:它会延长那些本会过早终止的轨迹,同时截断过长运行的尾部。两种效果孰强孰弱,决定了图 6(b) 中各模型成本的变化方向。对 Nemotron-3 120B,规划截断了长尾运行,成本降低约 26%。Nemotron-3 550B 的效果较小(3.6%),因为其探索性尾部压缩得不那么多;Mistral-Medium-3.5-128B 的效果更大(约 40%),中等长度和长运行的轨迹都变短了。Nemotron-3 30B 则相反:规划避免了过早终止,成本因此上升 75%。
表 7:完整工具集与仅 bash 下的动作粒度(开启规划,T4/128k):SWE-Bench 上每个任务的平均重复打补丁次数(对已编辑过的文件再次编辑)与最大编辑行数的中位数,以及 Terminal-Bench 上文件写入动作中创建/替换的占比。
| 重复打补丁 | 编辑行数 | 创建(%) | |
|---|---|---|---|
| 模型 | 工具 | Bash | 工具 |
| Nemotron-3 30B | 3.3 | 0.4 | 26 |
| Nemotron-3 120B | 2.8 | 2.2 | 22 |
| Nemotron-3 550B | 4.6 | 1.5 | 18 |
| Mistral-Medium-3.5-128B | 3.0 | 1.3 | 87 |
仅用 Bash 能带来更大规模的写代码动作,交互次数也更少。
图 9 在 Terminal-Bench 上的 Nemotron-3 550B 上体现得最清楚:从完整工具集切换到仅用 bash 后,轨迹长度的中位数从 47 个动作降到 31 个,同时 Write-code 动作的占比从 16% 升到 27%,也就是说,在更短的轨迹中,更大一部分花在了产出代码上。这一模式说明,shell 让能力强的模型可以把若干底层操作打包成一条命令或一个脚本,而结构化接口则把同样的工作拆散成许多更小的交互。表 7 给出了对应的细粒度证据。在全部四个模型上,仅用 bash 都减少了反复修补已编辑文件的情况:Nemotron-3 30B 从 3.3 次重补丁降到 0.4 次,120B 从 2.8 降到 2.2,550B 从 4.6 降到 1.5,Mistral 从 3.0 降到 1.3。在 Terminal-Bench 上,仅用 bash 还让写文件转向更粗粒度的创建或替换动作,其占比在 30B 上从 28% 升到 64%,120B 从 39% 升到 76%,550B 从 51% 升到 76%,Mistral 从 28% 升到 57%。可见,预定义工具降低了单个动作的复杂度,但代价往往是:要表达同一个操作,需要更多次交互和更多轮增量修补。
5 相关工作
5.1 编程智能体
编程智能体的引擎是一个能力强的语言模型,并且越来越专门针对代码和智能体场景。近期的前沿模型,包括 Qwen3-Coder(Cao et al., 2026)、Kimi K2.5 和 K2.6(Team et al., 2026; Kimi Team, 2026)、GLM-5(Zeng et al., 2026)以及 Mistral Medium 3.5(Mistral AI, 2026),都是为代码生成和智能体用途而设计或评测的。它们的进展由基于执行的基准来衡量,例如 SWE-Bench 中的仓库级问题修复(Jimenez et al., 2024)和 Terminal-Bench 中的端到端命令行任务完成(Merrill et al., 2026)。由于这些基准评测的是完整的智能体系统,其得分把模型能力与控制循环、动作接口和上下文管理策略混在了一起。因此有必要做受控对比:固定智能体的底层框架,只改变其中一个组件。
5.2 编码 harness
编码 harness 是将 LLM 转化为 agent 的软件层,由控制循环、工具接口和上下文管理组成,agent 正是通过它作用于代码库。如今这类 harness 驱动着 Claude Code(Anthropic, 2025)、Codex(OpenAI, 2025)、OpenCode(OpenCode, 2025)、OpenHands(Wang et al., 2025)等编码 agent 产品和框架。对其设计的研究表明,决定性能的是 harness,而不只是模型(Yang et al., 2024)。后续系统为 harness 加入长期记忆(Wong et al., 2025),或引入任务图和模块化子 agent(Chen et al., 2024; Arora et al., 2024),近期的综述则梳理了这一设计空间(Rombaut, 2026)。这些系统通常优化的是打包好的整体设计。尽管有若干工作报告了局部消融结果,但很少有研究在相同的模型能力和上下文窗口预算下比较同一实现层面的干预。
因此,越来越多的工作对编码 harness 做消融,以确定哪些组件真正重要。在系统层面,Agentless(Xia et al., 2024)和 AutoCodeRover(Zhang et al., 2024)这类受限的定位—修复—验证流水线表明,不依赖高度复杂的 agent 架构也能取得很强的性能。更细粒度的研究进一步指出,最优设计取决于模型。AgentArch(Bogavelli et al., 2025)报告了因模型而异的架构偏好,一项大规模轨迹研究则发现,编码 agent 框架之间的行为差异会随模型代际而变化(Mehtiyev and Assunção, 2026)。单项干预同样可能对更强的模型变得用处不大甚至有害,软件工程中的提示工程策略就出现了这种情况(Wang et al., 2026)。与本文最接近的是 Liu(2026),他们在短时程推理任务上用全因子设计研究提示层面的脚手架,但未显式考察上下文窗口压力。我们研究的则是实现层面的规划、工作区动作接口和上下文管理策略,覆盖的编码轨迹长得多,上下文窗口可能成为硬约束,并且显式操纵可用的上下文窗口预算。这一设定使我们能够刻画这些 harness 组件的条件效应如何随模型能力和资源可用性而变化。
5.3 上下文管理
随着软件工程任务难度上升,智能体需要更多步骤才能解决,交互历史随之超出模型的上下文窗口。为此,许多研究提出了上下文管理策略,在任务表现与上下文长度之间取得平衡。第一类是静态方法,采用固定的、人工设计的策略,例如删除或截断过期内容(Xiao et al., 2024; Jiang et al., 2023)、按需从外部存储中检索早期内容(Packer et al., 2023; Park et al., 2023),以及将历史压缩为紧凑状态(Wu et al., 2021)。第二类是动态方法,通常通过强化学习训练模型自行管理上下文(Wu et al., 2025; Kang et al., 2025; Li et al., 2026; Zhang et al., 2026)。这类机制一般作为改进方案提出,并只在单一模型上评估,其核心依赖关系因此未被刻画。管理上下文的价值,既离不开可供管理的窗口有多大,也取决于模型是否足够强——强到压缩能帮上忙,而不是让它挨饿。我们精确刻画了这一依赖关系,在两个模型系列、三种模型规模上把上下文窗口从 32k 扫描到 128k token。
6 结论
我们开展了一项受控的实证研究,在四个模型和两个长时程编程基准上估计了编码 harness 三个核心组件的条件效应:上下文管理、规划与动作空间。上下文管理在上下文窗口预算紧张时最为重要;在其各策略中,T4 先做基于规则的删除,再做选择性的 LLM 摘要,从而在成功率大体相当的情况下取得最低的总成本。规划能为较弱模型提升成功率,但需付出额外成本;对较强模型则主要降低成本,成功率略有下降。预定义工具能提升 bash 控制能力较弱的模型的成功率,而仅用 bash 对具备 bash 能力的模型能以更低成本取得更高成功率,在偏 shell 的任务类型上尤为明显。轨迹分析将每种效应与一项具体的行为变化对应起来,并由此对应到该组件所针对的局限:上下文管理延长执行轨迹,而不显著改变智能体行为,在上下文预算紧张时收益最大;规划维持那些过早放弃任务的模型的轨迹,并减少那些验证过久的模型的重复验证;结构化工具为 shell 熟练度有限的模型提供支撑,而仅用 bash 则让有能力的模型在单次工具调用中合并多处代码修改。因此,harness 设计是一个条件性的系统问题:每个组件都应针对目标模型、任务类型和资源预算来选择,而不是作为默认配置照单全收。
局限性
第一,我们的结果估计的是本文所研究的特定 harness 组件与实现的条件效应,而非找出一个普遍最优的 harness。规划只通过一种 prompt 和更新机制实现,上下文管理也只采用一种基于阈值的策略,压缩参数固定不变。动作空间干预是一整套接口改动,同时改变了工具可用性、接口专用 prompt、文件状态跟踪和编辑后自动诊断,因此无法把工具数量或动作粒度的影响与接口的其他属性分离开来。 第二,设计空间的覆盖范围和统计功效都有限。受算力限制,规划和动作空间只在默认的 T4/128k 配置下做了消融;要确定它们的效应在其他组件组合和上下文预算下是否依然存在,需要做全因子实验。每个设置在每个任务上只跑一次,而 Terminal-Bench 只有 89 个任务,因此许多 Terminal-Bench 对比在配对 McNemar 检验下都达不到显著;我们关于该基准的结论依据的是各模型、各预算下方向一致,而不是单个格子显著。 最后,我们结论的外部效度受限于所评估的模型和任务。我们研究了 Nemotron-3 系列的三个规模以及 Mistral-Medium-3.5-128B,在两个长时程编码基准上评测,其中 SWE-Bench Verified 只包含 Python。模型规模只是能力的不完美代理,训练差异、此前接触工具接口的经历、原生 shell 熟练度都可能对观察到的趋势有贡献——Mistral 随基准不同而变化的接口偏好就说明了这一点。因此,本文报告的交叉点若要迁移到其他模型家族、其他 harness 实现或软件工程之外的任务类型,应先经过验证。
7 Harness Prompts
本节复现评估期间使用的固定提示词块,并说明它们在不同 harness 配置下如何组装。每次模型调用都会将一个特定于动作接口的基础提示词,与由已启用的规划组件和上下文管理组件提供的指令和提醒组合在一起。各图复现的是固定文本,而依赖运行时的字段——包括工作区路径、会话信息、当前计划、省略统计、已存储事件标识符以及运行中的摘要——则单独实例化。
7.1 系统提示词
动作空间干预会同时改变启用的工具注册表和特定于接口的系统指令。图 10 定义了配合预定义工具集使用的仓库级工作流,并明确引导模型使用相应的探索、编辑和验证工具。图 11 保留了相同的高层工作流和安全要求,但将不可用预定义工具的引用替换为与接口无关的指令。图 12 还进一步说明,所有通用工作区操作都必须通过 bash 表达,而辅助性的规划和上下文管理动作仍由各自的组件控制。图 13 和图 14 给出了各条件下所暴露工具对应的过程性规则。因此,动作空间消融既改变了工具的可用性,也改变了向模型呈现这些工具时所依据的指令。
图 10:在完整动作空间下所有配置中使用的基础系统提示词。
图 11:bash-only 动作空间条件下使用的基础系统提示词。该提示词在 bash-only 配置下取代图 10。
图 12:bash-only 配置下追加的额外系统块。
图 13:完整动作空间下提供的工具使用规则。该块在类型化 API schema 之外补充了关于并行读取操作、文件修改、shell 执行、网络访问以及工具错误恢复的指令。
图 14:仅在 bash 动作空间条件下提供的工具使用规则。该规则块由 harness 根据当前生效的工具注册表生成,tools 字段也来自同一注册表。在动作空间消融实验中,bash 和 update_plan 的规则保留,预定义工具则全部移除。
7.2 规划提示词
规划开启(Planning-on)通过一个常驻脚手架实现,由三个提示词块和一个通过 update_plan 维护的外部计划状态组成。 图 15 在系统层面定义了计划维护协议,要求对非平凡任务给出显式计划。 图 16 仅在没有创建任何计划时重复初始化要求,促使模型先建立计划再执行其他动作。 图 17 将当前存储的计划序列化进 {PLAN},并在之后每次调用模型前重新提供,而不是把旧副本追加到常驻轨迹中。规划关闭(Planning-off)会连同 update_plan 工具一起移除这三个块。
图 15:规划系统提示词。它要求模型对非平凡请求创建显式任务计划,始终保持恰好一个活动步骤,并随执行进展更新任务状态。
图 16:在尚未创建任何计划时首轮插入的规划提醒。除非任务平凡或纯属信息查询,它要求模型在采取任何其他动作前先调用 update_plan。
图 17:在之后每一轮模型调用前插入的规划提醒。占位符会被替换为当前存储的计划;该计划是重新提供的,而非追加到常驻上下文历史中。
7.3 上下文管理提示词
上下文管理模板作用于 harness 的两个阶段。图 18 展示了 M3 摘要被触发时,在单独一次 LLM 调用中发出的提示词。harness 提供最旧的、被选中的中间区域事件以及已有的滚动摘要,生成的文本会在后续 agent 输入中替换掉这些事件。图 19 展示了被省略的观测结果和滚动摘要如何呈现给任务求解模型。T1 收到的是不可恢复的省略占位符,而 T2 和 T4 还会收到 recall_event 所需的已存储事件标识符。滚动摘要紧跟在保留的前言之后插入。
图 18:摘要机制(M3)使用的提示词。harness 会在一次单独调用中,对中间区域最早被选中的事件调用同一个模型。固定标题支持对滚动摘要进行增量维护,因为上一次的摘要会随新选出的事件一起提供给模型并据此修订。
图 19:上下文管理插入的文本片段。前两个片段替换被省略的观测结果,并报告被移除内容的数量。启用 M2 时所用的变体还会给出 recall_event 所需的事件标识符。第三个片段包裹滚动摘要,该摘要替换它所覆盖的事件,并紧接在前言之后插入。
7.4 卡死检测提示词
卡死检测在每个实验条件下都以相同方式启用,因此属于固定的执行基座。harness 将连续若干次最近的工具调用定义为一个 streak:这些调用具有相同的工具名和逐字节相同的参数;参数不同的调用(例如在新偏移量处进行的分页读取)会终止该 streak。图 20 给出了两条提醒,依据重复调用只是返回已有结果还是以相同方式持续失败来选择。当 streak 达到五次任意状态的相同调用,或五次相同的失败调用时,每条 streak 插入一次提醒;运行时,{TOOL} 和 {N} 会被替换为重复的工具名和当前 streak 的长度。如果相同的失败 streak 继续到八次调用,运行会以专门的停止原因终止,而不是一直跑到步数预算耗尽。为此,权限拒绝不计为失败。
图 20:卡死检测机制使用的提醒。harness 识别具有相同工具名和参数的调用 streak,并根据这些调用是否返回相同的失败来选择提醒。每条 streak 插入一次提醒。相同的失败 streak 若继续增长,会在步数预算耗尽之前终止运行。
8 工具说明
表 1 汇总了工具的可用性及主要参数。每个面向模型的工具定义由工具名称、带类型的参数 schema 和自然语言描述组成。以下各图复现了评测期间实际使用的描述字符串,包括其使用协议、错误行为和副作用。预定义工具条件下会开放文件、搜索、执行和网络接口,而仅 bash 条件则移除预定义的工作区工具,只保留 bash。辅助工具 update_plan 和 recall_event 分别由规划设置和上下文管理设置独立控制。
8.1 文件输入与输出
图 21–23 复现了预定义工具条件下可用的三种结构化文件操作。图 21 定义了带行号的有界文件访问,并在会话级文件状态中记录一次完整读取。图 22 用于创建新文件,或执行经明确授权的整文件替换;图 23 则对已有文件施加字节级精确的定向替换。这两个修改类工具在改动已有文件前都要求存在一次符合条件的已记录读取,并在成功后更新 harness 文件状态。通过 bash 发出的等效修改不参与这条状态跟踪与自动诊断路径。
图 21:read_file 的工具调用描述。
图 22:write_file 的工具调用描述。
图 23:edit_file 的工具调用描述。
8.2 搜索
图 24–26 复现了预定义工具条件下可用的三种只读发现接口。图 24 返回目录的有界树状表示,图 25 按路径模式定位文件,图 26 按正则表达式搜索文件内容。这些工具不会改动工作区或文件状态,彼此独立时可并发调用,并一致地应用所配置的工作区忽略模式。
图 24:list_files 的工具调用描述。
图 25:glob_files 的工具调用描述。
图 26:grep_text 的工具调用描述。
8.3 执行与网络访问
图 27 和图 28 展示了两种动作空间条件下,同一个 shell 执行器面向模型的两份不同描述。两种条件下,命令都通过 /bin/sh -c 执行。预定义工具的描述把常见的文件与搜索操作引导到结构化接口,而仅 bash 的描述则要求所有通用工作区交互都通过 shell 命令表达,并要求模型显式验证修改。图 29 描述的是具体 URL 抓取,仅在预定义工具条件下可用。
图 27:预定义工具集条件下提供给 bash 的工具调用描述。
图 28:仅 bash 条件下 bash 面向模型的替代描述。
图 29:web_fetch 的工具调用描述。
8.4 规划与上下文召回
本小节中的工具属于辅助组件接口,而非预定义的工作区动作。图 30 描述 update_plan:只要启用规划就会暴露,它会整体替换内存中的计划,但不修改工作区文件。图 31 描述 recall_event:仅在 T2 和 T4 下暴露,按事件标识符检索已存储的历史内容。一旦启用,这两个工具在任一动作空间条件下都保持可用。
图 30:update_plan 的工具调用描述。
图 31:recall_event 的工具调用描述。
9 轨迹分析
我们不只以最终任务是否成功来评估 harness,而是把每条 agent 轨迹拆解为可解释的行为类别与失败类别。这些分析考察轨迹存活情况、行为构成、动作粒度,以及未解决的运行终止于哪个阶段。我们借此判断观察到的行为变化是否与 §4 提出的机制一致。附录围绕三套互补的标注方案展开,随后是评判模型验证、各基准的轨迹结果、汇总统计、recall 事件的使用情况,以及完整的评判提示词。
9.1 标注方案
我们采用三种互补的标注方案。失败阶段归因用于识别未解决的 SWE-Bench 修复轨迹中最早失败的阶段。两种行为编码则分别刻画 agent 在 SWE-Bench 和 Terminal Bench 中如何将动作分配到问题求解过程的各个阶段。
9.1.1 SWE-Bench 失败阶段归因
对于未解决的 SWE-Bench 轨迹,我们为其标注一个失败阶段,对应修复过程中最早失败的位置。这些阶段遵循自然的调试流程:文件定位、行定位、补丁实现和验证。采用最早失败原则,可以确保测试失败等下游症状不会掩盖更早出现的定位或实现错误。
9.1.2 SWE-Bench 行为编码
我们用 SWE-Bench 行为编码来刻画 agent 在每一轮的主要工作目的。基于 Mehtiyev 和 Assunção(2026)的轨迹分析框架,我们将每一轮归入五个阶段之一:定位、复现、修复、验证以及其他辅助行为。这些标签刻画了 agent 如何在调试过程中分配精力;五个阶段符号及其在轨迹中的来源见表 8。
| 类别 | 符号 | 含义 | 轨迹中的来源 |
|---|---|---|---|
| Localize | L | 定位相关代码 | file read、grep、glob、list、find |
| Reproduce | R | 构建/运行复现脚本 | 创建 / 编辑 / 运行复现文件 |
| Fix | F | 修补源码 | 编辑仓库文件 |
| Verify | V | 运行验证 | 测试运行(通过、失败或报错) |
| Other | O | 环境配置与辅助 | pip、conda、recall_event、submit、…… |
表 8:SWE-Bench 轨迹编码:五个阶段符号。
9.1.3 Terminal-Bench 动作级编码
我们用 Terminal-Bench 动作级编码来分类每个 shell 动作的语义意图。与标注整轮的 SWE-Bench 编码不同,该方案逐个标注每次工具调用。我们定义了 10 个细粒度动作类型符号,并将其归入四个更高层级的阶段:理解、代码编写、验证以及其他辅助操作。完整的 10 符号动作分类体系见表 9。
| 类别 | 符号 | 含义 | 轨迹中的来源 |
|---|---|---|---|
| 理解 | I | 查看文件内容 | cat、head、tail、less、sed -n |
| S | 搜索 / 发现 | ls、find、grep | rg、which | |
| 编写代码 | C | 创建(新文件) | heredoc 写入、touch、tee 到新路径 |
| M | 修改(已有文件) | sed -i、patch、追加重定向 | |
| E | 环境搭建 | pip、apt、conda、make、build | |
| 验证 | X | 运行自己的代码 | python foo.py、./run.sh、编译后的二进制文件 |
| T | 测试(真实框架) | pytest、unittest、npm test、go test | |
| V | 校验产物 | diff、md5sum、重新读取输出文件 | |
| 其他 | N | 导航 | cd、pushd、仅调用 pwd |
| G | 通用 / 其他 | git、echo、export、rm、shell 杂项、…… |
表 9:Terminal-Bench 轨迹编码:10 种动作类型符号,归入四个阶段。
9.2 评判设置与人工验证
我们使用基于 LLM 的评判器完成 SWE-Bench 轮次用途分类、SWE-Bench 失败阶段归因和 Terminal-Bench 动作用途分类。对应的提示词见图 40、41、42。所有评判调用均使用 GPT-5.5,推理强度设为 high,解码温度为 0.6。
我们通过三名人工标注者验证 LLM 评判器的标注。我们从 200 条轨迹中抽样,平均分成三个互不重叠的子集,每人负责一个,其中一人比其他两人多标注一条轨迹;每名标注者标注自己子集中的每个单元。验证共覆盖 15,610 个标注单元,包括 5,306 个 Terminal-Bench 动作标签、10,254 个 SWE-Bench 动作标签和 50 个 SWE-Bench 失败阶段诊断。对每个子集和每种单元类型,标注者使用与 LLM 评判器相同的标签集独立标注。我们以原始一致率和 Cohen’s κ\kappa 比较人工标签与评判器输出。
总体而言,各标注者的评判器—人工一致率都很高。各子集的总体一致率在 88.7% 到 98.4% 之间,Cohen’s κ\kappa 在 0.858 到 0.980 之间。三个子集汇总后,原始一致率约为 94.2%,Cohen’s κ\kappa 的加权均值为 0.929。SWE-Bench 动作标签的一致率尤其高,原始一致率在 92.7% 到 99.0% 之间,κ\kappa 在 0.881 到 0.984 之间。Terminal-Bench 动作标签同样表现出较高一致率,原始一致率在 79.8% 到 97.3% 之间,κ\kappa 在 0.758 到 0.965 之间。失败阶段诊断的一致率也很高,在 87.5% 到 100.0% 之间,κ\kappa 在 0.813 到 1.000 之间。
这些结果表明,LLM 评判器与独立人工标注高度一致,无论是在基准特定的动作分类体系上,还是在失败阶段标签上。这支持使用评判器生成的轨迹标注,将 §4 中的行为分析扩展到全部实验轨迹。
9.3 SWE-Bench 轨迹结果
9.3.1 失败阶段结果
SWE-Bench 失败阶段评判器仅用于未解决的轨迹。它接收 issue 描述、gold patch 修改的源文件、agent 仅含源码的 patch,以及轨迹的最后一部分,然后判定最早未能正确完成的阶段。表 10 报告了每个 128k 设置下四个阶段的分布。补充的终止统计来自行为编码而非评判器,记录一次运行在终止前是否编辑过文件、停止时处于哪个阶段,单独列于表 12。
有三个模式值得注意。第一,主要失败阶段随模型能力而变化:对 Nemotron-3 30B,超过一半的未解决运行失败于文件定位;而对 Nemotron-3 550B 和 Mistral-Medium-3.5-128B,大多数运行找到了正确的文件和行,但失败于 patch 实现。第二,从 Nemotron-3 30B 中移除规划或预定义工具,会把文件定位的占比分别从 56.3% 推高到 73.8% 和 76.6%,这与 §4 中描述的过早终止行为一致。第三,Mistral 的 bash-only 设置是唯一一个文件定位失败率大幅上升的强模型配置,从 16.0% 升至 41.4%,说明其在 bash-only 下 23.2 个百分点的下降主要源自修复步骤之前。在各上下文管理层级之间,阶段分布变化不大,因此 128k 下的层级比较反映的是失败运行数量上的细微差异,而非失败位置的差异。
表 10:在 128k 上下文窗口预算下,由 LLM 评判器判定的未解决 SWE-Bench 运行的失败阶段分布(图 41)。Unres. 是 500 次运行中未解决的数量。四个阶段列给出未解决运行中最早失败阶段为文件定位、行定位、patch 实现或验证的百分比,每行合计为 100;少数评判器无法扫描其轨迹的未解决运行(每个设置至多三个)不计入百分比。
| 最早失败的阶段(%) | |||
|---|---|---|---|
| 模型 | 设置 | 未解决 | 文件定位 |
| Nemotron-3 30B | T0 | 376 | 51.3 |
| T1 | 375 | 49.5 | 12.6 |
| T2 | 370 | 54.5 | 12.5 |
| T3 | 382 | 55.1 | 9.2 |
| T4 | 374 | 56.3 | 9.1 |
| T4 无计划 | 432 | 73.8 | 7.0 |
| T4 仅 bash | 449 | 76.6 | 9.2 |
| Nemotron-3 120B | T0 | 299 | 40.1 |
| T1 | 278 | 42.6 | 12.3 |
| T2 | 274 | 37.2 | 13.1 |
| T3 | 280 | 38.6 | 11.4 |
| T4 | 280 | 44.3 | 8.9 |
| T4 无计划 | 267 | 40.1 | 13.5 |
| T4 仅 bash | 288 | 42.9 | 11.1 |
| Nemotron-3 550B | T0 | 201 | 20.9 |
| T1 | 174 | 22.4 | 13.2 |
| T2 | 163 | 17.2 | 19.6 |
| T3 | 171 | 21.1 | 15.8 |
| T4 | 171 | 16.4 | 11.7 |
| T4 无计划 | 161 | 17.5 | 16.9 |
| T4 仅 bash | 153 | 20.5 | 14.6 |
| Mistral-Medium-3.5-128B | T0 | 163 | 20.2 |
| T1 | 157 | 14.7 | 18.6 |
| T2 | 165 | 19.4 | 10.3 |
| T3 | 167 | 22.8 | 17.4 |
| T4 | 157 | 16.0 | 16.7 |
| T4 无计划 | 155 | 20.3 | 17.6 |
| T4 仅 bash | 273 | 41.4 | 9.2 |
9.3.2 行为画像
图 32–35 固定了规划方式与预定义工具集,仅改变上下文管理层级和上下文窗口预算。列对应不同模型,行对应 T0–T4。在第 tt 轮,堆叠总高度表示仍在进行的轨迹占比,彩色色带则将这些活跃轨迹划分为 Localize、Reproduce、Fix、Verify 和 Other 五类行为。竖直虚线标出轨迹长度的中位数,右上角的标注给出成功率和每任务平均成本。这些画像仅是对智能体行为分布的描述性汇总。
图 32:32k 上下文管理策略下的 SWE-Bench 轨迹分布。
图 33:64k 上下文管理策略下的 SWE-Bench 轨迹分布。
图 34:96k 上下文管理策略下的 SWE-Bench 轨迹分布。
图 35:128k 上下文管理策略下的 SWE-Bench 轨迹分布。
9.4 Terminal-Bench 轨迹结果
图 36–39 展示了 Terminal-Bench 的轨迹分布,排版与 SWE-Bench 一致。列对应不同模型,行对应 T0–T4,规划与预定义工具集保持不变。在第 tt 轮,总高度表示仍然活跃的轨迹占比,彩色色带则将活跃轨迹划分为 Understand、Write Code、Verify 和 Other 四类行为。
图 36:32k 上下文管理策略下的 Terminal-Bench 轨迹分布。
图 37:64k 上下文管理策略下的 Terminal-Bench 轨迹分布。
图 38:96k 上下文管理策略下的 Terminal-Bench 轨迹分布。
图 39:128k 上下文管理策略下的 Terminal-Bench 轨迹分布。
9.5 128k 下的轨迹级统计
表 11 和表 12 给出了正文轨迹级摘要背后的完整 128k 统计数据。表 11 在表 7 的基础上补充了轨迹长度、工具调用次数以及全部五个上下文管理层级;表 12 则在表 6 的基础上补充了其余层级、仅 bash 的消融实验以及对应的 Terminal-Bench 各列。终止阶段直接由行为编码读出:在 SWE-Bench 上,若一次运行不含 Fix 轮,则计为未编辑即终止;若在此基础上其所有已标注轮次均为 Localize 或 Other 轮,则计为停滞在定位阶段。在 Terminal-Bench 上,对应的列使用动作级编码中的写代码阶段(Create 或 Modify 动作)和理解阶段(Inspect 或 Search 动作)。
上下文管理分层几乎不改变 128k 下的轨迹形态。
在 T0–T4 之间,各模型的轨迹长度中位数与工具调用平均次数只在很窄的区间内波动(表 11):Nemotron-3 30B 的 SWE-Bench 中位数始终在 39 到 42 轮之间,Nemotron-3 550B 在 70 到 74 轮之间;重新打补丁的次数每任务相差不到两次,编辑规模中位数相差几行。终止行为同样稳定(表 12):四个模型中有三个,SWE-Bench 运行中未做任何编辑便终止的比例在各层级间相差不到四个百分点,Nemotron-3 120B 相差约八个百分点。正因如此,§4 才能在 128k 下延长执行轨迹而不显著改变智能体行为;层级间的差异只在窗口成为瓶颈时才会显现,例如 32k 配置(图 32 和图 36)。
规划与动作空间才是改变轨迹的干预项。
去掉规划后,Nemotron-3 30B 的 SWE-Bench 轨迹中位数塌缩到 5 轮,未编辑即终止的比例从 27.8% 升到 68.6%;而对 Nemotron-3 550B 和 Mistral-Medium-3.5-128B,轨迹反而变长(中位数分别从 74 轮增至 108 轮、从 53 轮增至 68 轮),未编辑终止率仍低于 3%。这正是 §4 讨论的两种情形。仅用 bash 会减少全部四个模型的重复打补丁,但对编辑规模的影响因模型而异:Nemotron-3 550B 的最大编辑中位数从 18 行增至 54 行,Nemotron-3 30B 从 26 行降至 13 行,Nemotron-3 120B 基本不变,Mistral-Medium-3.5-128B 从 87 行降至 68 行——该模型在预定义工具下的编辑本就偏大。在 Terminal-Bench 上,仅用 bash 时所有模型的文件写入动作中「创建或替换」的占比都上升,且 Nemotron-3 30B 的仅 bash 配置拥有全部配置中最高的无代码终止率(22.5%),与 §3.2 描述的界面外工具输出一致。
表 11:128k 上下文窗口预算下的完整动作粒度统计,对应表 7。各行包括带规划与完整工具集的 T0–T4 上下文管理层级,随后是 T4 无规划与仅 bash 的消融。Re-patch 统计对已编辑文件的重复编辑次数,edit lines 为最大编辑行数的中位数,create share 为 Terminal-Bench 文件写入动作中创建或替换文件的比例。
| SWE-Bench Verified | Terminal-Bench | ||
|---|---|---|---|
| 模型 | 设置 | SR (%) | 中位轮数 |
| Nemotron-3 30B | T0 | 24.8 | 39 |
| T1 | 25.0 | 42 | 54.5 |
| T2 | 26.0 | 39 | 54.4 |
| T3 | 23.6 | 41 | 56.0 |
| T4 | 25.2 | 40 | 54.6 |
| T4 无规划 | 13.6 | 5 | 9.8 |
| T4 仅 bash | 10.2 | 10 | 22.3 |
| Nemotron-3 120B | T0 | 40.2 | 33 |
| T1 | 44.4 | 34 | 69.5 |
| T2 | 45.2 | 32 | 57.6 |
| T3 | 44.0 | 32 | 70.3 |
| T4 | 44.0 | 33 | 65.8 |
| T4 无规划 | 46.6 | 27 | 46.0 |
| T4 仅 bash | 42.4 | 41 | 84.6 |
| Nemotron-3 550B | T0 | 59.8 | 70 |
| T1 | 65.2 | 71 | 91.7 |
| T2 | 67.4 | 73 | 96.4 |
| T3 | 65.8 | 74 | 95.8 |
| T4 | 65.8 | 74 | 98.4 |
| T4 无规划 | 67.8 | 108 | 130.3 |
| T4 仅 bash | 69.4 | 55 | 67.1 |
| Mistral-Medium-3.5-128B | T0 | 67.4 | 50 |
| T1 | 68.6 | 51 | 56.6 |
| T2 | 67.0 | 50 | 55.6 |
| T3 | 66.6 | 51 | 57.1 |
| T4 | 68.6 | 53 | 57.8 |
| T4 无规划 | 69.0 | 68 | 75.3 |
| T4 仅 bash | 45.4 | 47 | 50.2 |
表 12:128k 上下文窗口预算下的完整终止阶段统计,对应表 6。终止相关各列由表 8 和表 9 中的行为编码推导而来:W/o edit(W/o code)指在没有任何 Fix 轮次(没有任何 Create 或 Modify 动作)的情况下终止的运行占比;At loc.(At underst.)指其中除 Other 阶段的记账动作外,始终未推进到 Localize 阶段(Understand 阶段,即 Inspect 和 Search 动作)之外的运行占比;Edited(Wrote)则指确实编辑了源码(写入了代码)但仍未解决的运行占比。
| SWE-Bench Verified | Terminal-Bench | ||
|---|---|---|---|
| 终止 (%) | |||
| 模型 | 设置 | W/o edit | At loc. |
| Nemotron-3 30B | T0 | 26.4 | 9.6 |
| T1 | 24.6 | 7.0 | 51.0 |
| T2 | 27.6 | 10.4 | 46.0 |
| T3 | 26.2 | 8.2 | 50.2 |
| T4 | 27.8 | 10.4 | 47.0 |
| T4 w/o plan | 68.6 | 58.4 | 18.0 |
| T4 bash only | 75.4 | 47.6 | 15.0 |
| Nemotron-3 120B | T0 | 18.6 | 16.2 |
| T1 | 16.6 | 11.8 | 39.6 |
| T2 | 21.6 | 13.0 | 33.4 |
| T3 | 20.2 | 13.4 | 36.2 |
| T4 | 24.4 | 17.8 | 31.8 |
| T4 w/o plan | 15.6 | 11.0 | 38.4 |
| T4 bash only | 24.4 | 12.4 | 33.4 |
| Nemotron-3 550B | T0 | 1.8 | 1.6 |
| T1 | 2.2 | 0.6 | 32.6 |
| T2 | 2.4 | 0.4 | 30.2 |
| T3 | 2.0 | 0.4 | 32.2 |
| T4 | 2.4 | 0.6 | 31.8 |
| T4 w/o plan | 1.4 | 0.2 | 30.8 |
| T4 bash only | 1.6 | 0.4 | 29.0 |
| Mistral-Medium-3.5-128B | T0 | 1.6 | 0.4 |
| T1 | 1.8 | 0.6 | 29.6 |
| T2 | 2.2 | 0.8 | 31.0 |
| T3 | 2.4 | 1.0 | 31.2 |
| T4 | 1.2 | 0.6 | 30.2 |
| T4 w/o plan | 2.0 | 1.0 | 29.2 |
| T4 bash only | 32.8 | 17.8 | 22.0 |
9.6 recall_event 的使用情况
表 13 给出了 §3.2 中各配置的完整调用率。这里统计的是每个任务调用 recall_event 的平均次数,而非使用 recall 的轨迹占比,因为一条轨迹可能多次调用该工具。
表 13:在启用 recall 的上下文管理策略(T2 和 T4)下,每个任务调用 recall_event 的平均次数,按模型和上下文窗口预算分组。T4/128k 下全部 16 个规划与动作空间消融配置的调用次数均为零,故省略。
| SWE-Bench Verified | Terminal-Bench | ||
|---|---|---|---|
| 模型 | 层级 | 32k | 64k |
| Nemotron-3 30B | T2 | 0.146 | 0.004 |
| T4 | 0.472 | 0.032 | |
| Nemotron-3 120B | T2 | 0.206 | 0.008 |
| T4 | 0.318 | 0.010 | |
| Nemotron-3 550B | T2 | 0.000 | 0.000 |
| T4 | 0.006 | 0.000 | |
| Mistral-Medium-3.5-128B | T2 | 0.000 | 0.000 |
| T4 | 0.010 | 0.000 |
9.7 评判提示词
图 40、41 和 42 完整复现了用于 SWE-Bench 轮次目的分类、SWE-Bench 失败阶段归因和 Terminal-Bench 动作目的分类的提示词。
图 40:用于 SWE-Bench 轨迹编码的 LLM 评判提示词。评判模型将每个轮次归入表 8 中五个阶段符号之一。
图 41:用于 SWE-Bench 失败阶段归因的 LLM 评判提示词。对于每条未解决的轨迹,评判模型给出修复流程中最早失败的阶段:文件定位、行定位、补丁实现或验证。
图 42:用于 Terminal-Bench 动作级编码的 LLM 评判提示词。评判模型将每个基于 shell 的动作归入表 9 中 10 个细粒度动作类型符号之一。
完整参考文献列表见原论文。