コーディングエージェント向けハーネス設計の実証研究
コーディングフレームワークは、自律コーディングエージェントがモデル能力を長周期ソフトウェアエンジニアリング性能へと変換する方法を決定するが、通常はモノリシックシステムとして評価される。本研究では実行ループを固定し、SWE-Bench VerifiedとTerminal-Bench上で4つのモデルに対して3つのコンポーネント(計画、行動空間、コンテキスト管理)を一つずつ変更する。
日本語
コピー
コーディングエージェントのハーネス設計に関する実証研究
Run-Ze Fan, Zihao Zhang, Simin Ma, Yebowen Hu, Shouju Wang, Kaiqiang Song, Fei Liu, Hamed Zamani, Xiaoyang Wang
概要
コーディングハーネスは、自律型コーディングエージェントがモデルの能力を長期的なソフトウェアエンジニアリング性能へとどう変換するかを決める。しかし既存研究の多くはハーネスをひとつのまとまりとして評価しており、個々のコンポーネントがそれぞれ何を担っているのかは明らかでない。コンポーネント単位で比較するため、私たちは軽量なコーディングハーネスを用いてこの問題を調べた。実行ループは固定し、変えるのは計画・行動空間・コンテキスト管理の3つだけである。SWE-Bench Verified と Terminal-Bench 2.1 で4つのモデルを評価し、176組の対応する設定をカバーした。内訳は5種類のコンテキスト管理戦略、4段階のコンテキストウィンドウ予算、そして計画と行動空間に対する的を絞ったアブレーションである。わかったことは次の4点。(1) コンテキストウィンドウの予算が厳しいほどコンテキスト管理の価値は大きくなり、その利得は主にコンテキスト溢れによる失敗を避けられることから来る。(2) LLM による要約の前にルールベースの切り詰めを行う方式が、コンテキスト管理戦略の中で総合的に最も効率がよい。一方、切り詰めた内容を復元可能にすると余分な仕組みが増えるだけで、モデルがほとんど使わず、精度も上がらない。(3) 計画の役割はモデル能力によって変わる。弱いモデルには精度を支える要素であり、強いモデルにはコスト削減にとどまり精度はあまり変わらない。(4) 事前定義されたツールは bash 能力の弱いモデルの性能を引き上げる。bash 能力の強いモデルは bash インターフェースだけで有効に働き、コストは明確に低い。コマンドライン中心のタスクでは特にそうである。 軌跡レベルの分析がこれらの効果を説明する。コンテキスト管理は実行軌跡を長くするが、エージェントの振る舞いを大きく変えるわけではない。計画が変えるのは軌跡がどこで止まるかである。行動空間が変えるのはコードが書き出される粒度である。これらの知見は、モデルと予算の両方を見据えたハーネス設計の根拠になり、今後のハーネスコンポーネントを評価するためのモジュール式の枠組みも提供する。
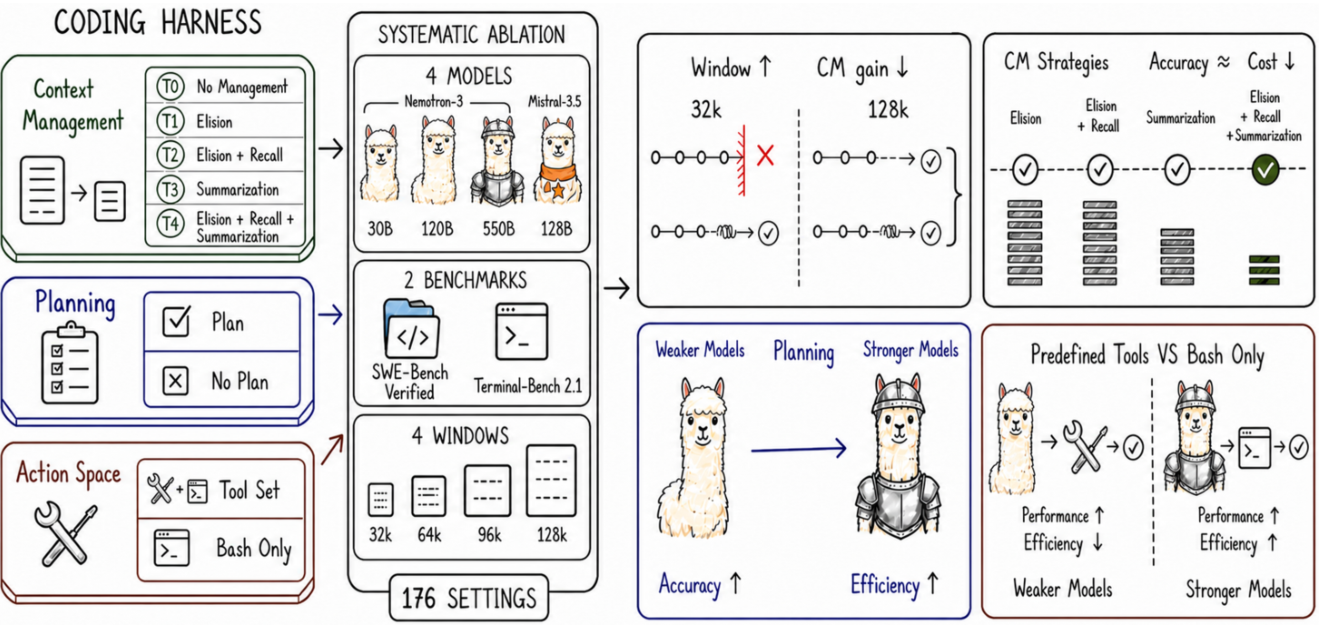
図1:コーディングハーネスの分解。コンテキスト管理・計画・行動空間を体系的にアブレーションし、コンテキスト予算・モデル能力・タスク種別にそれぞれ依存する4種類の条件付き効果を明らかにした。
1 はじめに
大規模言語モデル(LLM)は、GitHub issue のクローズ(Jimenez et al., 2024)やエンドツーエンドのターミナルタスクの完了(Merrill et al., 2026)など、実際のソフトウェアエンジニアリングタスクを自律的に解くためにますます使われるようになっている。この性能は、LLM をコーディングハーネスの中で動かすことから生まれる。ハーネスとはソフトウェアの層であり、その各コンポーネントがエージェントの振る舞いの異なる側面に関与する。計画の足場はタスクの構造を保ち、行動インターフェースはモデルの意図を実行可能な操作にどう変換するかを決め、コンテキスト管理戦略は限られたウィンドウの下でどの対話履歴を使える状態に保つかを決める(Yang et al., 2024; Wang et al., 2025; Rombaut, 2026)。これらの選択は取るに足らない実装の詳細ではない。モデルを固定したままハーネスを替えると、モデルの性能は大きく変わりうる(Yang et al., 2024; Wang et al., 2024; Lewis, 2026)。
コーディングハーネスが実証的に成功しているにもかかわらず、多くの既存研究はいまなおハーネスを完全なシステムとして評価している(Wang et al., 2025; Wong et al., 2025; Xia et al., 2024; Arora et al., 2024)。たとえば Cao et al. (2026) のハーネス横断評価は、評価したハーネスの中で Claude-Opus-4.5 は OpenHands との組み合わせが最もよく、Claude-Sonnet-4.5 は SWE-Agent との組み合わせが最もよいと報告している。つまりハーネスの好みはモデルによって変わる。しかし完全なハーネス同士の比較は複数の仕組みが混ざり合っており、2つのエージェントの性能差から、利得が計画から来たのか、ツール設計から来たのか、コンテキスト管理から来たのか、それとも基盤モデルとの相互作用から来たのかはわからない。ここから研究上の問いが生じる。ハーネスのコンポーネントはあらゆる設定で普遍的に役立つのか、それとも各コンポーネントの有効性はモデル能力・タスク種別・リソース予算に依存するのか。既存研究はモデルをまたいだコンポーネントの相互作用やアーキテクチャの選択を調べてきたが(Liu, 2026; Bogavelli et al., 2025; Mehtiyev and Assunção, 2026; Rombaut, 2026)、長時程のコーディングタスクにおいて、明示的なコンテキストウィンドウのスイープと同一系列モデルの規模軸を同時に組み合わせ、実装レベルの計画・ワークスペース行動インターフェース・コンテキスト管理戦略を統合的に特徴づけたものはない。したがって既存の証拠では、どのコンポーネントがハーネス間の差を生んでいるのかも、それらのコンポーネントがいつ移転可能なのかも説明できない。
この課題に対処するため、私たちはコーディングハーネスを構築した。外側の実行ループは固定したまま、計画・行動空間・コンテキスト管理という3つの中核コンポーネントだけを変える。この3つに注目したのは、既存システムがこれらを長時程コーディングエージェントの補完的な要件として扱っているからである。計画はタスクの進行を維持するために使われ(Bairi et al., 2024)、行動空間はモデルの意図を実行可能なワークスペース操作に変換し(Yang et al., 2024; Wang et al., 2024)、コンテキスト管理は軌跡が伸び続ける中で有用な情報を保つ(Packer et al., 2023; Wu et al., 2025)。その他の実行機構、たとえば権限処理、編集後の診断、スタック検出は固定し、統一された実行基盤とする。計画コンポーネントは明示的なタスク計画を保持し、モデルは軌跡の途中でいつでも更新できる。行動空間は、事前定義されたワークスペースツール群を公開するか、bash インターフェースだけを提供するかのどちらかである。コンテキスト管理については5つの戦略を定義した。T0 はターンをまたぐ追加の圧縮を行わず、コンテキストウィンドウを超えた時点で終了する。T1 は古くなったツール観測結果を破棄する。T2 は外部ストレージと recall_event を追加し、破棄した観測結果を復元できるようにする。T3 は LLM による要約を使うが、破棄はしない。T4 は破棄・復元可能な外部ストレージ・要約を段階的な戦略に組み合わせ、まず破棄を実行し、次に要約を呼び出す。このモジュール式の設計により、モデル・タスク・実行ループ・アブレーションしていないコンポーネントを固定したまま、実装された各介入の条件付き効果を見積もることができる。
この harness を用いて、Nemotron-3(Blakeman et al., 2025)の 3 つの規模——30B、120B、550B——を同一モデルファミリー内の能力軸として評価し、Mistral-Medium-3.5-128B(Mistral AI, 2026)をファミリーをまたいだ対照とした。 これらのモデルは能力と対話スタイルを探るプローブとして扱うものであり、長期的な最適化目標ではない。 したがって本稿の知見は、同じコンテキスト、行動空間、計画のトレードオフに直面する将来のモデルにも移せる診断材料となる。 評価は補完的な 2 つの長時程 coding ベンチマークで行った。SWE-Bench Verified(Jimenez et al., 2024)はリポジトリレベルの issue 解決能力を、Terminal-Bench 2.1(Merrill et al., 2026)はエンドツーエンドのターミナルタスク完了能力を測る。コンテキスト管理については、32k、64k、96k、128k token の 4 つのコンテキストウィンドウ予算で 5 つの戦略を比較した。さらに 128k コンテキストウィンドウ予算、T4 コンテキスト管理戦略の条件下で計画と行動空間をそれぞれアブレーションし、合計 176 通りの実験設定を得た。成功率とコストに加えて軌跡レベルの分析を行い、各介入がタスクの進展、終了挙動、コンテキスト使用、ツール呼び出しをどう変えるかを明らかにした。主な知見は以下のとおりである。
- •
コンテキスト管理が最も効くのはコンテキストウィンドウ予算が厳しいときである。コンテキストのオーバーフローによる実行の早期終了を防ぎ、agent がコード修正と検証の段階まで進めるようにする。コンテキストウィンドウが広がるにつれ、精度面の利得は徐々に小さくなる。
- •
LLM 要約の前に段階的な省略を行う T4 が、コンテキスト管理戦略の中で最も効率がよい。T4 はピークコンテキストを妥当な範囲に抑え、要約呼び出しへの依存を減らしつつ、平均成功率は他の管理系戦略と同等だった。対照的に、省略を可逆にする recall 機構はほとんど発火せず、省略以上の精度向上ももたらさなかった。
- •
モデル能力が上がるにつれ、計画の役割は精度の足場から効率の補助へと変わる。弱いモデルでは、計画によって軌跡が 1 回の編集を試みるのに十分な長さ維持され、追加コストと引き換えに成功率が上がる。強いモデルでは、主に編集後の余分な検証を削り、精度をわずかに変えるだけでコストを下げる。
- •
事前定義ツールは bash 能力の弱いモデルの性能を引き上げ、bash のみのインターフェースは bash 能力の強いモデルのコストを下げる。事前定義ツールは shell コマンドへの依存を減らし、bash 能力の強いモデルは 1 回の呼び出しで複数の操作を組み合わせられる。そこから生じる精度とコストのトレードオフはタスク種別によって異なる。
2 Harness 設計
各 harness コンポーネントの寄与がモデルと計算予算によってどう変わるかを調べるため、軽量な harness をゼロから構築した。既存の harness の多くは実装上の選択が絡み合っており、個別に調整するのが難しい。我々のモジュール設計では各コンポーネントを独立に設定・組み合わせできるため、コンポーネント単位の制御された分析が可能になる。この harness は ReAct ループ(Yao et al., 2022)に従い、各ターンは推論ステップ、行動、観測からなる(図 2)。我々は計画(§2.1)、行動空間(§2.2)、コンテキスト管理(§2.3)の 3 コンポーネントを以下のように変える。ワークスペースアクセス制御、編集後の診断、スタック検出といった他の支援コンポーネントは各アブレーションで固定し、各介入の効果を切り分ける。
2.1 計画
計画は、モデル自身が維持する、タスク進捗の明示的で永続的な表現をモデルに与える。有効にすると、システム指示がプロトコルを定義し(図 15)、最初のターンで行動前に初期計画を出すようモデルに促す(図 16)。モデルは update_plan ツールでこの計画を維持する(図 30)。以降のターンでは計画がモデル入力に追加されるが、対話履歴には書き込まれない(図 17)。これらのブロックが実行時にどう組み立てられるかは付録 7.2 で説明する。計画を無効にした設定では、計画の指示、リマインダー、計画の注入、およびこのツールを除き、実行ループ、行動インターフェース、コンテキスト管理は変えない。したがって本稿の結果が推定するのは、この永続的な計画 scaffolding の効果であり、汎用的な推論戦略としての計画の効果ではない。
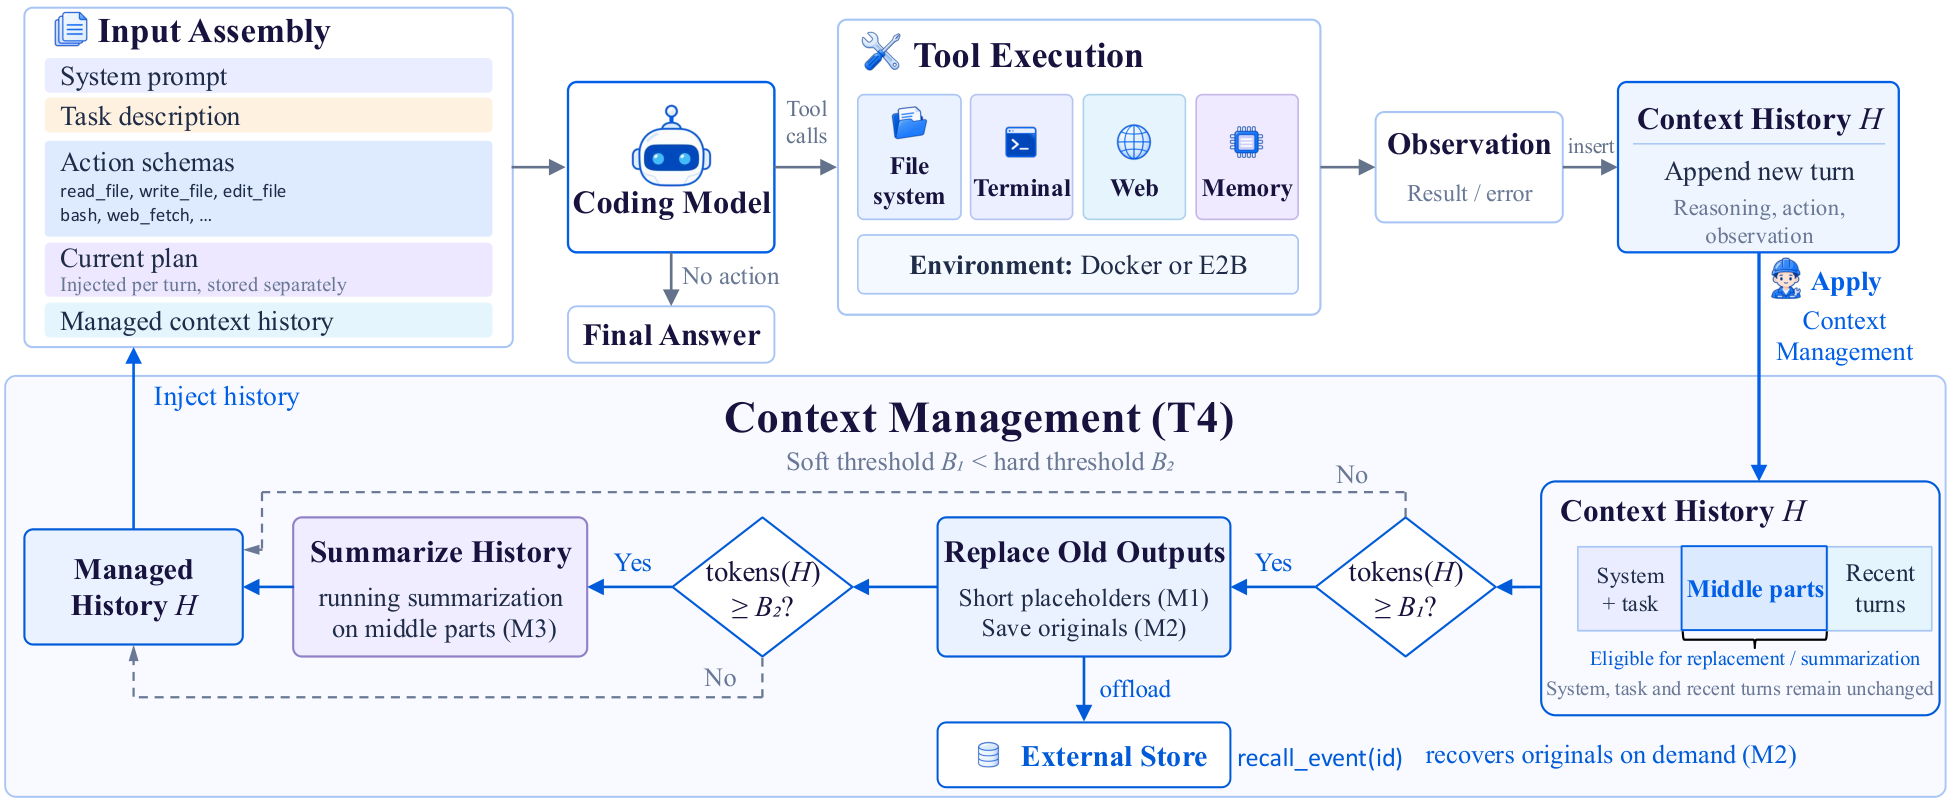
図 2:coding harness の総覧。上:ReAct ループ。各ターンでモデル入力を組み立て、タスクコンテナ内でモデルが発行したツール呼び出しを実行し、観測結果を履歴 HH に追加する。計画は注入される計画として、行動空間は公開される schema として、コンテキスト管理はモデルが見る履歴として入り込む。下:T4 戦略。M1–M3 は 3 つのコンテキスト管理機構。ソフト閾値 B1B₁ を超えると、サイズの大きい中間領域のツール出力がプレースホルダに置き換えられ(M1)、外部ストレージに退避されて recall_event で取り出せるようになる(M2)。ハード閾値 B2B₂ を超えると、最も古い中間イベントが要約される(M3)。先頭部分と直近の数ターンは原文のまま残す。
2.2 行動空間
行動空間は agent が環境とやり取りする方法を定義する。 事前定義ツールセットは read_file、write_file、edit_file、list_files、glob_files、grep_text、web_fetch、bash を提供し、一覧を表 1 に示す(システムプロンプトは図 13)。各ツールには型付きの引数 schema と、プロトコル、エラー、副作用を説明する記述がある。引数と読み取り専用状態の一覧は付録 8 にまとめた。 web 検索は除外した。SWE-Bench のタスクは公開 GitHub issue に由来するため、検索すると対応する pull request と真のパッチが露呈しうるからである(Cao et al., 2026)。bash のみの設定では事前定義のファイル、検索、web ツールを除き、汎用的な環境操作のために bash だけを残す(図 14)。他の harness コンポーネントが制御する補助ツールは変えない。T4/128k で計画を有効にした場合、どちらの条件でも update_plan と recall_event を残す。残りのプロンプトとツール記述は付録 7.1 と 8 に示す。この介入はワークスペース変更の追跡と検証の方法も同時に変える。事前定義のファイルツールは書き込み前の読み取りチェックを強制し、harness のファイル状態を更新し、対応する編集の後に自動診断を起動する。したがってこの比較は、ツールの可用性、インターフェース指示、状態追跡、検証支援を含む行動インターフェース全体の効果として理解すべきであり、ツール数や行動粒度の孤立した効果ではない。
表 1:harness が公開するツール。読み取り専用ツールはワークスペースや harness の状態を変更せず、1 回のモデルターン内で並行実行できる。bash のみのアクション空間条件では、定義済みのワークスペースツールを削除するが、bash と、有効化された計画・コンテキスト管理コンポーネントに必要な補助ツールは残す。表には主要な引数のみを示す。完全な自然言語による記述は付録 8 に再掲する。
| ツール | 読み取り専用 | 主要な引数 | 説明 |
|---|---|---|---|
| ファイル I/O | |||
| read_file | ✓ | path, offset, limit | ファイルを読み取り、行番号付きで返す |
| write_file | ✗ | path, content, overwrite | ファイルを作成、または既存ファイルを上書きする |
| edit_file | ✗ | path, old_text, new_text, replace_all | ファイル内の完全一致する文字列を置換する |
| 検索 | |||
| list_files | ✓ | path, recursive | ディレクトリの内容を一覧表示する |
| glob_files | ✓ | pattern, path | glob パターンに一致するファイルを探す |
| grep_text | ✓ | query, path, include | 正規表現でファイル内容を検索する |
| 実行 | |||
| bash | ✗ | command, timeout_seconds, cwd | shell コマンドを実行する |
| Web | |||
| web_fetch | ✓ | url, format | ウェブページをテキストまたは markdown として取得する |
| 計画 | |||
| update_plan | ✗ | plan | 保存済みのタスク計画を作成または更新する |
| コンテキスト管理 | |||
| recall_event | ✓ | id | 保存済みイベントの原文を返す(T2 と T4 のみ) |
2.3 コンテキスト管理
コンテキスト管理は、増え続ける対話履歴を限られたコンテキストウィンドウ内でどう表現するかを決める。既存の手法は有損と無損の 2 種類に分かれる。省略や要約といった有損手法はコンテキストを圧縮できるが、後になって必要になる情報を捨ててしまう可能性がある(Xiao et al., 2024; Jiang et al., 2023; Wu et al., 2021)。無損手法は外部ストレージと検索によって情報の復元可能性を確保するが、追加の仕組みが必要で、モデルが正しい情報を検索できるかに依存する(Packer et al., 2023; Park et al., 2023; Ehrlich and Blackman, 2026; Xu et al., 2026)。我々の harness は、組み合わせ可能な 3 つの仕組みを通じてこの両方の手法を取り入れている。省略(M1)は古くなったツール観測結果の本文を短い stub に置き換える。召回(M2)は省略された観測結果をファイルシステムに保存し、recall_event ツールで必要時に読み戻せるようにすることで、省略を可逆にする。要約(M3)は古いメッセージを継続的に更新される自然言語の要約へと畳み込む。要約は、評価対象と同じモデルに対するツールなしの単独呼び出しで生成し、その prompt は付録 7.3 に示す。省略は低コストで token を回収するが詳細を捨てる。召回は必要なときにその詳細を復元する。要約は、逐語で保持するには古すぎる履歴を圧縮する。これらは 2 つの token しきい値、ソフトしきい値 B1B₁ とハードしきい値 B2B₂ の下で組み合わせて使う。先頭部分(system prompt と初期タスク記述)と、少なくとも 2 ターン分の token 予算で制限された直近ウィンドウは逐語のまま保持し、圧縮するのは中間領域のみである。履歴が B1B₁ を超えると、harness は中間領域にあるサイズの大きいツール観測結果を省略し、原文を外部に保存して、その場所に stub を残す(M1 と M2)。それでも履歴が B2B₂ を超える場合、harness は中間領域で最も古いイベントをその継続更新中の要約へと畳み込む(M3)。 アルゴリズム 1 に全体の流れを示す。recall_event はどのターンでも利用できる。付録 7.3 では要約 prompt と、モデル入力に挿入される stub 断片および要約断片を再掲する。
表 2:5 つのコンテキスト管理レベル。各レベルは省略(M1)、召回(M2)、要約(M3)の一部を有効にする。
| M1 | M2 | M3 | |
|---|---|---|---|
| レベル 0 | ✗ | ✗ | ✗ |
| レベル 1 | ✓ | ✗ | ✗ |
| レベル 2 | ✓ | ✓ | ✗ |
| レベル 3 | ✗ | ✗ | ✓ |
| レベル 4 | ✓ | ✓ | ✓ |
各仕組みの寄与を切り分けるため、我々は 5 つの戦略バリアントを定義した(表 2)。レベル 4 はアルゴリズム 1 に示した 3 仕組みの完全な構成である。レベル 0 はコンテキスト管理を無効にし、軌跡がウィンドウを超えた時点でエラーを出して終了する。レベル 1 は省略(M1)のみを使い、古くなったツール観測結果の本文を短い stub に置き換えて元の内容を破棄する。レベル 2 は召回(M2)を加える。省略された観測結果は外部ストレージに保存され、recall_event で取り戻せるため、省略は可逆になる。レベル 3 は要約(M3)のみを使い、中間領域をローリング要約へと畳み込み、省略は行わない。レベル 1〜3 はいずれも動作が 1 つだけなのでハードしきい値 B2B₂ で発火し、レベル 4 は B1B₁ で省略、B2B₂ で要約する。
アルゴリズム 1 ラウンドごとのコンテキスト管理(階層 4)
1:
履歴 HH、ソフト閾値とハード閾値 B1 < B2,B₁ < B₂
2:
新しい think、action、observation を HH に追加する
3:
モデルがこのラウンドで recall_event(id) を呼び出したなら
4:
外部ストレージから観測 idid を HH に読み戻す ⊳\triangleright M2
5:
end if
6:
先頭部分と、予算サイズの直近ウィンドウ(少なくとも直近 2 ラウンドを含む)をそのまま保持する。MM を中間領域とする
7:
tokens(H) ≥ B₁ なら
8:
MM 内のサイズの大きいツール観測それぞれについて do
9:
原文を外部ストレージに保存する ⊳\triangleright M2
10:
本文をスタブに置き換える ⊳\triangleright M1
11:
end for
12:
tokens(H) ≥ B₂ なら
13:
MM 内で最も古いイベントをローリング要約にまとめる ⊳\triangleright M3
14:
end if
15:
end if
16:
return HH
2.4 その他のコンポーネント
上記 3 つのコンポーネントに加えて、harness にはいくつかの補助コンポーネントがある。これらはすべてのアブレーション実験で変更せずに固定した。ここでは特に重要な 3 つを取り上げる。
安全性
ワークスペースを読み書きする操作はすべて 3 つの関門を通る。ワークスペースガードは各パスを解析し、プロジェクトルートの外に出るパスを拒否する。シンボリックリンク経由で脱出する場合も含む。書き込み前の読み取りチェックは、現在のセッションでまだ読み取っていないファイルへの編集や上書きを拒否し、内容ハッシュで外部からの変更を検出する。その後、権限レイヤーが各操作を allow、ask、deny に分類する。ツールのエラーは例外として送出されるのではなく観測結果としてモデルに返されるため、失敗した操作でループが落ちることはなく、モデルはそこから復帰できる。
編集後の診断
agent が Python ファイルを編集または書き込みした後、harness は ruff、pyflakes、あるいは構文チェックのみを行うフォールバックで一度だけ高速な読み取り専用チェックを実行し、その結果をツールの戻り値に追記する。これにより構文エラー、未定義名、未使用の import が即座に露見し、モデルは 1 ラウンドをテストに費やす前にそれらを修正できる。
スタック検出
ラウンドベースの agent は空転し、同じ失敗操作を繰り返し発行してステップ数の予算を使い切ることがある。harness はツールログを監視し、連続して重複した呼び出し、すなわちツール名と引数がともに同一の連続呼び出しがあるかどうかを調べる。この連続重複が閾値に達すると、やり方を変えるよう求める一度限りのリマインダーを注入する。連続する失敗呼び出しの重複が増え続ける場合は、予算の上限まで磨り減らすのではなく、実行を早期に終了させる。リマインダーの文面と閾値は付録 7.4 を参照。
3 実験
3.1 設定
モデル。
実験では Nemotron-3 シリーズの 3 つの規模(Blakeman et al., 2025)(30B、120B、550B)を使用する。さらに別のモデルシリーズから Mistral-Medium-3.5-128B(Mistral AI, 2026)を加え、我々の結論が単一シリーズを超えて一般化するかどうかを検証する。token 価格は OpenRouter11 で算出した 1
https://openrouter.ai/、2026 年 8 月アクセス。100 万入力/出力 token あたりの価格:0.20(Nemotron-3-30B)、0.45(Nemotron-3-120B)、2.20(Nemotron-3-550B)、7.50(Mistral-Medium-3.5)。
ベンチマーク
2 つの長時程コーディングベンチマークで評価する。人手で検証された 500 件の実 GitHub issue を含む SWE-Bench Verified(Jimenez ほか,2024)と、コマンドライン環境でのエンドツーエンドタスク 89 件を含む Terminal-Bench 2.1(Merrill ほか,2026)である。どちらも 2 つの指標を報告する。タスク成功率、すなわち agent が解決したタスクの割合と、上記の方式で算出したタスクあたりの平均コストである。
実装の詳細
- •
モデルとサービング 3 つの Nemotron-3 モデルと Mistral-Medium-3.5-128B はすべて BF16 精度で SGLang によりローカルでサービングする。Temperature は 0、top-p は 0.95。1 ラウンドあたりの出力上限は 16,384 token。
- •
Harness の構成 Harness は LangGraph で構築され、22 2
https://www.langchain.com/langgraph、ベンチマークは Harbor が駆動する。33 3
https://www.harborframework.com/、Harbor がタスクごとのコンテナと検証器を保持し、ホスト agent がコンテナ上で操作を実行する。各タスクは最大 300 ステップ。コンテキスト管理では、ソフト閾値とハード閾値がそれぞれ利用可能ウィンドウの 0.6 と 0.85、逐語的に保持する直近ウィンドウの予算が 0.3、下限は 2 ターン。ツール結果は 24k 文字に切り詰め、1 ステップにつき最大 8 個の読み取り専用ツールを並列実行できる。スタック検出は、同一のツール呼び出しが 5 回連続、または同一の失敗呼び出しが 5 回連続した時点で警告を出し、同一の失敗呼び出しが 8 回連続した時点で終了する。
アブレーション設定
32k、64k、96k、128k のコンテキストウィンドウ予算で T0–T4 を評価し、モデルとベンチマークの組み合わせごとに 20 通りの設定を得る。すべての設定で定義済みツールセットを使い、planning を有効にする。T4/128k 設定を、残りのコンポーネントのアブレーションにおけるベースラインとする。一致させた設定として、planning を無効にするものと、定義済みツールセットを bash のみのインターフェースに置き換えるものを用意し、他のコンポーネントは変えない。planning と行動空間は T4/128k でのみ評価する。コンテキスト管理の 20 設定にコンポーネントのアブレーション 2 件を加えると、モデルとベンチマークの組み合わせごとに 22 設定、4 モデル×2 ベンチマークで計 176 の実験設定になる。ベンチマークごとに 3 つの比較族を定義する。管理戦略 vs. T0、planning 有効 vs. 無効、フルツールセット vs. bash のみ。各族内で、タスクをペアにした結果の成功率を両側正確 McNemar 検定で比較し、Benjamini–Hochberg 法を適用して偽発見率を 0.05 に抑える。
3.2 主要結果
表 3:SWE-Bench Verified の主要結果。成功率(SR、%)とタスクあたりの平均コスト($)を示す。各行はコンテキストウィンドウ予算とコンテキスト管理の段階を組み合わせたもの:T0 はコンテキスト管理なし、T1 は省略のみ、T2 は省略とリコール、T3 は要約のみ、T4 は 3 機構すべてを有効にする。最後の 2 行は 128k/T4 設定で個々のコンポーネントをアブレーションしたもの:−-plan は planning を無効にし、bash は構造化ツールセットを素のシェルに置き換える。太字は各モデルの最高 SR を示す。 は両側正確 McNemar 検定、Benjamini–Hochberg 補正後 q<0.05q<0.05 の条件で、対応するベースラインとの有意差を示す。*
| Nemotron-3 30B | Nemotron-3 120B | Nemotron-3 550B | Mistral-3.5-128B | ||
|---|---|---|---|---|---|
| 設定 | SR (%) | コスト ($) | SR (%) | Cost ($) | SR (%) |
| 32K | T0 | 09.40 | 0.04 | 11.40 | 0.05 |
| T1 | 20.60* | 0.09 | 43.00* | 0.35 | 51.40* |
| T2 | 20.80* | 0.09 | 42.20* | 0.36 | 53.60* |
| T3 | 23.80* | 0.11 | 39.60* | 0.18 | 58.40* |
| T4 | 21.20* | 0.11 | 42.20* | 0.17 | 55.60* |
| 64K | T0 | 20.80 | 0.07 | 34.00 | 0.10 |
| T1 | 23.40 | 0.09 | 45.40* | 0.39 | 63.80* |
| T2 | 24.40 | 0.09 | 43.20* | 0.32 | 64.60* |
| T3 | 26.40* | 0.10 | 43.60* | 0.23 | 65.80* |
| T4 | 25.80* | 0.08 | 41.80* | 0.21 | 63.40* |
| 96K | T0 | 24.00 | 0.09 | 39.60 | 0.20 |
| T1 | 23.20 | 0.09 | 43.20 | 0.33 | 65.00* |
| T2 | 23.60 | 0.09 | 45.40* | 0.37 | 67.20* |
| T3 | 23.60 | 0.09 | 46.20* | 0.36 | 66.80* |
| T4 | 24.80 | 0.09 | 43.40 | 0.30 | 66.80* |
| 128K | T0 | 24.80 | 0.09 | 40.20 | 0.25 |
| T1 | 25.00 | 0.10 | 44.40 | 0.39 | 65.20* |
| T2 | 26.00 | 0.10 | 45.20* | 0.35 | 67.40* |
| T3 | 23.60 | 0.11 | 44.00 | 0.35 | 65.80* |
| T4 | 25.20 | 0.09 | 44.00 | 0.34 | 65.80* |
| T4 w/o plan | 13.60* | 0.02 | 46.60 | 0.25 | 67.80 |
| T4 bash only | 10.20* | 0.03 | 42.40 | 0.35 | 69.40* |
表 4:Terminal-Bench 2.1 の主要結果。成功率(SR、%)とタスクあたりの平均コスト($)を示す。各行はコンテキストウィンドウの予算とコンテキスト管理戦略の組み合わせに対応する。T0 はコンテキスト管理なし、T1 は省略のみ、T2 は省略とリコール、T3 は要約のみ、T4 は 3 機構すべてを有効にする。最後の 2 行は 128k/T4 設定で個々のコンポーネントをアブレーションしたもの。−-plan は計画を無効化し、bash は構造化ツールセットを素のシェルに置き換える。太字は各モデルの最高 SR を表す。 は両側正確 McNemar 検定、Benjamini–Hochberg 補正後 q<0.05q<0.05 の条件で、対応するベースラインとの間に有意差があることを示す。*
| Nemotron-3 30B | Nemotron-3 120B | Nemotron-3 550B | Mistral-3.5-128B | ||
|---|---|---|---|---|---|
| Setting | SR (%) | Cost ($) | SR (%) | Cost ($) | SR (%) |
| 32K | T0 | 06.74 | 0.04 | 19.10 | 0.09 |
| T1 | 11.24 | 0.12 | 33.71* | 0.44 | 33.33 |
| T2 | 07.87 | 0.12 | 25.84 | 0.46 | 33.33 |
| T3 | 14.61 | 0.11 | 22.47 | 0.13 | 38.20* |
| T4 | 17.98* | 0.11 | 21.35 | 0.14 | 32.58 |
| 64K | T0 | 11.24 | 0.08 | 20.22 | 0.13 |
| T1 | 14.61 | 0.12 | 29.21 | 0.28 | 41.57 |
| T2 | 11.24 | 0.12 | 26.97 | 0.32 | 40.45 |
| T3 | 14.61 | 0.12 | 26.97 | 0.20 | 43.82* |
| T4 | 13.48 | 0.10 | 25.84 | 0.22 | 44.94* |
| 96K | T0 | 12.36 | 0.11 | 19.10 | 0.28 |
| T1 | 15.73 | 0.14 | 22.47 | 0.23 | 42.70 |
| T2 | 11.24 | 0.15 | 21.35 | 0.37 | 43.82* |
| T3 | 17.98 | 0.16 | 28.09 | 0.32 | 34.83 |
| T4 | 13.48 | 0.13 | 25.84 | 0.25 | 44.94* |
| 128K | T0 | 11.24 | 0.12 | 25.84 | 0.27 |
| T1 | 10.11 | 0.15 | 22.47 | 0.40 | 40.45 |
| T2 | 16.85 | 0.15 | 25.84 | 0.32 | 40.45 |
| T3 | 12.36 | 0.16 | 26.97 | 0.30 | 37.08 |
| T4 | 13.48 | 0.14 | 28.09 | 0.28 | 44.94* |
| T4 w/o plan | 08.99 | 0.08 | 28.09 | 0.38 | 46.07 |
| T4 bash only | 03.37* | 0.02 | 23.56 | 0.41 | 50.56 |
図 3:成功率とウィンドウ溢出率のコンテキストウィンドウ予算に対する変化。左軸は成功率、右軸(オレンジ)は T0 がウィンドウ溢出で失敗したタスクの割合。各サブ図で黒線が T0、薄青線がそれぞれ T1–T4、濃青線が 4 者の平均。どの予算でも管理対象の各層で溢出タスク数はちょうどゼロなので、溢出曲線は 1 本で足りる。
コンテキストウィンドウの予算が小さいほど、コンテキスト管理の価値は大きい。
モデルごと、コンテキストウィンドウ予算ごとに、コンテキスト管理の価値を「管理階層(T1〜T4)と管理なし(T0)の成功率の差」と定義する。モデル間で平均すると、管理ありとT0の差はウィンドウが32k、64k、96k、128kと広がるにつれて着実に縮まる。SWE-Benchでは35.7ポイントから15.9、5.5、2.7ポイントへ、Terminal-Benchでは9.5から7.5、4.8、2.8へ(表3、表4)。図3が示すように、この差の縮小はT0のウィンドウ溢れ失敗の減少と歩調を合わせている。これらの予算では、モデル平均のT0溢れ率はSWE-Benchで78.7%から8.7%へ、Terminal-Benchで61.0%から12.1%へ下がる一方、管理階層では溢れ失敗が常にゼロだった。つまりコンテキスト管理の価値は、主にウィンドウが厳しいときに早すぎる切り詰めを避ける点にあり、管理なしの軌跡がウィンドウに収まるようになるほど、その精度向上は小さくなり、モデル依存の度合いも強まる。
各種のコンテキスト管理戦略のうち、T4の精度とコストのトレードオフが最良。
図4によれば、T4の成功率はT1〜T3と同等で、8つのモデル–ベンチマークの組み合わせのうち7つでコストが最も低い。このコスト特性を説明するため、平均ピークコンテキストを対応する名目コンテキストウィンドウ予算で正規化した。図5(a)が示すように、32kではT1とT2の軌跡が依然としてウィンドウ全体に迫るのに対し、T3とT4はピークコンテキストをウィンドウよりはるかに低く抑える。すべてのモデル–ベンチマークの組み合わせで、T4は4つのウィンドウ予算すべてにおいて平均ピークコンテキスト比が最も低い。図5(b)はM1の省略とM3の要約の呼び出しを比較している。32kと64kでは、T4のM1呼び出し回数はT1とT2より少なく、より大きなウィンドウでも呼び出し頻度は低いままである。どの予算でも、M3の平均呼び出し回数はT3より少ない。8つのモデル–ベンチマークの組み合わせで平均すると、T4はどのウィンドウ予算でも1タスクあたりの平均コストが最も低い(図5(c))。これらの結果は、T4の早期省略が要約を必要とする前に多くのケースを処理し、高コストなLLM要約の呼び出しを減らすことを示している。コストが低い理由もここにある。
図4:各コンテキスト管理ティアの成功率とコスト。各ティアは左軸上で、32k、64k、96k、128kのコンテキストウィンドウ予算における成功率の最小値と最大値をカプセル形の区間で示し、横線が平均を表す。したがってカプセルの高さはウィンドウ予算への感度を反映する。デフォルトティアのT4は緑で示す。オレンジの折れ線は右軸に対応し、同じ4つの予算における1タスクあたりの平均コストを報告する。
図5:各コンテキストウィンドウ予算におけるコンテキスト圧縮、メカニズムの使用状況、コスト。各曲線は4モデル、2ベンチマークの等重み平均。(a) 平均ピークコンテキストを対応する名目コンテキストウィンドウ予算で割った値。数値が低いほどコンテキスト圧縮が効いていることを示す。(b) 1タスクあたりのelision(M1)とsummarization(M3)の平均呼び出し回数。対数座標。実線はT1、T2、T4のM1呼び出し回数、破線はT3、T4のM3呼び出し回数——summarizationを有効にしているのはこの2ティアだけである。(c) 1タスクあたりの平均コスト(ドル、$)。
Recall(M2)はほとんど使われず、elision単独と比べて精度も上がらない。
Recall(M2)はelideされた観測結果を外部に保存し、recall_eventを公開してオンデマンドで検索できるようにする。つまりelisionを可逆にする。T1とT2の違いはM2を有効にするかどうかだけなので、両者はその価値に関する対比較を成す。 32組のモデル–ベンチマーク–ウィンドウの比較で、T2は15の設定でT1を上回り、14で下回り、3で引き分けた。等重み平均の差は−0.36ポイント(SWE-Benchで+0.40、Terminal-Benchで−1.12)。 表13が示すように、recallが呼ばれることはほとんどない。 T2とT4の64設定のうち36(56.3%)はrecall_eventを一度も呼ばず、呼び出し率の中央値はゼロ、等重み平均は32kの1タスクあたり0.540回から64k、96k、128kで0.069、0.011、0.007回へ下がる。T4/128kの16のplanningおよびaction-space設定にはrecall呼び出しの記録がまったくない。 つまりrecallの使用はコンテキスト圧力が最も大きい状況に集中しており、そのほぼすべてがNemotron-3 30Bによるものだ。Nemotron-3 550BとMistral-Medium-3.5-128Bはほとんど呼ばない。 最も頻繁に使う構成——T2、32kのNemotron-3 30BでTerminal-Benchを走らせる場合——でも1タスクあたり平均4.326回の呼び出しにとどまり、スコアはT1より3.37%低い。 これらの結果は、可逆保存が加えるメカニズムをほとんどのモデルがほとんど使わないこと、そしてelideされた観測結果の検索がタスク完了に安定して結びつかないことを示している。
図6:planningのオンとオフにおける絶対性能とコスト。棒グラフはT4コンテキスト管理、128kコンテキストウィンドウ予算、フルツールセットを用いている。各モデルペアで、左の中空の棒はplanningオフ、右の塗りつぶした棒はオンを表し、両パネルともこの表記に従う。(a)は成功率、(b)は1タスクあたりの平均コストを報告する。
Planning は弱いモデルの成功率を上げ、強いモデルのコストを下げる。
T4/128k とフルツールセットの条件下で、planning のオンとオフを比較した(図 6)。Nemotron-3 30B では、planning によって SWE-Bench の成功率が 11.6 ポイント、Terminal-Bench が 4.5 ポイント上がったが、どちらのベンチマークでもコストは増えた。Nemotron-3 120B では、planning による一貫した成功率の向上は見られなかった。SWE-Bench ではコストが増え、Terminal-Bench では減った。Nemotron-3 550B と Mistral-Medium-3.5-128B では、どちらのベンチマークでもコストが下がり、成功率はわずかに低下した。SWE-Bench でのコスト削減はそれぞれ約 30% と 32%、成功率の低下は 2.0 ポイントと 0.4 ポイントだった(表 3、表 4)。
このコスト変化を説明するには実行統計が役立つ(表 5)。Nemotron-3 30B では、planning によってどちらのベンチマークでもターン数、ツール呼び出し回数、1 呼び出しあたりの平均入力トークン数が増えた。Mistral では 3 指標とも両ベンチマークで減少し、Nemotron-3 550B では SWE-Bench で 3 指標とも減少、Terminal-Bench での変化は小さかった。第 4 節ではこれらの変化を個々の軌跡まで遡って追跡する。planning は、Nemotron-3 30B では編集前に終了してしまうはずだった実行を延長し、Nemotron-3 550B と Mistral-Medium-3.5-128B で減ったターンは主に編集後の検証によるものだった。
表 5:T4、128k コンテキストウィンドウ予算、フルツールセットの条件下で、planning をオフからオンに変えたときの変化率。正の値は planning オンで増加、負の値は減少を表す。入力トークン平均は agent 呼び出し 1 回あたりの平均入力トークン数。
| SWE-Bench Verified | Terminal-Bench | |||||
|---|---|---|---|---|---|---|
| モデル | ターン数 | ツール呼び出し数 | 入力トークン平均 | ターン数 | ツール呼び出し数 | 入力トークン平均 |
| Nemotron-3 30B | +293.2%+293.2% | +474.0%+474.0% | +104.1%+104.1% | +66.7%+66.7% | +83.8%+83.8% | +24.0%+24.0% |
| Nemotron-3 120B | +20.1%+20.1% | +42.7%+42.7% | +10.3%+10.3% | −15.0%-15.0% | −23.1%-23.1% | −12.0%-12.0% |
| Nemotron-3 550B | −24.3%-24.3% | −24.5%-24.5% | −12.4%-12.4% | +6.8%+6.8% | +7.9%+7.9% | −1.7%-1.7% |
| Mistral-Medium-3.5-128B | −23.2%-23.2% | −23.3%-23.3% | −15.1%-15.1% | −22.5%-22.5% | −21.9%-21.9% | −13.0%-13.0% |
図 7:アクション空間の影響。bash のみとフルツールセットを比較した結果で、いずれも T4 コンテキスト管理、128k コンテキストウィンドウ予算、planning オンの条件で測定。(a) は成功率、(b) はタスクあたりの平均コスト、(c) はフルツールセット有効時に bash 経由で発行されたツール呼び出しの割合を示す。
定義済みツールセットは弱いモデルの足場になり、強いモデルには bash のみのほうが有利になる。
デフォルトの T4/128k 構成で planning をオンにした条件で、フルツールセットと bash のみを比較した。図 7 が示すとおり、定義済みツールセットの効果が最も大きいのは弱い Nemotron-3 モデルだった(表 3、表 4)。
Nemotron-3 30B では、定義済みツールセットによって SWE-Bench の成功率が 15.0%、Terminal-Bench が 10.1% 上がった。この利得は、モデルが学習したアクション語彙と harness のインターフェースが揃っていることによる。定義済みツールがないと、モデルは意図した操作を bash に書き換えるのではなく、学習中に身につけたツール呼び出しパターンに戻ってしまう。bash のみのレジストリにはこれらのツールが存在しないため、harness は発行された呼び出しを実行可能なアクションに解決できない。Terminal-Bench では、bash のみの軌跡の 66% がこうしたインターフェース外の呼び出しを境に終了し、平均軌跡長は 71 ターンから 15 ターンに縮んだ。定義済みツールセットは Nemotron-3 30B に足場を与え、確実に呼び出せるアクション語彙を露出させる。
Nemotron-3 120B では、精度の利得は SWE-Bench で 1.6%1.6%、Terminal-Bench で 4.5%4.5% にとどまるが、実行はより効率的になった。30B と違い、120B は長い軌跡から恩恵を受けない。定義済みツールセットによって、SWE-Bench の平均ターン数は 101101 から 7777、Terminal-Bench は 9696 から 7070 に減り、コストは増えなかった。
Nemotron-3 550B では、bash のみのほうが SWE-Bench の成功率を 3.6%3.6%、Terminal-Bench を 5.6%5.6% 高め、同時にコストをそれぞれ 53%53%、30%30% 削減した。bash のみの軌跡が発行する呼び出しは、SWE-Bench で 32%32%、Terminal-Bench で 24%24% 少ない。これは、作業を定義済みアクションに分散させるのではなく、より密で複合的な shell コマンドを使うこのモデルの傾向と一致する。このモデルにとって、定義済みツールセットは有用な足場というより、アクション選択とやり取りにかかるオーバーヘッドのように見える。第 4 節ではこの変化を編集のレベルから検討する。
Mistral-Medium-3.5-128B は、このクロスオーバーが作業負荷の境界であることを露呈させた。フルツールセットは SWE-Bench で成功率を 23.2%23.2% 押し上げたが、bash のみでは Terminal-Bench で 6.7%6.7% の改善にとどまった。図 7(c) がこの逆転を説明している。全ツールを使う場合、Mistral は Terminal-Bench ではワークスペース操作の 71.9%71.9% を bash 経由で発行するが、SWE-Bench ではその割合は 40.4%40.4% で、同時に定義済みツールの使用はタスクあたり 31.431.4 回から 13.113.1 回に減っている。つまり Terminal-Bench はシェル寄りであり、競合するワークスペースツールを外すほうがモデルの好む操作に合致する。一方 SWE-Bench では、定義済みの読み取り・検索・編集操作が依然として重要だ。
bash のみで失敗する別のパターンは修正の手前で現れる。Mistral の bash のみの SWE-Bench 実行のうち 32.8% はファイルを一切編集せずに終了したが、フルツールセットでは 1.2% だった(表 12)。未解決の実行では、正しいファイルに一度も触れなかった割合が 16.0 から上昇する。したがって Mistral の結果は、全般的な優位ではなく精度とコストのトレードオフを映しており、好まれる操作空間がモデル能力とタスク種別の両方に依存することを示している。
図 8:harness 構成ごとの SWE-Bench 軌跡分布。列はモデル、行は harness 設定に対応し、いずれも T4 コンテキスト管理と 128k コンテキストウィンドウ予算の下。積み上げ領域は各ターンでまだ実行中の軌跡の割合を示し、Localize、Reproduce、Fix、Verify、Other の行動に分解している。破線の縦線は軌跡長の中央値を示す。
図 9:harness 構成ごとの Terminal-Bench 軌跡分布。列はモデル、行は harness 設定に対応し、いずれも T4 コンテキスト管理と 128k コンテキストウィンドウ予算の下。積み上げ領域は各ステップでまだ実行中の軌跡の割合を示し、Understand、Write Code、Verify、Other の行動に分解している。破線の縦線は軌跡長の中央値を示す。
4 分析
本節では注釈付き軌跡を分析し、主要な結果の背後にある行動メカニズムを明らかにする。全体の結果はどの harness コンポーネントが重要かを示すが、その効果がどのように生じるかは説明していない。付録 9 の分類体系に従い、LLM judge で agent 軌跡の各ターンにワークフロー段階を注釈付けした。judge と人手注釈者との一致率は付録 9.2 に示す。まず、コンテキスト管理は実行軌跡を延ばすものの agent の行動を実質的には変えないことを示し、以降の分析では T4/128k に統一する。次に、planning がなぜ最弱モデルの軌跡を長引かせ、最強モデルの軌跡を短縮するのか、また bash-only インターフェースが動作の表現方法をどう変えるのかを検討する。
コンテキスト管理は実行軌跡を延ばすが、agent の行動は実質的に変わらない。
| 編集なし (%) | 定位で停滞 (%) | |
|---|---|---|
| モデル | オフ | オン |
| Nemotron-3 30B | 68.6 | 27.8 |
| Nemotron-3 120B | 15.6 | 24.4 |
| Nemotron-3 550B | 1.4 | 2.4 |
| Mistral-Medium-3.5-128B | 2.0 | 1.2 |
表 6:一切編集せずに終了した SWE-Bench 実行と、定位段階で停滞したサブセット(付録 9 の符号化でラベル付きターンが依然 Localize 段階にあるもの)。それぞれ planning オフとオン(T4/128k、フルツールセット)。
32k では、各構成の差は主に軌跡長に現れる。コンテキスト管理がない場合、稼働中の SWE-Bench 実行の割合は急激に落ち、4 モデルすべてで中央値は 20〜30 ターンだった。ほとんどの実行は Localize 段階で終わり、Verify に進むことはまれだった(図 32)。管理を有効にしたすべての構成で実行は延び、同時にほぼ同じターン数で各段階の順序と割合がおおむね保たれた。中央値はモデルと構成に応じて約 50〜180 ターンに増え、実行は検証段階まで進むようになった。Terminal-Bench でも同様のパターンが見られる(図 36)。128k では、構成間の差はほぼ消える。Nemotron-3 30B の軌跡長の中央値は 39〜42 ターン、Nemotron-3 550B は 70〜74 ターンだった。タスクあたりの再パッチ回数の差は 2 回未満で、4 モデル中 3 モデルでは編集せずに終了した実行の割合の差は 4 ポイント未満だった(図 35 と図 39、表 11 と表 12)。これらの結果は、コンテキスト管理が主に実行軌跡を延ばすのであって、エージェントの行動を実質的に変えるわけではないことを示している。したがって以降の分析では、コンテキスト管理を T4/128k に固定し、planning と動作空間が軌跡構造にどう影響するかを調べる。
計画は最も弱いモデルの軌跡を、編集を一度試みるのに足りる長さまで維持する。
図 8 は Nemotron-3 30B の性能向上を説明する手がかりになる。計画を切ると、SWE-Bench の軌跡長の中央値は 40 ターンから 5 ターンに落ちる。計画なしでは 68.6% の実行が編集をせずに終了し、58.4% が Localize 段階で終了する。計画ありではこの 2 つの数字はそれぞれ 27.8% と 10.4% になる(表 6)。これらの結果は、計画が能力の最も低いモデルを、最初の編集を一度試み終えるまで実行に踏みとどまらせるのに役立っていること、そして増えたターンがコスト増につながっていることを示している。Nemotron-3 120B では軌跡長の分布がほぼ重なっており、精度が上がらなかったことと一致する。
計画は SWE-Bench における強いモデルの軌跡を短縮し、その大半は編集後の検証を削っている。
図 8 によると、計画は Nemotron-3 550B の軌跡長の中央値を 108 ターンから 74 ターンへ、Mistral-Medium-3.5-128B を 68 ターンから 53 ターンへ下げる。段階ごとの内訳を見ると、この短縮は主に検証によるもので、定位や修正ではない。これと一致して、計画は編集を一切せずに終了した実行やファイル定位段階で失敗した実行の割合をほとんど変えていないが(表 12 と表 10)、ターン数とツール呼び出しは大きく減らしている(表 11)。これらの結果は、計画が主に改善するのは停止の挙動、すなわち編集後の余分な検証が減ることであることを示している。
Terminal-Bench のコストに対する計画の効果は、軌跡長の分布をどう変えるかで決まる。
図 9 は計画の相反する 2 つの効果を示している。早期に終了してしまう軌跡を延ばし、同時に長すぎる実行の裾を切り詰める。どちらが強く出るかで、図 6(b) の各モデルのコストの向きが決まる。Nemotron-3 120B では計画が長い裾の実行を切り詰め、コストは約 26% 下がる。Nemotron-3 550B では探索的な裾があまり圧縮されないため効果は小さく(3.6%)、Mistral-Medium-3.5-128B では中程度の長さの実行も長い実行も短くなり効果が大きい(約 40%)。Nemotron-3 30B は逆で、計画が早期終了を防ぐためコストは 75% 上がる。
表 7:フルツールセットと bash のみにおける動作の粒度(計画あり、T4/128k)。SWE-Bench におけるタスクあたりの平均再パッチ回数(編集済みファイルへの再編集)と編集行数の中央値、および Terminal-Bench のファイル書き込み動作に占める作成/置換の割合。
| 再パッチ | 編集行数 | 作成(%) | |
|---|---|---|---|
| モデル | ツール | Bash | ツール |
| Nemotron-3 30B | 3.3 | 0.4 | 26 |
| Nemotron-3 120B | 2.8 | 2.2 | 22 |
| Nemotron-3 550B | 4.6 | 1.5 | 18 |
| Mistral-Medium-3.5-128B | 3.0 | 1.3 | 87 |
bash のみにするとコードを書く動作が大きくなり、やり取りの回数も減る。
図 9 は Terminal-Bench 上の Nemotron-3 550B で最もはっきり出ている。フルツールセットから bash のみに切り替えると、軌跡長の中央値は 47 動作から 31 動作に下がり、同時に Write-code 動作の割合は 16% から 27% に上がる。つまり短くなった軌跡の中で、より大きな割合がコードの産出に使われている。このパターンは、shell を使えば能力の高いモデルが複数の低レベル操作を 1 つのコマンドやスクリプトにまとめられるのに対し、構造化されたインターフェースは同じ作業を多数の小さなやり取りに分解してしまうことを示している。表 7 に対応する細かい証拠がある。4 モデルすべてで、bash のみにすると編集済みファイルへの再パッチが減る。Nemotron-3 30B は 3.3 回から 0.4 回、120B は 2.8 から 2.2、550B は 4.6 から 1.5、Mistral は 3.0 から 1.3 になる。Terminal-Bench ではさらに、bash のみにするとファイル書き込みがより粗い作成または置換の動作に寄り、その割合は 30B で 28% から 64%、120B で 39% から 76%、550B で 51% から 76%、Mistral で 28% から 57% に上がる。定義済みツールは個々の動作を単純にするが、その代償として同じ操作を表すのに多くのやり取りと多くの増分パッチが必要になる。
5 関連研究
5.1 コーディングエージェント
コーディングエージェントのエンジンは能力の高い言語モデルであり、コードとエージェントの用途に特化する方向が強まっている。Qwen3-Coder(Cao et al., 2026)、Kimi K2.5 と K2.6(Team et al., 2026; Kimi Team, 2026)、GLM-5(Zeng et al., 2026)、Mistral Medium 3.5(Mistral AI, 2026)といった最近のフロンティアモデルは、コード生成とエージェント用途のために設計または評価されている。その進歩は実行ベースのベンチマークで測られる。SWE-Bench のリポジトリ単位のバグ修正(Jimenez et al., 2024)や Terminal-Bench のエンドツーエンドのコマンドラインタスク完了(Merrill et al., 2026)がそれにあたる。これらのベンチマークはエージェントシステム全体を評価するため、スコアにはモデルの能力だけでなく、制御ループ、動作インターフェース、コンテキスト管理の方針も混ざり込む。したがって、エージェントの基盤フレームワークを固定し、1 つのコンポーネントだけを変える制御された比較が必要になる。
5.2 コーディング harness
コーディング harness は、LLM を agent に変えるソフトウェア層であり、制御ループ、ツールインターフェース、コンテキスト管理から成る。agent はこれを通じてコードベースに働きかける。今日こうした harness が、Claude Code(Anthropic, 2025)、Codex(OpenAI, 2025)、OpenCode(OpenCode, 2025)、OpenHands(Wang et al., 2025)といったコーディング agent の製品とフレームワークを動かしている。その設計を調べた研究は、性能を決めるのはモデルだけでなく harness でもあると示した(Yang et al., 2024)。後続のシステムは harness に長期記憶を加え(Wong et al., 2025)、あるいはタスクグラフとモジュール化されたサブ agent を持ち込む(Chen et al., 2024; Arora et al., 2024)。近年のサーベイはこの設計空間を整理している(Rombaut, 2026)。こうしたシステムが最適化するのは、たいていパッケージ化された全体設計である。部分的なアブレーションを報告した研究はいくつかあるが、同じモデル能力とコンテキストウィンドウの予算のもとで、同一の実装レベルの介入を比較した研究はほとんどない。
そこで、コーディング harness をアブレーションし、どのコンポーネントが本当に重要かを突き止める研究が増えている。システムレベルでは、Agentless(Xia et al., 2024)や AutoCodeRover(Zhang et al., 2024)のような制約された特定—修正—検証パイプラインが、高度に複雑な agent アーキテクチャに頼らなくても強い性能を出せることを示した。より細かい粒度の研究はさらに、最適な設計がモデルに依存すると指摘する。AgentArch(Bogavelli et al., 2025)はモデルごとに異なるアーキテクチャの選好を報告し、大規模な軌跡研究は、コーディング agent フレームワーク間の挙動の差がモデルの世代によって変わると見出した(Mehtiyev and Assunção, 2026)。単一の介入も、より強いモデルにはほとんど役立たなくなるか、むしろ有害になりうる。ソフトウェアエンジニアリングにおけるプロンプトエンジニアリング戦略がまさにそうだった(Wang et al., 2026)。本稿に最も近いのは Liu(2026)で、短いホライズンの推論タスクにおいてプロンプトレベルの足場を全因子設計で調べているが、コンテキストウィンドウの圧力は明示的に扱っていない。我々が調べるのは実装レベルの計画、ワークスペースのアクションインターフェース、コンテキスト管理戦略であり、対象とするコーディング軌跡はずっと長く、コンテキストウィンドウが厳しい制約になりうる。さらに利用可能なコンテキストウィンドウの予算を明示的に操作する。この設定によって、これらの harness コンポーネントの条件付き効果が、モデル能力とリソースの可用性に応じてどう変わるかを描き出せる。
5.3 コンテキスト管理
ソフトウェアエンジニアリングのタスクが難しくなるにつれ、agent が解くのに必要なステップ数は増え、やり取りの履歴はモデルのコンテキストウィンドウを超えていく。そこで多くの研究が、タスク性能とコンテキスト長のバランスを取るコンテキスト管理戦略を提案してきた。第一の類型は静的で、古くなった内容を削除・切り詰める(Xiao et al., 2024; Jiang et al., 2023)、必要に応じて外部ストレージから以前の内容を検索する(Packer et al., 2023; Park et al., 2023)、履歴をコンパクトな状態に圧縮する(Wu et al., 2021)といった、人手で設計した固定の戦略を取る。第二の類型は動的で、通常は強化学習によってモデル自身にコンテキストを管理させる(Wu et al., 2025; Kang et al., 2025; Li et al., 2026; Zhang et al., 2026)。こうした仕組みは一般に改善策として提示され、単一のモデルでしか評価されないため、その中核となる依存関係は明らかにされていない。コンテキストを管理する価値は、管理できるウィンドウがどれだけ大きいかにかかっており、またモデルが十分に強いかどうか——圧縮が助けになる程度に強く、飢えさせられることのない程度に——にもかかっている。我々はこの依存関係を精密に描き出し、2 つのモデル系列、3 つのモデル規模で、コンテキストウィンドウを 32k から 128k token まで走査した。
6 結論
我々は、4 つのモデルと 2 つの長ホライズンコーディングベンチマークにおいて、コーディング harness の 3 つの中核コンポーネント——コンテキスト管理、計画、アクション空間——の条件付き効果を見積もる統制された実証研究を行った。コンテキスト管理は、コンテキストウィンドウの予算が厳しいときに最も重要になる。その各戦略のうち、T4 はまずルールベースの削除を行い、次に選択的な LLM 要約を行うことで、成功率がほぼ同等のまま総コストを最小に抑えた。計画は弱いモデルの成功率を高めるが、追加コストを要する。強いモデルに対しては主にコストを下げ、成功率はわずかに下がる。定義済みツールは bash の制御が弱いモデルの成功率を高めるが、bash のみの構成は bash を使いこなせるモデルに対して、より低いコストでより高い成功率をもたらす。シェル寄りのタスク種別ではこれが特に顕著だ。軌跡の分析は、それぞれの効果を具体的な挙動の変化に対応づけ、そこからそのコンポーネントが狙う制約に対応づける。コンテキスト管理は実行軌跡を延ばしつつ agent の挙動を大きくは変えず、コンテキスト予算が厳しいときに最大の利益を生む。計画は、タスクを早々に諦めるモデルの軌跡を維持し、検証に時間をかけすぎるモデルの重複した検証を減らす。構造化ツールはシェルの習熟度が限られたモデルを支え、bash のみの構成は、能力のあるモデルに複数のコード変更を 1 回のツール呼び出しにまとめさせる。したがって harness の設計は条件付きのシステム問題である。各コンポーネントは、既定の構成としてそのまま受け入れるのではなく、対象のモデル、タスク種別、リソース予算に合わせて選ぶべきだ。
局限性
第一に、我々の結果が推定しているのは、本論文で扱う特定の harness コンポーネントと実装の条件付き効果であり、普遍的に最適な harness を見つけることではない。計画は 1 つの prompt と更新メカニズムによってのみ実現され、コンテキスト管理も 1 つの閾値ベースの戦略のみを採用し、圧縮パラメータは固定されている。アクション空間への介入はインターフェース変更一式であり、ツールの可用性、インターフェース固有の prompt、ファイル状態の追跡、編集後の自動診断を同時に変えるため、ツール数やアクション粒度の影響をインターフェースの他の属性から切り離すことはできない。 第二に、設計空間の網羅範囲と統計的検出力の両方が限られている。計算資源の制約により、計画とアクション空間のアブレーションはデフォルトの T4/128k 構成でのみ行った。それらの効果が他のコンポーネントの組み合わせやコンテキスト予算の下でも残るかどうかを確かめるには、全因子実験が必要になる。各設定は各タスクにつき 1 回しか実行しておらず、Terminal-Bench には 89 個のタスクしかないため、Terminal-Bench の多くの比較は対応のある McNemar 検定では有意に達しない。このベンチマークに関する我々の結論が依拠しているのは、個々のセルが有意であることではなく、モデル間・予算間で方向が一致していることである。 最後に、我々の結論の外部妥当性は、評価したモデルとタスクによって制限される。Nemotron-3 系列の 3 つの規模と Mistral-Medium-3.5-128B を検討し、2 つの長時程コーディングベンチマークで評価したが、そのうち SWE-Bench Verified は Python のみを含む。モデル規模は能力の不完全な代理指標にすぎず、訓練の違い、これまでにツールインターフェースへ触れた経験、ネイティブな shell の習熟度も観測された傾向に寄与しうる——Mistral のインターフェース選好がベンチマークによって変わることはその一例である。したがって、本論文が報告する交叉点を他のモデルファミリー、他の harness 実装、あるいはソフトウェアエンジニアリング以外のタスク種別に移す場合には、まず検証を行うべきである。
7 Harness Prompts
本節では、評価中に使用した固定のプロンプトブロックを再現し、それらが harness の各構成下でどのように組み立てられるかを説明する。モデル呼び出しのたびに、アクションインターフェース固有の基本プロンプトを、有効化された計画コンポーネントとコンテキスト管理コンポーネントが提供する指示およびリマインダーと組み合わせる。各図が再現するのは固定テキストであり、実行時に依存するフィールド——ワークスペースパス、セッション情報、現在の計画、省略統計、保存されたイベント識別子、実行中の要約——は別途インスタンス化される。
7.1 システムプロンプト
アクション空間への介入は、有効化されるツールレジストリとインターフェース固有のシステム指示を同時に変える。図 10 は、事前定義されたツールセットと併用するリポジトリレベルのワークフローを定義し、対応する探索・編集・検証ツールを使うようモデルを明示的に導く。図 11 は同じ高レベルのワークフローと安全要件を保ちつつ、利用できない事前定義ツールへの言及をインターフェース非依存の指示に置き換える。図 12 はさらに、汎用的なワークスペース操作はすべて bash を通じて表現しなければならない一方、補助的な計画およびコンテキスト管理のアクションは引き続きそれぞれのコンポーネントが制御することを示す。図 13 と図 14 は、各条件で公開されるツールに対応する手続き的ルールを示す。したがってアクション空間のアブレーションは、ツールの可用性と、それらのツールをモデルに提示する際に依拠する指示の両方を変えている。
図 10:完全なアクション空間の下で、すべての構成で使用される基本システムプロンプト。
図 11:bash-only アクション空間条件で使用される基本システムプロンプト。このプロンプトは bash-only 構成において図 10 に取って代わる。
図 12:bash-only 構成で追加されるシステムブロック。
図 13:完全なアクション空間で提供されるツール使用ルール。このブロックは型付き API schema に加えて、並列読み取り操作、ファイル変更、shell 実行、ネットワークアクセス、ツールエラーからの復帰に関する指示を補う。
図 14:bash アクション空間条件でのみ提供されるツール使用ルール。このルールブロックは harness が現在有効なツールレジストリから生成し、tools フィールドも同じレジストリに由来する。アクション空間アブレーション実験では、bash と update_plan のルールは残り、事前定義ツールはすべて削除される。
7.2 計画プロンプト
計画オン(Planning-on)は常駐の足場によって実現され、3 つのプロンプトブロックと、update_plan を通じて維持される外部の計画状態から成る。 図 15 はシステムレベルで計画維持プロトコルを定義し、自明でないタスクには明示的な計画を求める。 図 16 は計画がまだ 1 つも作成されていない場合にのみ初期化要求を繰り返し、他のアクションを実行する前にまず計画を立てるようモデルを促す。 図 17 は現在保存されている計画を {PLAN} にシリアライズし、その後はモデル呼び出しのたびに再提供する。古いコピーを常駐の軌跡に追記するのではない。計画オフ(Planning-off)では、update_plan ツールとともにこれら 3 つのブロックを削除する。
図 15:計画システムプロンプト。自明でない要求に対して明示的なタスク計画を作成し、常に活動中のステップをちょうど 1 つ保ち、実行の進展に応じてタスク状態を更新するようモデルに求める。
図 16:計画がまだ作成されていない場合に初回に挿入される計画リマインダー。タスクが自明であるか純粋に情報照会でない限り、他のどのアクションを取るよりも先に update_plan を呼び出すようモデルに求める。
図 17:その後、モデル呼び出しの各回の前に挿入される計画リマインダー。プレースホルダーは現在保存されている計画に置き換えられる。この計画は再提供されるのであり、常駐のコンテキスト履歴に追記されるのではない。
7.3 コンテキスト管理プロンプト
コンテキスト管理テンプレートは harness の2つの段階に作用する。図18は、M3 要約が発火したときに単一の LLM 呼び出しで送出されるプロンプトを示す。harness は中間領域から選ばれた最も古いイベントと、既存のローリング要約を渡し、生成されたテキストが後続の agent 入力でそれらのイベントを置き換える。図19は、省略された観測結果とローリング要約がタスク求解モデルにどう提示されるかを示す。T1 が受け取るのは復元不能な省略プレースホルダのみだが、T2 と T4 はさらに recall_event に必要な保存済みイベント識別子も受け取る。ローリング要約は保持された前言の直後に挿入される。
図18:要約機構(M3)が使うプロンプト。harness は単一の呼び出しで、中間領域の最も早く選ばれたイベントに対して同じモデルを呼び出す。固定された見出しはローリング要約の増分保守を可能にする。前回の要約が新たに選ばれたイベントとともにモデルへ渡され、それを踏まえて改訂されるためだ。
図19:コンテキスト管理が挿入するテキスト断片。最初の2つの断片は省略された観測結果を置き換え、除去された内容の件数を報告する。M2 を有効にした場合の変種はさらに recall_event に必要なイベント識別子を与える。3つ目の断片はローリング要約を包み、その要約は自らが覆うイベントを置き換え、前言の直後に挿入される。
7.4 卡死检测提示词
卡死检测在每个实验条件下都以相同方式启用,因此属于固定的执行基座。harness 将连续若干次最近的工具调用定义为一个 streak:这些调用具有相同的工具名和逐字节相同的参数;参数不同的调用(例如在新偏移量处进行的分页读取)会终止该 streak。图 20 给出了两条提醒,依据重复调用只是返回已有结果还是以相同方式持续失败来选择。当 streak 达到五次任意状态的相同调用,或五次相同的失败调用时,每条 streak 插入一次提醒;运行时,{TOOL} 和 {N} 会被替换为重复的工具名和当前 streak 的长度。如果相同的失败 streak 继续到八次调用,运行会以专门的停止原因终止,而不是一直跑到步数预算耗尽。为此,权限拒绝不计为失败。
图 20:卡死检测机制使用的提醒。harness 识别具有相同工具名和参数的调用 streak,并根据这些调用是否返回相同的失败来选择提醒。每条 streak 插入一次提醒。相同的失败 streak 若继续增长,会在步数预算耗尽之前终止运行。
8 ツールの説明
表1はツールの可用性と主なパラメータをまとめたものである。モデル向けの各ツール定義は、ツール名、型付きのパラメータ schema、自然言語による説明からなる。以下の各図は評価期間中に実際に使われた説明文字列をそのまま再現しており、使用プロトコル、エラー時の挙動、副作用を含む。事前定義ツール条件ではファイル、検索、実行、ネットワークの各インターフェースが開放され、bash のみの条件では事前定義のワークスペースツールを外して bash だけを残す。補助ツール update_plan と recall_event は、それぞれ計画設定とコンテキスト管理設定によって独立に制御される。
8.1 ファイルの入出力
図21〜23は、事前定義ツール条件で使える3つの構造化ファイル操作を再現している。図21は行番号付きの有界なファイルアクセスを定義し、セッション単位のファイル状態に完全な読み取りを1回記録する。図22は新規ファイルの作成、または明示的に許可されたファイル全体の置換に使う。図23は既存ファイルに対してバイト単位で正確な的を絞った置換を行う。この2つの変更系ツールは、既存ファイルを変更する前に条件を満たす記録済みの読み取りが存在することを要求し、成功後は harness のファイル状態を更新する。bash 経由で行われる同等の変更は、この状態追跡と自動診断の経路には乗らない。
図21:read_file のツール呼び出し説明。
図22:write_file のツール呼び出し説明。
図23:edit_file のツール呼び出し説明。
8.2 検索
図24〜26は、事前定義ツール条件で使える3つの読み取り専用の探索インターフェースを再現している。図24はディレクトリの有界なツリー表現を返し、図25はパスパターンでファイルを特定し、図26は正規表現でファイル内容を検索する。これらのツールはワークスペースやファイル状態を変えず、互いに独立していれば並行して呼び出せ、設定されたワークスペースの無視パターンを一貫して適用する。
図24:list_files のツール呼び出し説明。
図25:glob_files のツール呼び出し説明。
図26:grep_text のツール呼び出し説明。
8.3 実行とネットワークアクセス
図27と図28は、2つのアクション空間条件において、同じ shell 実行器がモデル向けに持つ異なる2つの説明を示す。どちらの条件でも、コマンドは /bin/sh -c で実行される。事前定義ツールの説明はよくあるファイル操作と検索操作を構造化インターフェースへ誘導するのに対し、bash のみの説明はすべての汎用的なワークスペース操作を shell コマンドで表現することを求め、変更を明示的に検証するようモデルに要求する。図29は特定 URL の取得を説明しており、事前定義ツール条件でのみ使える。
図27:事前定義ツールセット条件で bash に与えられるツール呼び出し説明。
図28:bash のみの条件における bash のモデル向け代替説明。
図29:web_fetch のツール呼び出し説明。
8.4 プランニングとコンテキストの呼び戻し
本節で扱うツールは補助コンポーネントのインターフェースであり、あらかじめ定義されたワークスペース操作ではない。図 30 は update_plan を説明する。プランニングを有効にすると必ず公開され、メモリ上のプランを丸ごと置き換えるが、ワークスペースのファイルには手を付けない。図 31 は recall_event を説明する。T2 と T4 でのみ公開され、イベント識別子で保存済みの履歴を検索する。一度有効になれば、この 2 つのツールはどのアクション空間の条件下でも利用可能なままである。
図 30: update_plan のツール呼び出しの説明。
図 31: recall_event のツール呼び出しの説明。
9 軌跡の分析
harness の評価は最終的なタスクの成否だけで行うのではなく、各 agent の軌跡を解釈可能な行動カテゴリと失敗カテゴリに分解して行う。これらの分析では、軌跡の生存状況、行動の構成、アクションの粒度、そして未解決の実行がどの段階で終了したかを調べる。そこから、観察された行動の変化が §4 で提示したメカニズムと一致するかどうかを判断する。付録では 3 つの相補的なアノテーションスキームを軸に、続いて評価モデルの検証、ベンチマークごとの軌跡結果、集計統計、recall イベントの使用状況、そして完全な評価プロンプトを扱う。
9.1 アノテーションスキーム
3 つの相補的なアノテーションスキームを採用する。失敗段階の帰属は、未解決の SWE-Bench 修正軌跡のうち最も早く失敗した段階を特定する。2 つの行動コーディングは、SWE-Bench と Terminal Bench で agent が問題解決の各段階にアクションをどう配分するかをそれぞれ記述する。
9.1.1 SWE-Bench の失敗段階の帰属
未解決の SWE-Bench 軌跡には、修正過程で最も早く失敗した位置に対応する失敗段階を 1 つ付与する。段階は自然なデバッグの流れに沿う。ファイルの特定、行の特定、パッチの実装、検証の 4 つである。最も早い失敗を原則にとることで、テスト失敗のような下流の症状が、それより前に起きた特定や実装の誤りを覆い隠すことを防げる。
9.1.2 SWE-Bench の行動コーディング
SWE-Bench の行動コーディングは、各ターンにおける agent の主な作業目的を記述するために用いる。Mehtiyev と Assunção(2026)の軌跡分析フレームワークに基づき、各ターンを 5 つの段階のいずれかに分類する。特定、再現、修正、検証、その他の補助行動である。これらのラベルは、デバッグの過程で agent が労力をどう配分するかを記述する。5 つの段階の記号と、軌跡におけるその由来を表 8 に示す。
| カテゴリ | 記号 | 意味 | 軌跡における由来 |
|---|---|---|---|
| Localize | L | 関連コードの特定 | file read、grep、glob、list、find |
| Reproduce | R | 再現スクリプトの構築・実行 | 再現ファイルの作成 / 編集 / 実行 |
| Fix | F | ソースの修正 | リポジトリファイルの編集 |
| Verify | V | 検証の実行 | テスト実行(成功、失敗、エラー) |
| Other | O | 環境設定と補助 | pip、conda、recall_event、submit、…… |
表 8: SWE-Bench 軌跡のコーディング: 5 つの段階の記号。
9.1.3 Terminal-Bench のアクション単位コーディング
Terminal-Bench のアクション単位コーディングは、各 shell アクションの意味的な意図を分類するために用いる。ターン全体にラベルを付ける SWE-Bench コーディングとは異なり、このスキームはツール呼び出しを 1 回ずつラベル付けする。10 個の細粒度アクション型記号を定義し、それらを理解、コード記述、検証、その他の補助操作という 4 つの上位段階にまとめる。10 記号からなるアクション分類体系の全体を表 9 に示す。
| カテゴリ | 記号 | 意味 | 軌跡における由来 |
|---|---|---|---|
| 理解 | I | ファイル内容の閲覧 | cat、head、tail、less、sed -n |
| S | 検索 / 発見 | ls、find、grep | rg、which | |
| コード記述 | C | 作成(新規ファイル) | heredoc 書き込み、touch、tee で新規パスへ |
| M | 変更(既存ファイル) | sed -i、patch、追記リダイレクト | |
| E | 環境構築 | pip、apt、conda、make、build | |
| 検証 | X | 自作コードの実行 | python foo.py、./run.sh、コンパイル済みバイナリ |
| T | テスト(実際のフレームワーク) | pytest、unittest、npm test、go test | |
| V | 成果物の検証 | diff、md5sum、出力ファイルの再読み込み | |
| その他 | N | ナビゲーション | cd、pushd、pwd のみの呼び出し |
| G | 汎用 / その他 | git、echo、export、rm、shell の雑多な操作、…… |
表 9: Terminal-Bench 軌跡のコーディング: 4 つの段階にまとめられた 10 種のアクション型記号。
9.2 評価の設定と人手による検証
LLM ベースの評価器を用いて、SWE-Bench のターン用途の分類、SWE-Bench の失敗段階の帰属、Terminal-Bench のアクション用途の分類を行う。対応するプロンプトを図 40、41、42 に示す。すべての評価呼び出しは GPT-5.5 を使用し、推論強度は high、デコード温度は 0.6 に設定する。
LLM ジャッジのラベルを 3 名の人手アノテータで検証した。200 本のトラジェクトリからサンプリングし、互いに重複しない 3 つのサブセットに均等に分割して 1 人ずつ担当させたが、うち 1 人は他より 1 本多くアノテーションしている。各アノテータは自分のサブセット内のすべてのユニットにラベルを付けた。検証がカバーしたアノテーションユニットは計 15,610 個で、内訳は Terminal-Bench の行動ラベル 5,306 個、SWE-Bench の行動ラベル 10,254 個、SWE-Bench の失敗段階診断 50 個である。サブセットごと、ユニット種別ごとに、アノテータは LLM ジャッジと同じラベル集合を使って独立にアノテーションした。人手ラベルとジャッジ出力は生の一致率と Cohen’s κ\kappa で比較した。
全体として、ジャッジと人手の一致率はどのアノテータでも高かった。サブセットごとの全体一致率は 88.7% から 98.4%、Cohen’s κ\kappa は 0.858 から 0.980 の範囲にある。3 つのサブセットをまとめると、生の一致率は約 94.2%、Cohen’s κ\kappa の加重平均は 0.929 だった。SWE-Bench の行動ラベルは特に一致率が高く、生の一致率が 92.7% から 99.0%、κ\kappa が 0.881 から 0.984 である。Terminal-Bench の行動ラベルも同様に高く、生の一致率が 79.8% から 97.3%、κ\kappa が 0.758 から 0.965 だった。失敗段階診断も一致率は高く、87.5% から 100.0%、κ\kappa が 0.813 から 1.000 である。
これらの結果は、ベンチマーク固有の行動分類体系でも失敗段階ラベルでも、LLM ジャッジが独立した人手アノテーションと高い一致を示すことを意味する。§4 の行動分析を実験の全トラジェクトリに広げるうえで、ジャッジが生成したトラジェクトリラベルを使うことを支持する根拠になる。
9.3 SWE-Bench トラジェクトリの結果
9.3.1 失敗段階の結果
SWE-Bench の失敗段階ジャッジは未解決のトラジェクトリにのみ適用した。入力は issue の記述、gold patch が変更したソースファイル、ソースコードのみを含む agent の patch、トラジェクトリの最後の部分で、そこから最初に正しく完了できなかった段階を判定する。表 10 は 128k 設定ごとに 4 段階の分布を報告している。補足の終了統計はジャッジではなく行動コーディングから得たもので、実行が終了前にファイルを編集したか、停止時にどの段階にいたかを記録し、表 12 に別途示す。
注目すべきパターンは 3 つある。第一に、主要な失敗段階はモデル能力によって変わる。Nemotron-3 30B では未解決実行の半数以上がファイル特定で失敗するのに対し、Nemotron-3 550B と Mistral-Medium-3.5-128B では大多数の実行が正しいファイルと行にたどり着きながら patch の実装で失敗する。第二に、Nemotron-3 30B から計画または事前定義ツールを外すと、ファイル特定の割合がそれぞれ 56.3% から 73.8%、76.6% へと上がる。これは §4 で述べた早期終了の挙動と一致する。第三に、Mistral の bash-only 設定は、ファイル特定の失敗率が大きく上昇した唯一の強いモデル設定で、16.0% から 41.4% に増える。bash-only での 23.2 ポイントの低下は主に修正ステップより前で起きているということだ。段階分布はコンテキスト管理の階層間であまり変わらないため、128k での階層比較が映しているのは失敗の位置の違いではなく、失敗した実行の数のわずかな差である。
表 10: 128k のコンテキストウィンドウ予算における、LLM ジャッジが判定した未解決 SWE-Bench 実行の失敗段階分布(図 41)。Unres. は 500 回の実行のうち未解決だった数。4 つの段階の列は、未解決実行のうち最初に失敗した段階がファイル特定、行特定、patch 実装、検証だったものの割合で、各行の合計は 100 になる。ジャッジがトラジェクトリを走査できなかった少数の未解決実行(各設定で最大 3 件)は割合に含めていない。
| 最初に失敗した段階(%) | |||
|---|---|---|---|
| モデル | 設定 | 未解決 | ファイル特定 |
| Nemotron-3 30B | T0 | 376 | 51.3 |
| T1 | 375 | 49.5 | 12.6 |
| T2 | 370 | 54.5 | 12.5 |
| T3 | 382 | 55.1 | 9.2 |
| T4 | 374 | 56.3 | 9.1 |
| T4 計画なし | 432 | 73.8 | 7.0 |
| T4 bash のみ | 449 | 76.6 | 9.2 |
| Nemotron-3 120B | T0 | 299 | 40.1 |
| T1 | 278 | 42.6 | 12.3 |
| T2 | 274 | 37.2 | 13.1 |
| T3 | 280 | 38.6 | 11.4 |
| T4 | 280 | 44.3 | 8.9 |
| T4 計画なし | 267 | 40.1 | 13.5 |
| T4 bash のみ | 288 | 42.9 | 11.1 |
| Nemotron-3 550B | T0 | 201 | 20.9 |
| T1 | 174 | 22.4 | 13.2 |
| T2 | 163 | 17.2 | 19.6 |
| T3 | 171 | 21.1 | 15.8 |
| T4 | 171 | 16.4 | 11.7 |
| T4 計画なし | 161 | 17.5 | 16.9 |
| T4 bash のみ | 153 | 20.5 | 14.6 |
| Mistral-Medium-3.5-128B | T0 | 163 | 20.2 |
| T1 | 157 | 14.7 | 18.6 |
| T2 | 165 | 19.4 | 10.3 |
| T3 | 167 | 22.8 | 17.4 |
| T4 | 157 | 16.0 | 16.7 |
| T4 計画なし | 155 | 20.3 | 17.6 |
| T4 bash のみ | 273 | 41.4 | 9.2 |
9.3.2 行動プロファイル
図32–35では、プランニング方式と定義済みツールセットを固定し、コンテキスト管理層とコンテキストウィンドウの予算だけを変えている。列はモデル、行はT0–T4に対応する。時点ttにおいて、積み上げの総高さはまだ実行中の軌跡の割合を表し、色分けされた帯はそれらのアクティブな軌跡をLocalize、Reproduce、Fix、Verify、Otherの5種類の行動に分類している。縦の破線は軌跡長の中央値を示し、右上の注記には成功率とタスクあたりの平均コストが示されている。これらのプロファイルは、エージェントの行動分布を記述的に要約したものにすぎない。
図32:32kコンテキスト管理戦略におけるSWE-Benchの軌跡分布。
図33:64kコンテキスト管理戦略におけるSWE-Benchの軌跡分布。
図34:96kコンテキスト管理戦略におけるSWE-Benchの軌跡分布。
図35:128kコンテキスト管理戦略におけるSWE-Benchの軌跡分布。
9.4 Terminal-Benchの軌跡結果
図36–39はTerminal-Benchの軌跡分布を示しており、レイアウトはSWE-Benchと揃えている。列はモデル、行はT0–T4に対応し、プランニングと定義済みツールセットは固定したままである。時点ttにおいて、総高さはまだアクティブな軌跡の割合を表し、色分けされた帯はアクティブな軌跡をUnderstand、Write Code、Verify、Otherの4種類の行動に分類している。
図36:32kコンテキスト管理戦略におけるTerminal-Benchの軌跡分布。
図37:64kコンテキスト管理戦略におけるTerminal-Benchの軌跡分布。
図38:96kコンテキスト管理戦略におけるTerminal-Benchの軌跡分布。
図39:128kコンテキスト管理戦略におけるTerminal-Benchの軌跡分布。
9.5 128kにおける軌跡レベルの統計
表11と表12は、本文の軌跡レベル要約の背後にある128kの完全な統計を示している。表11は表7に軌跡長、ツール呼び出し回数、5つのコンテキスト管理層すべてを追加したもの、表12は表6に残りの層、bashのみのアブレーション、および対応するTerminal-Benchの各列を追加したものである。終了段階は行動コーディングから直接読み取る。SWE-Benchでは、Fixラウンドを含まない実行を「編集せずに終了」と数え、さらにそのすべてのラベル付きラウンドがLocalizeまたはOtherである場合は「ローカライズ段階で停滞」と数える。Terminal-Benchでは、対応する列にアクションレベルのコーディングにおけるコード記述段階(CreateまたはModifyアクション)と理解段階(InspectまたはSearchアクション)を用いる。
コンテキスト管理の層分けは128kでの軌跡の形をほとんど変えない。
T0–T4の間で、各モデルの軌跡長の中央値とツール呼び出しの平均回数はごく狭い範囲でしか変動しない(表11)。Nemotron-3 30BのSWE-Bench中央値は常に39〜42ラウンド、Nemotron-3 550Bは70〜74ラウンドである。再パッチ回数はタスクあたり2回未満の差、編集規模の中央値は数行の差にとどまる。終了行動も同様に安定している(表12)。4モデル中3モデルでは、SWE-Bench実行のうち何も編集せずに終了した割合は層間で4ポイント未満しか違わず、Nemotron-3 120Bでは約8ポイントである。だからこそ§4は、128kでエージェントの行動を大きく変えずに実行軌跡を延ばせる。層間の差は、ウィンドウがボトルネックになったとき、たとえば32k構成(図32、図36)で初めて現れる。
軌跡を変える介入はプランニングとアクション空間である。
プランニングを外すと、Nemotron-3 30BのSWE-Bench軌跡の中央値は5ラウンドに縮み、編集せずに終了する割合は27.8%から68.6%に上がった。一方、Nemotron-3 550BとMistral-Medium-3.5-128Bでは軌跡がむしろ長くなり(中央値はそれぞれ74→108ラウンド、53→68ラウンド)、編集なし終了率は3%未満のままである。これは§4で論じた2つのケースそのものである。bashのみにすると4モデルすべてで再パッチが減るが、編集規模への影響はモデルによって異なる。Nemotron-3 550Bの最大編集の中央値は18行から54行に増え、Nemotron-3 30Bは26行から13行に減り、Nemotron-3 120Bはほぼ変わらず、Mistral-Medium-3.5-128Bは87行から68行に減った。このモデルは定義済みツールでもともと編集が大きめである。Terminal-Benchでは、bashのみにすると全モデルでファイル書き込みアクションに占める「作成または置換」の割合が上がり、Nemotron-3 30Bのbashのみ構成は全構成中で最も高いコードなし終了率(22.5%)を示した。これは§3.2で述べたインターフェース外のツール出力と一致する。
表11:128kコンテキストウィンドウ予算における完全なアクション粒度の統計。表7に対応する。行はプランニングと完全なツールセットを備えたT0–T4のコンテキスト管理層、続いてT4のプランニングなしとbashのみのアブレーション。Re-patch は編集済みファイルへの再編集回数、edit lines は最大編集行数の中央値、create share はTerminal-Benchのファイル書き込みアクションのうちファイルを作成または置換した割合を数える。
| SWE-Bench Verified | Terminal-Bench | ||
|---|---|---|---|
| モデル | 設定 | SR (%) | 中央値ターン数 |
| Nemotron-3 30B | T0 | 24.8 | 39 |
| T1 | 25.0 | 42 | 54.5 |
| T2 | 26.0 | 39 | 54.4 |
| T3 | 23.6 | 41 | 56.0 |
| T4 | 25.2 | 40 | 54.6 |
| T4 計画なし | 13.6 | 5 | 9.8 |
| T4 bash のみ | 10.2 | 10 | 22.3 |
| Nemotron-3 120B | T0 | 40.2 | 33 |
| T1 | 44.4 | 34 | 69.5 |
| T2 | 45.2 | 32 | 57.6 |
| T3 | 44.0 | 32 | 70.3 |
| T4 | 44.0 | 33 | 65.8 |
| T4 計画なし | 46.6 | 27 | 46.0 |
| T4 bash のみ | 42.4 | 41 | 84.6 |
| Nemotron-3 550B | T0 | 59.8 | 70 |
| T1 | 65.2 | 71 | 91.7 |
| T2 | 67.4 | 73 | 96.4 |
| T3 | 65.8 | 74 | 95.8 |
| T4 | 65.8 | 74 | 98.4 |
| T4 計画なし | 67.8 | 108 | 130.3 |
| T4 bash のみ | 69.4 | 55 | 67.1 |
| Mistral-Medium-3.5-128B | T0 | 67.4 | 50 |
| T1 | 68.6 | 51 | 56.6 |
| T2 | 67.0 | 50 | 55.6 |
| T3 | 66.6 | 51 | 57.1 |
| T4 | 68.6 | 53 | 57.8 |
| T4 計画なし | 69.0 | 68 | 75.3 |
| T4 bash のみ | 45.4 | 47 | 50.2 |
表 12:128k コンテキストウィンドウの予算における終了段階の完全な統計。表 6 に対応する。終了関連の各列は表 8 と表 9 の行動コードから導出した。W/o edit(W/o code)は、Fix ターンが一度もない(Create または Modify の動作が一度もない)まま終了した実行の割合を指す。At loc.(At underst.)は、そのうち Other 段階の記帳動作を除き、Localize 段階(Understand 段階、すなわち Inspect と Search の動作)より先に進まなかった実行の割合を指す。Edited(Wrote)は、実際にソースコードを編集した(コードを書き込んだ)ものの未解決に終わった実行の割合を指す。
| SWE-Bench Verified | Terminal-Bench | ||
|---|---|---|---|
| 完了率 (%) | |||
| モデル | 設定 | 編集なし | 該当箇所 |
| Nemotron-3 30B | T0 | 26.4 | 9.6 |
| T1 | 24.6 | 7.0 | 51.0 |
| T2 | 27.6 | 10.4 | 46.0 |
| T3 | 26.2 | 8.2 | 50.2 |
| T4 | 27.8 | 10.4 | 47.0 |
| T4 計画なし | 68.6 | 58.4 | 18.0 |
| T4 bash のみ | 75.4 | 47.6 | 15.0 |
| Nemotron-3 120B | T0 | 18.6 | 16.2 |
| T1 | 16.6 | 11.8 | 39.6 |
| T2 | 21.6 | 13.0 | 33.4 |
| T3 | 20.2 | 13.4 | 36.2 |
| T4 | 24.4 | 17.8 | 31.8 |
| T4 計画なし | 15.6 | 11.0 | 38.4 |
| T4 bash のみ | 24.4 | 12.4 | 33.4 |
| Nemotron-3 550B | T0 | 1.8 | 1.6 |
| T1 | 2.2 | 0.6 | 32.6 |
| T2 | 2.4 | 0.4 | 30.2 |
| T3 | 2.0 | 0.4 | 32.2 |
| T4 | 2.4 | 0.6 | 31.8 |
| T4 計画なし | 1.4 | 0.2 | 30.8 |
| T4 bash のみ | 1.6 | 0.4 | 29.0 |
| Mistral-Medium-3.5-128B | T0 | 1.6 | 0.4 |
| T1 | 1.8 | 0.6 | 29.6 |
| T2 | 2.2 | 0.8 | 31.0 |
| T3 | 2.4 | 1.0 | 31.2 |
| T4 | 1.2 | 0.6 | 30.2 |
| T4 計画なし | 2.0 | 1.0 | 29.2 |
| T4 bash のみ | 32.8 | 17.8 | 22.0 |
9.6 recall_event の使用状況
表 13 に、§3.2 の各設定における呼び出し率を示す。ここで集計しているのはタスクあたりの recall_event 呼び出し回数の平均であり、recall を使った軌跡の割合ではない。1 つの軌跡がこのツールを複数回呼び出すことがあるためだ。
表 13:recall を有効にしたコンテキスト管理戦略(T2 および T4)における、タスクあたりの recall_event 平均呼び出し回数。モデルとコンテキストウィンドウ予算別に集計。T4/128k では、計画・行動空間アブレーションの全 16 設定で呼び出し回数がゼロだったため省略。
| SWE-Bench Verified | Terminal-Bench | ||
|---|---|---|---|
| モデル | 階層 | 32k | 64k |
| Nemotron-3 30B | T2 | 0.146 | 0.004 |
| T4 | 0.472 | 0.032 | |
| Nemotron-3 120B | T2 | 0.206 | 0.008 |
| T4 | 0.318 | 0.010 | |
| Nemotron-3 550B | T2 | 0.000 | 0.000 |
| T4 | 0.006 | 0.000 | |
| Mistral-Medium-3.5-128B | T2 | 0.000 | 0.000 |
| T4 | 0.010 | 0.000 |
9.7 判定プロンプト
図 40、41、42 に、SWE-Bench のターン目的分類、SWE-Bench の失敗段階の帰属、Terminal-Bench の行動目的分類に用いたプロンプトをそのまま再掲する。
図 40:SWE-Bench の軌跡コーディングに用いた LLM 判定プロンプト。判定モデルは各ターンを表 8 の 5 つの段階記号のいずれかに分類する。
図 41:SWE-Bench の失敗段階の帰属に用いた LLM 判定プロンプト。未解決の軌跡ごとに、判定モデルは修正プロセスで最初に失敗した段階(ファイル特定、行特定、パッチ実装、検証)を返す。
図 42:Terminal-Bench の行動レベルコーディングに用いた LLM 判定プロンプト。判定モデルは各 shell ベースの行動を表 9 の 10 個の細粒度行動タイプ記号のいずれかに分類する。
参考文献の完全なリストは原論文を参照。