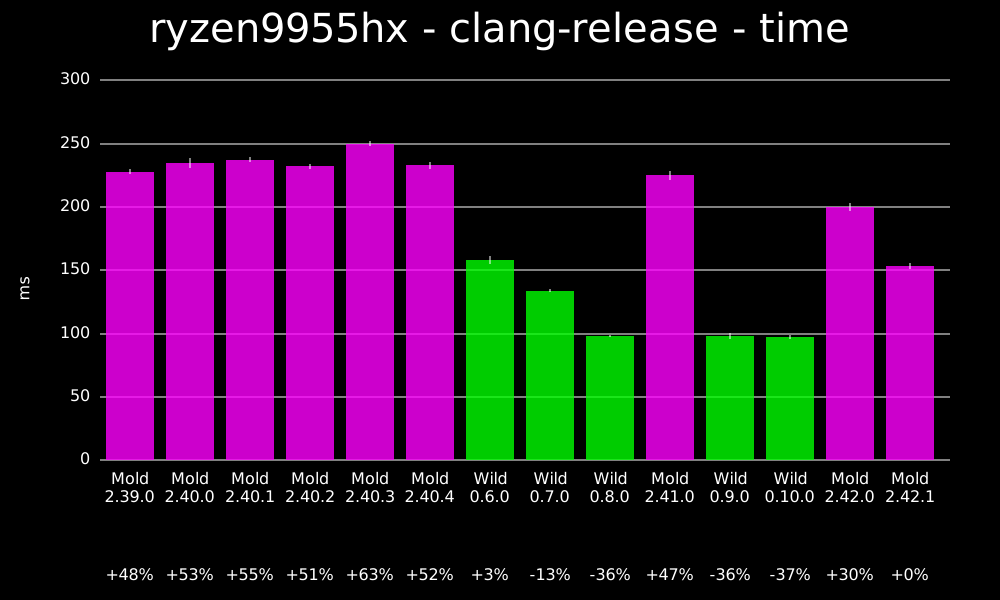
同じリンカで2つのベンチマークが正反対の結論:Wild作者が項目ごとに分解して自分で確認
Moldが最近リンカベンチマークを更新し、初めてWildを対象に含めた。このベンチマークではWildはMoldよりかなり遅く、8月4日の前回リリース時にWildが最新で公表したベンチマーク結果とは逆である。
もっと見る 開発ツール
ホームMoldが最近リンカベンチマークを更新し、初めてWildを対象に含めた。このベンチマークではWildはMoldよりかなり遅く、8月4日の前回リリース時にWildが最新で公表したベンチマーク結果とは逆である。
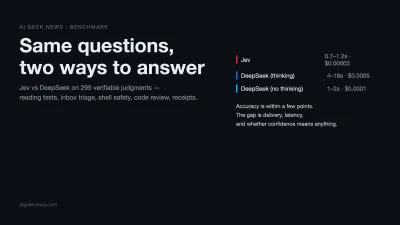
10の実シナリオ、確定的な答えを持つ66問、さらに229の検証問題、3つの比較アーム。精度差はわずか数ポイント、時間差は10倍、そして確率の使い方はまったく異なる。
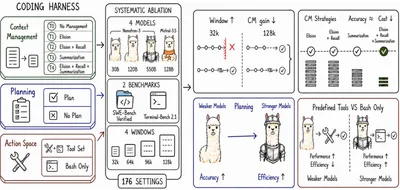
コーディングフレームワークは、自律コーディングエージェントがモデル能力を長周期ソフトウェアエンジニアリング性能へと変換する方法を決定するが、通常はモノリシックシステムとして評価される。本研究では実行ループを固定し、SWE-Bench VerifiedとTerminal-Bench上で4つのモデルに対して3つのコンポーネント(計画、行動空間、コンテキスト管理)を一つずつ変更する。
ZCodeはログイン状態でワークスペース全体と完全なGit履歴を無言でパッケージ化してクラウドオブジェクトストレージへアップロードし、復号用秘密鍵はサーバー側にのみ保存される。本記事ではローカルフォレンジックとクライアントコードのリバースエンジニアリングにより完全なアップロード経路と暗号化機構を復元し、ファイルシステムの不変ロックによってこの行為を完全に阻止する方案を示す。
Claude Code 2.1.277 はプロジェクトに CLAUDE.md がない場合、AGENTS.md を読むようになった。Codex、Amp、Jules、Cursor などが共同で提唱し、現在は Linux Foundation がホストするこのオープンなフォーマットを、これまで独自路線を歩んできた Claude Code が初めて受け入れた。
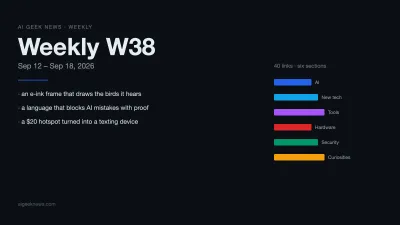
今週40本。鳥を描く電子ペーパー、AIに鎖をかける証明言語、20ドルのホットスポットをSMSマシンに改造、そして警察が「LMAO」を理由に19,000台のカメラを捜索。
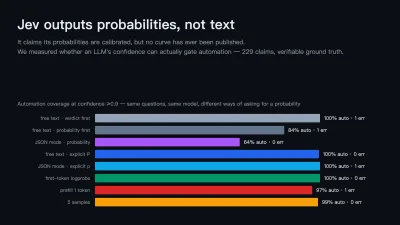
TypeSafe AI の Jev はモデル出力を文字列から確率付きの型付き判断に置き換え、その確率は「校准」済みだと主張している。この前提を裏付ける証拠は誰も示していない。そこで確定した答えのある 229 件の主張を使い、通常の LLM の信頼度が自動化に使えるかどうかを測った。
Expo と Convex は、「アプリはあるのにバックエンドがない」という段階をコマンド1つに圧縮した。プロジェクトの自動作成、環境変数の書き込み、型の生成までこなし、あとは useQuery がデータに追随して自動で更新される。
3つのAIモデルがそれぞれ一度に3つのExpoアプリを作成し、20億以上のトークンを消費して2,000ドルを費やし、Fable 5がコードとUIの品質で勝利した。
SDK 58 beta では iOS 27 と Liquid Glass への対応、Expo Modules 2.0、コールドスタート時のバンドルが約2倍速くなる Rust トランスフォーマー、そして一連の破壊的変更が導入される。Expo Go は当面 CLI 経由でしかインストールできない。
NVIDIA は Rust ネイティブのカーネルプログラミングを二つの路線に分けた。SIMT はスレッド単位の制御を残し、Tile はスレッドマッピングをコンパイラに任せる。どちらのプロジェクトもまだ初期段階だが、境界線はすでに引かれている。