2026年Rust中SIMD的现状
Fearless SIMD 维护者撰写的年度 SIMD 库调研,对比 std::simd、wide、pulp、macerator 并详解 x86 指令集兼容难题。
更多 性能
首页Fearless SIMD 维护者撰写的年度 SIMD 库调研,对比 std::simd、wide、pulp、macerator 并详解 x86 指令集兼容难题。
在 PlanetScale 上创建 Postgres 或 Neki 集群时,aarch64 与 x86-64 即便 vCPU 和内存相同,性能也可能相差悬殊,且创建后无法更换架构。
bfcacheMetricsIntegration 将 3 个 bfcache 信号转为应用指标,已在 JavaScript SDK v11 上线,可追踪返回键的瞬时体验。
作者让 agentic LLM 反复迭代优化 Rust 代码,结果比现有最先进的库还快 2 到 20 倍,再用 PyO3 桥接把收益带回 Python。
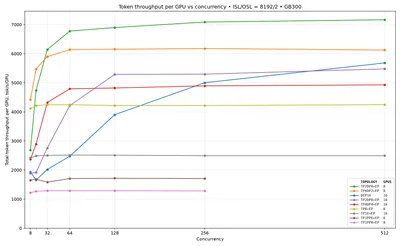
在 GB300 NVL72 上跑 Qwen3.8-2.4T 的 PD 分离部署:高吞吐场景每 GPU 达到 5,000 总 token,低延迟场景每用户 180 个生成 token,两端落在同一条帕累托前沿上。
Postgres 的全文检索从索引结构讲起:GIN 索引怎么把词映射到行、为什么 `LIKE '%x'` 用不上索引、trigram 索引在模糊匹配上的代价,以及 PlanetScale 在这个引擎上做的取舍。
vLLM 集成 PyNvVideoCodec 硬件解码,视频描述吞吐量在 8 块 GPU 节点上仍可线性扩展。
Redis 8.10 发布,紧凑哈希把内存占用最多降低 50%、加载吞吐翻倍,另外带来增量备份恢复、更完整的 JSONPath 查询,以及 Streams 与 Time Series 的若干新命令。
编码智能体把移动应用的构建成本降了两次,Shopify 因此从 React Native 回到 Swift 和 Kotlin;作者解释了让核心假设改变的是什么,以及这次迁移的代价与收获。
Spark 的 Real-Time Mode 负责连续计算、Redis 负责毫秒级读取,两者分工把个性化推荐和欺诈评分压进请求路径,文章还配了一个能跑通的示例仓库。
Google Research 提出 Retrieve-for-Train,用强化学习训练轻量级扩散模型,绕过推理期思考预算,单次前向即可生成连贯的 fan-out 搜索结果。
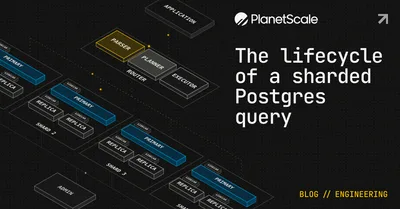
Postgres 分片到千台服务器后,一条 SELECT 如何穿越认证、wire protocol 与分布式查询规划器,Neki 路由器用 Go 复刻 SCRAM-SHA-256 并同时支持 Simple 与 Extended 协议。
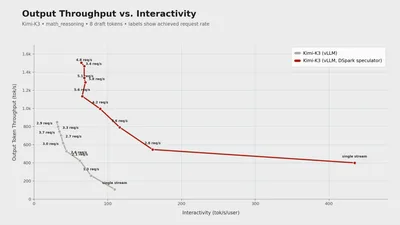
vLLM 把 Speculators 训练库扩展到支持 2.8 万亿参数的 Kimi K3:用 4 位量化的目标模型配一个五层、50 亿参数的 DSpark 草稿模型,数学推理单流交互性从约 110 提到约 435 tok/s/user,并发下相同交互性时输出吞吐最高约 3.5 倍,首 token 中位数只涨 100 毫秒。
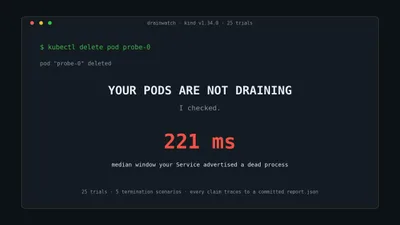
drainwatch 用 25 次实测拆开 Kubernetes 的优雅关闭,立即退出的 Pod 在 45 毫秒内被 RST 切断 TCP,Service 却还能对外通告已经死掉的进程 221 毫秒。
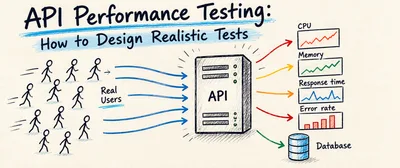
性能测试不是往接口上乱发一堆请求。作者先讲了负载、压力、耐久、尖峰、容量、可扩缩六类测试各自回答什么问题,再重点讲怎么设计贴近真实的场景:从用户路径、用业务量反推 RPS 的算法,到外部服务要不要 mock、环境与数据库该怎么配。
PlanetScale 发布 Postgres 全文搜索扩展 TIN,直接拿 48 位 ctid 当 posting 的原生格式,在 85 GB、1.5 亿篇文档的基准里吞吐量至少比 ParadeDB、pg_textsearch 与内置 GIN 高 8 倍,建索引用 8 分 10 秒。
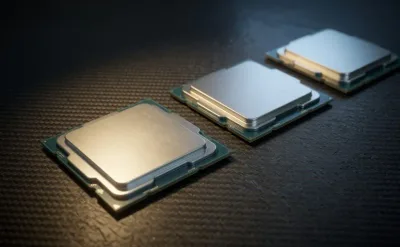
同为 8 核带 3D V-Cache 的 Ryzen 7,两年间 Geekbench 6 单核快 47%、全核快 58%,而最高频率只涨了 15%。文章用四组数据说明性能来自哪里:晶体管多 50%、派发宽度 6→8、重排序缓冲区 256→448、SIMD 从 256 位加到 512 位。
Reanimated 4 稳定版发布,新增兼容 CSS 的声明式动画 API,可取代部分 worklet 场景。
了解我们如何帮助 Discord 将其应用迁移到 React Native 的新架构,解决 Fabric、Reanimated、Screens 等方面的挑战。
在智能体出现之前,这种规模的改写是负担不起的。以下是将Copilot智能体运行时移植到80万行生产级Rust代码实际需要付出的代价。
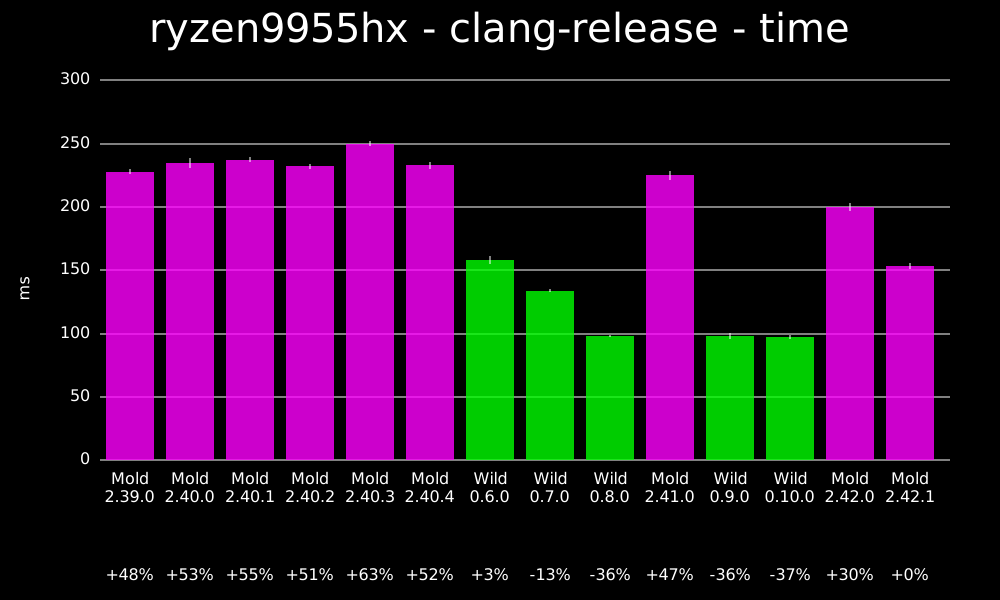
Mold 最近更新了他们的链接器基准测试,并首次将 Wild 纳入其中。这些基准测试显示,Wild 比 Mold 慢了不少,这与我们 8 月 4 日上次发布时 Wild 最新公布的基准测试结果相反。
Go 1.27 让 80 字节及以下的分配获得了更快的内存分配。 这类分配最多可快 20-30%,使分配密集的程序最多快 1%。 Go 运行时通过引入特化函数来提升这些分配的性能, 这些函数专门用于分配特定尺寸。
Cloudflare 的全球网络庞大,但并非没有极限。团队在寻找削减资源用量的小办法时,有时会撞上大幅降低用量的机会。这篇文章讲他们怎么把一个基于 Pingora 的服务的内存占用压下来,以及为什么这事儿没那么简单。
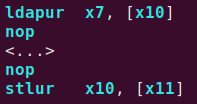
在 ARM 的弱定序内存模型上模拟 x86-TSO,是模拟器里长期存在的坑。模拟器要自己补回全存储定序才算正确,代价是大量内存屏障,性能与正确性难以两全,文章梳理了问题根源与几种做法的取舍。