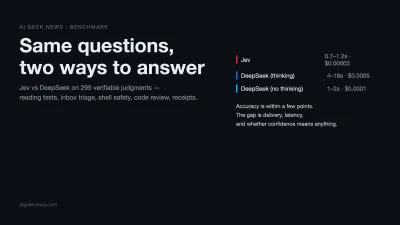
Jev 和 DeepSeek 做了同一批判断题,差别不在谁更聪明
十个真实场景、66 道有确定答案的题,外加 229 道核对题,三条对比臂。准确率只差几个点,时间差十倍,而概率的用法完全不同。
更多 开发工具
首页十个真实场景、66 道有确定答案的题,外加 229 道核对题,三条对比臂。准确率只差几个点,时间差十倍,而概率的用法完全不同。
176 组配对实验、四款模型、两个基准:规划对弱模型是精度脚手架、对强模型是省钱工具;让被裁剪的上下文可恢复几乎没人用;预定义工具只对 bash 弱的模型有明显收益(+15.0%),bash 强的模型只给 bash 更便宜。
ZCode 在登录状态下会静默打包整个工作区及完整 Git 历史上传至云端对象存储,且解密私钥仅存服务端;本文通过本地取证与客户端代码逆向还原完整上传链路与加密机制,并给出通过文件系统不变锁彻底阻断该行为的方案。
Claude Code 2.1.277 在项目没有 CLAUDE.md 时会改读 AGENTS.md。这个由 Codex、Amp、Jules、Cursor 等共同发起、现已由 Linux Foundation 托管的开放格式,第一次被此前各行其是的 Claude Code 接受。
本周 40 条。会画鸟的墨水屏、给 AI 上镣铐的证明语言、把 20 美元热点改成短信机,还有警察用「LMAO」当理由搜了 19,000 台摄像头。
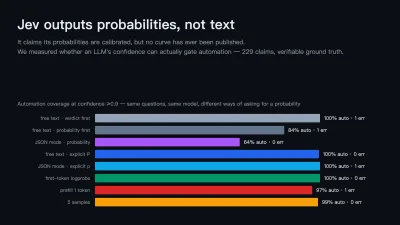
TypeSafe AI 的 Jev 把模型输出从字符串换成带概率的类型化判断,还声称概率是「校准」过的。这个前提没有人给过证据——我们拿 229 条有确定答案的声明,量了普通 LLM 的置信度到底能不能用来做自动化。
Expo 和 Convex 把「应用有了、后端还没有」这段路压成一条命令:自动建项目、写环境变量、生成类型,之后 useQuery 会自己跟着数据更新。
三个 AI 模型各一次性做出三个 Expo 应用,烧掉 20 多亿 token、花费 2,000 美元,Fable 5 在代码与 UI 质量上胜出。
SDK 58 beta 带来 iOS 27 与液态玻璃适配、Expo Modules 2.0、冷启动打包快约两倍的 Rust 转换器,以及一批破坏性变更;Expo Go 暂时只能通过 CLI 安装。
NVIDIA 把 Rust 原生 kernel 编程分成两条路线:SIMT 保留线程级控制,Tile 让编译器决定线程映射;两个项目都还早,但边界已经画清楚。