デプロイに失敗しました。リソースはまだ実行中です。
デプロイコマンドが構成段階で失敗したとき、ネットワークと仮想マシンはすでに作成され稼働したままである。非ゼロの終了コードはそのプロセスの状態を述べるだけで、リモートシステムの状態ではない。したがって復旧は再実行ではなく、状態を持つワークフローに頼るべきである。
デプロイコマンドが構成段階で失敗したとき、ネットワークと仮想マシンはすでに作成され稼働したままである。非ゼロの終了コードはそのプロセスの状態を述べるだけで、リモートシステムの状態ではない。したがって復旧は再実行ではなく、状態を持つワークフローに頼るべきである。
エラーを記録することとエラーから学ぶことは別物だ。6つのagent memoryシステムのうち4つは否定的な判定を含むフィードバック入力を公開しているが、Mnemoverse自身が公表した測定ではこのシグナルはほとんど呼び出されていない。
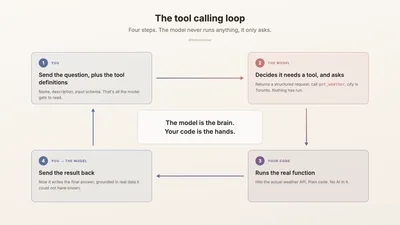
モデルは何も自分で実行せず、構造化されたツール呼び出しリクエストを返すだけです。あなたのコードが実際の関数を実行し、その結果をモデルに返して回答させます。この記事では、この4ステップのループをゼロから分解して解説します。
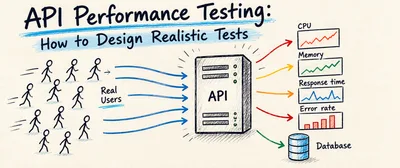
性能テストは、インターフェースにやたらと大量のリクエストを送ることではない。著者はまず、負荷、ストレス、耐久、スパイク、キャパシティ、スケーラビリティの6種類のテストがそれぞれ何に答えるのかを説明し、次に現実に即したシナリオをどう設計するかに重点を置いて、ユーザーパスから業務量をもとにRPSを逆算するアルゴリズム、外部サービスをモックするかどうか、環境とデータベースをどう構成すべきかに至るまで解説している。
技術者が職業アイデンティティを自分の全てだと思うと、社交しないほど居心地が悪くなる悪循環に陥る。筆者は、技術コミュニティ以外の趣味や場を通じて、その練習を取り戻す方法を書いている。
著者は、問題は人々がAIを使うことではなく、「動くものを手に入れた」ことがいつの間にか「なぜ動くのかを理解している」と見なされていることだと言う。彼は読書会アプリを作り直した経験と、2台目のモニターにしか現れない通知バグについて語り、その線引きをレビュー、デバッグ、そして自分が何を作ったのかを本当に知るという段階に置いている。
LEGO デスクトップロボット DinoDesk AI は、Raspberry Pi とローカルゲートウェイで Gemma 4 と Gemini Flash を切り替え、カメラなし、ローカル会話はゼロコスト。
著者が書いているのは新しい種類の疲労だ。残業のような目に見える疲れではなく、ツールが毎週変わり、期待の水位が静かに上がり続けることによる疲れ。彼はその重さをいくつかの具体的な事柄に分解し、なぜ皆が平気なふりをするのか、そして何が本当に役立つのかを説明する。
AIへの依存で最も深刻な結果はコードの劣化ではなく認知の退化だと著者は考える。プロンプト、受け入れ、繰り返しの間にレビューの工程が欠け、偽りの信頼が次々と連鎖していく。著者は毎日プログラミング問題を一問解き、録画して解説する対抗法と、自らの手でデバッグして得た確かな手応えについて綴っている。
GPT-6 Astraの公開後、著者は「モデルがどれだけ強いか」から、より見落とされがちな問題へと目を向けた。モデルが強くなっていることを、私たちは一体どうやって知るのか。ベンチマークは飽和し、代理指標が使われ、真値の出所は複雑で、採点方法も変わる。記事はスコアを見るときに問うべき5つの問いを提示する。
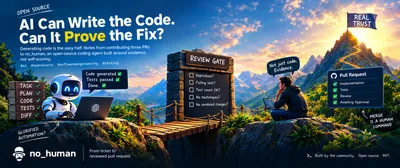
AI が生成した変更を人間が信頼するにはどんな証拠が必要か。著者は no_human に出した3つの PR を通じ、改ざん防止ガード、再現ゲート、敵対的レビューがそれぞれどの種類の失敗を防ぐかを明らかにした。
Rustを7年間書いてきた著者がZigでJSONPathライブラリを作り直した:IDEサポートなし、構造は強制的にフラット化、関数型パラダイムは使えず、allocatorが至る所に。4種類のメモリリークと二重解放の形を一つずつRustと対照し、最後にZigはCの真の後継者になる潜在能力があると述べた。
PlanetScaleがPostgres全文検索拡張TINをリリース、48ビットのctidをそのままpostingのネイティブ形式として使用し、85 GB・1億5000万文書のベンチマークでスループットがParadeDB、pg_textsearch、組み込みGINより少なくとも8倍高く、インデックス作成は8分10秒。
AI にブログ記事、リサーチレポート、メモのような実質的な内容のテキストを書かせるのは、十分な要点と文脈を与え、後から自分で編集したとしても、ほぼ決してすべきではないと著者は主張する。書くこと自体が思考であり、AI の文章は気づきにくいところで曖昧に誤り、明示しなければ失礼かつ人を誤導するからだ。
Dan Luu は 2025 年初から、LLM を使うときに頭を切る人々を見てきた。結論は明快だ。LLM が「頭を切っても」平均的なソフトを作れるほど強くなったら、会社は LLM をループで走らせてその人を解雇すればいい。
「モデル × 推論設定」19 構成の総当たり戦。Codex Astra が全勝で首位、Grok 系は 43 分でコマンド 6 バッチのみ・戦闘ユニットゼロ、Claude Fable だけが経済とテックを真面目に回した。著者の結論は、初心者レベルを超えた agent は皆無。
同じ 8 コア・3D V-Cache の Ryzen 7 が 2 年で Geekbench 6 のシングルコア +47%、全コア +58%。最大クロックの伸びは 15% にすぎない。トランジスタ +50%、ディスパッチ幅 6→8、リオーダーバッファ 256→448、SIMD は 256→512 ビットへ。
著者の主張はこうだ。コンピュータ化された世界で科学するには、オープンソースソフトウェアが必要条件である。再現可能とは実行可能かつ改変可能であることで、科学の結果はソフトウェアに依存し、ソフトウェアが誤れば科学も誤る。
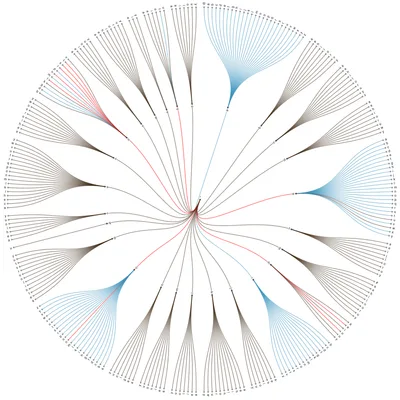
英語の a/an は文字ではなく音で決まる。unicorn は a、hour は an。著者は cmudict で初音と頭文字の規則を比較し、32,455 語から例外を抽出、最終的に 25 行の Python ルールに落とし込んだ。
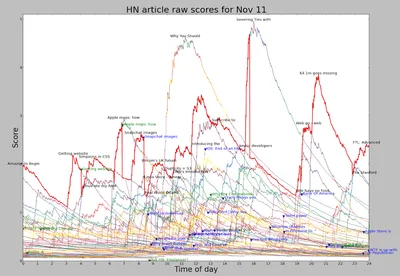
著者は数日間 HN の上位 60 記事を追跡して逆解析した。公開式はほぼ正確だが、フロントページの 20% はペナルティを受け、タイトルに NSA があると 0.4 倍、コメントが票より多く 40 件に達すると「論争」判定で一瞬で消える。
Servo のパートタイムメンテナ Josh Bowman-Matthews が寄付に支えられた 1 年を振り返る。新メンテナ 8 名の推薦、1150 件の PR レビュー、新人向け issue 114 件の起票(92% 修正済み)など。
Bend 2 のデモは「法則」の宣言に 58 行、証明に 442 行。著者は同じプログラムを形式検証の SPARK で作り直し、不変条件を示すだけで GNATprove が 12 項目すべてを検証したと指摘する。
Gowers は「危機に直面している」ことに同意しつつ、「概念的理解が問題解決より上位」という唯一の正解には与しない。数学者の動機をスペクトラムとして捉え、モデルが人間を全面的に超える未来と、公開が国際的に制限される未来を比較する。
著者は毎日の 7 割以上を AI 対応に費やし、仕事の楽しみを失ったと書く。規制を求める一方で拡大を続ける AI 企業、脆弱性の発見に資源を投じるセキュリティ業界、「ループに入った人間」のゴム印化を批判する。