AI規範と価値観、第3部(全3部):私たちが信じるもの
Honeycomb の AI 規範と価値観シリーズの最終回は、彼らが何を守ることを選んだのかを語る。著者はこの立場を倫理宣言ではなく仕事上の約束と呼び、Dr. Cat Hicks との今後の対話にも触れている。
Honeycomb の AI 規範と価値観シリーズの最終回は、彼らが何を守ることを選んだのかを語る。著者はこの立場を倫理宣言ではなく仕事上の約束と呼び、Dr. Cat Hicks との今後の対話にも触れている。
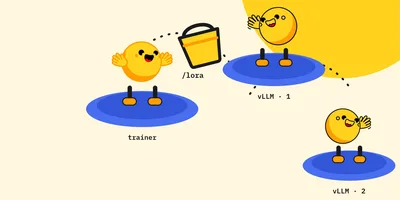
AsyncGRPOTrainer が rank-1 LoRA adapter だけを学習・同期し、HF Jobs 間は NCCL ではなく Storage Bucket 経由。500 ステップの学習が 3 時間 27 分から 53 分に短縮。
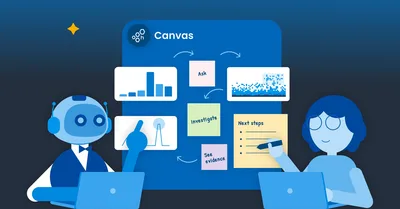
Honeycomb Canvas はテレメトリ、GitHub、Linear、Slack を一つのループにつなぎ、それを使って自社の調査エージェントを開発し、ユーザーより先に問題を発見する。
Rustコンパイラチームは年次調査のうちデバッグに関する部分を個別にまとめた。開発者が最も切望しているのは最適化ビルドのデバッグ性と、非同期コード、マクロ展開、ジェネリクスのインスタンス化におけるステップ実行能力だ。記事は課題の優先順に調査結果と今後の方針を挙げている。
60% の組織が AI エージェントを本番環境に導入済みで、Docker は microVM サンドボックスで自律エージェントの認証情報とネットワークアクセスを分離しています。
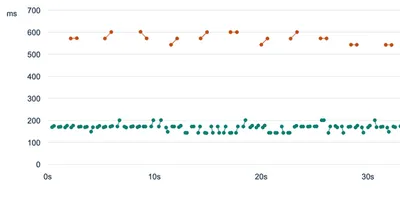
著者はQwen3-8BをSystem One分類器として接続した後、2つの手法を試した。階層的目標(10秒ごとに戦略、5秒ごとに戦術、200ミリ秒ごとに実行)とトーナメントサンプリング(一度に100個のリンクを2ラウンドで選別)で、後者はWikiracingで理想的な3リンク経路を見つけた。
Postgresが千台のサーバーにシャーディングされた後、1つのSELECTが認証、wire protocol、分散クエリプランナーをどう通過するか、NekiルーターはGoでSCRAM-SHA-256を再実装しSimpleとExtendedの両プロトコルをサポート。
DeepMindがAlphaGenomeの予測をゲノム規模で事前計算:1PBのデータセット、90億の一塩基変異をカバーし、影響を1つの数値に凝縮するAVIスコアを発表。共同研究者はこれを用いて未解明の希少疾患で原因変異を特定し、実験的に検証した。
Mistral は欧州のエネルギー事業者の Fortran 77 を 4 万行、C++ へ移行した。まず数値の一致を確かめる検証基盤を作り、100 を超える agent でドキュメントを補い、最終的に「人がコーディングとテストを回し、agent がレビューする」中間路線に落ち着いた。完全自律は採らなかった。
Po-Shen Loh が、数学者は制御を手放すべきという反論に応じた。人類の繁栄を助けるべきだという基本公理を置き、そこから推論の連鎖を導く。AI が進歩するほど人間が監視すべき制御点が増え、人手が足りなくなり、その職務が逆に AI を減速させる。 Loh
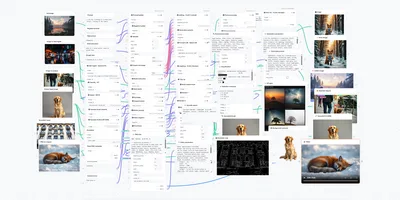
Hugging Face は AUTOMATIC1111 のほとんどの機能を同じ Gradio ワークフローキャンバス上に再構築しました。11 本のメディアパイプライン、73 個のノードで、テキストから画像生成、高解像度修復、画像から画像生成、プロンプトマトリクス、VLM 逆推論、検出からマスクへの変換、アノテーター、PNG Info、画像から動画への変換をカバーし、各出力ノードは自動的に REST エンドポイントと MCP ツールにもなります。
ChatGPT Admin Console の Analytics は Work と Codex の使用量、コスト、タスクのインサイトを集約し、管理者が AI の使われ方を把握できるようにします。
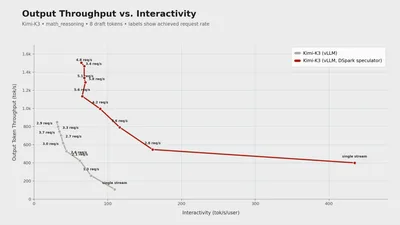
vLLMがSpeculatorsトレーニングライブラリを2.8兆パラメータのKimi K3対応に拡張:4ビット量子化ターゲットモデルに5層・50億パラメータのDSparkドラフトモデルを組み合わせ、数学推論の単一ストリーム対話性が約110から約435 tok/s/userに向上、同時実行時に同じ対話性で出力スループットが最大約3.5倍、初回トークン中央値は100ミリ秒のみ増加。
ChatGPTがSponsored Agentsの広告テストを開始、ユーザーは広告をクリックして企業がスポンサーするagentと対話可能、HubSpotとShopifyの統合も追加。
Cloudflare、グラフニューラルネットワークと LLM の再確認により、実トラフィックで 4 件の悪意ある JavaScript キャンペーン、計 8 個のペイロードを検知。うち 7 個は VirusTotal に全く存在しなかった。記事はそれぞれのゲート、クローキング、バックドアを個別に解剖し、侵害指標と防御者向けの 4 つの教訓を示す。
OpenAIが法務向けAstraを発表、GPT‑6 AstraはVals AIの法的検索ベンチマークで合格率54.0%、ウェブ検索版から40%向上。
Fishjam が MoQ(Media over QUIC)でリアルタイム AI 翻訳を実現:80 以上の言語をオンデマンド生成、ある言語のトラックを購読することがそのリクエストになり、シグナリングもバックエンドも不要;遅延はクライアント側のバッファリングで再生クロックを揃えて解決し、言語を切り替えても映像には触れない。
Kubernetes v1.37 で2つのストレージセキュリティ機能が追加:ボリュームマウント上の bind mount オプション(noexec / nosuid / nodev)と emptyDir の作成権限モード(sticky bit 01777 を含む)。前者は 1.24 のセキュリティ監査で指摘されていたギャップを埋めるもので、どちらもまだ Alpha ゲートの背後にある。
IBM Researchがエージェントの「一貫性」を診断:GPT-4.1のReActエージェントはAppWorldで平均77.4%合格だが、5回すべて合格したタスクは53.0%のみで、24.4ポイントの差。彼らは1回のサンプリングで覆りやすい意思決定点を見つけ、一貫性基準を生成し、差を12.0ポイントまで削減、平均精度は落ちなかった。
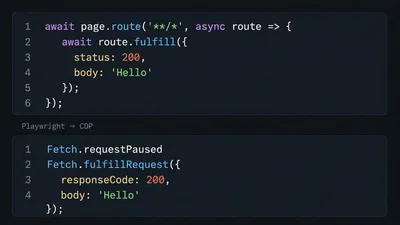
Playwright の page.route() が異なるブラウザでリクエストをインターセプトする方法と、Chromium DevTools Protocol だけで同じインターセプトを実現する方法。
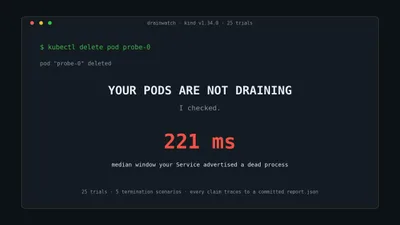
drainwatch が25回の実測でKubernetesのグレースフルシャットダウンを分解、即座に終了するPodは45ミリ秒以内にRSTでTCPを切断されるが、Serviceは死んだプロセスを221ミリ秒間外部に通知し続ける。
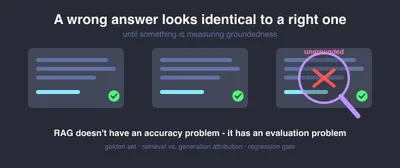
社内ポリシーボットはデモでは完璧に答えたのに、本番稼働後はすでに置き換えられた旧ポリシーに基づいて自信満々に回答し、いつ劣化が始まったかを知らせるシグナルも一切ない。この記事では、そのための回帰ゲートの作り方を解説する。
かつて素人スクレイパーを阻んでいた技術的障壁は、たまたま大規模言語モデルが最も得意とする種類のタスクにそれぞれ対応している。長年防御に携わってきた人物がそれらを一つずつ分解し、どの壁がどこで崩れたのか、そして防御がなぜ形骸化している可能性があるのかを説明する。
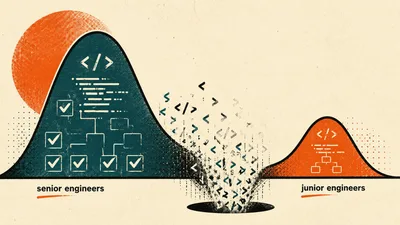
AIは劣悪なエンジニアを加速させ、Faros AIのデータはPRレビュー時間が441.5%増加したことを示し、JetBrainsは手戻り量が14倍の差があることを記録している。