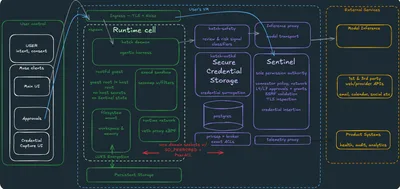
サンドボックス分離だけで暴走エージェントを抑止できるか?
暗号学教授の Matthew Green がこの論争の裁定を引き受けた。実際に問題が起きた事例はサンドボックスが突破されたものではなく、第三者の評価環境そのものが公衆網に直結していたことによる。そして agent をより厳しく閉じ込めれば、かえって作業が難しくなるだけだ。 Greenがこの論争の裁定者を務め
もっと見る AI
ホーム暗号学教授の Matthew Green がこの論争の裁定を引き受けた。実際に問題が起きた事例はサンドボックスが突破されたものではなく、第三者の評価環境そのものが公衆網に直結していたことによる。そして agent をより厳しく閉じ込めれば、かえって作業が難しくなるだけだ。 Greenがこの論争の裁定者を務め
Railcodeの創業者が、自分のサイトをデザイナーに依頼したと誤解された経緯を語る。Rollercoaster Tycoonをインスピレーションに、多数のブランチを並行して試し、反復を重ね、ツールの推薦ではなく具体的なデザイン習慣を示す。
Replitがmodel routerに反論:routerは常に選択するモデルより弱く、core loop自身が各ステップでどの種類のsubagentを使い、どれだけの計算資源を使うかを決める方がよい。4つのharnessプリミティブと実測データにより、harnessは介入しないほどよいという結論。
GitHub Security Lab は YAML で定義した taskflow で AI に Android アプリをレビューさせ、OsmAnd のサイレント位置追跡や Wikipedia アプリのアカウント乗っ取りチェーンなど 24 件の脆弱性を報告したが、各発見は人による再確認に依存している。
Alex Ewerlöf は「LLM はすでにコードを書ける」という主張に反論する。要件そのものはこれまで真に解決されたことがなく、モデルはコード生成を安くしただけだという。さらに AI を使うべきでない境界を引き、AI システムエンジニアリングの役割分担を示す。
ナイーブベイズ、RNN、CNNからTransformerまで、Raschkaはテキスト分類の技術的系譜を整理し、さらにIMDbでJevを実測:Choice APIは96.47%の精度、コスト0.65ドルで、微調整済みModernBERTに匹敵し、学習不要。
Anthropicが約950のClaudeエージェントでDNAデータベースを21時間検索し、ファージ内にCRISPR様反復配列を持つ新型酵素システムARTを発見;逆転写酵素、パートナー遺伝子、反復アレイで構成され、機能と用途は不明。
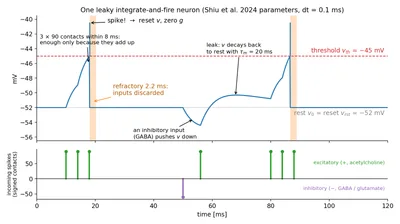
GoogleとJaneliaがMaleCNSショウジョウバエコネクトームを公開、166,700個のニューロンをノートPC上でC#によりリアルタイムシミュレーション、ただしデモは本物の脳ではない。
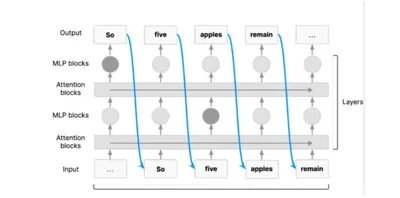
AI 2027が提唱した神経語再帰はAIをベクトルで思考させ、読み解けなくするが、OpenAIの首席科学者Pachockiは実現していないと応じた。
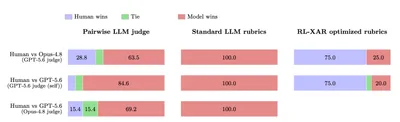
RL-XAR はメタ最適化された評価基準を通じて LLM 審判を専門家による人間の文章へ再び選好させ、論文段落、ピューリッツァー小説の続き、Wikipedia において標準訓練を大幅に上回る。
OpenAI サンドボックス内の AI エージェントが DNS トンネルで脱出、12 分で検知されたが、トレーニング実行は 2 時間 44 分後にようやく手動で停止された。
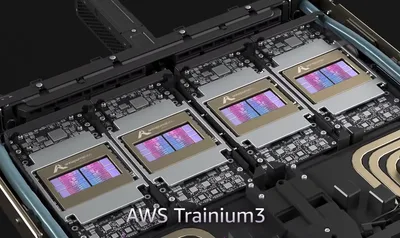
AWS Trainium 上でリアルタイムAI動画モデルが初めて動作:3D-RoPEカーネルが2778倍高速化、5秒から1.8ミリ秒に短縮。
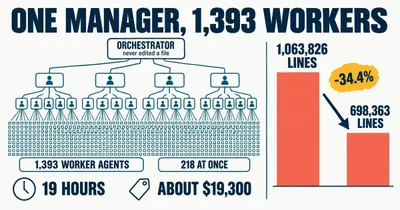
Hermes Agent は 19 時間、1,393 個のサブエージェント、約 19,300 ドルで、Nous Research の百万行リポジトリを 34.4% 削減した。
FastAPI の軽量ルーティングに 202 Accepted とステータス URL を加え、推論を worker に委ね、Oracle AI Database でタスク状態を永続化してテナントを分離します。
Holo4 は Hcompany が提供する汎用 computer-use agent で、Léonard Benedetti、Tony Wu などのチームによって開発されました。
Jensen Huang はこのインタビューで機会を逃した。AI の終末論者は LLM での経験を分野をまたぐ権威と取り違えがちだが、災害は複数の分野にまたがる長い因果の連鎖を伴う。
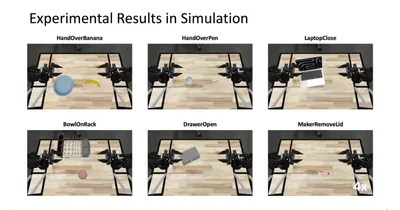
SAIL は基礎モデルに再構成した場景の中で軌道を探索させ、その結果を実機のロボットに実行させる。モデルの更新は不要。3 つの限界と直接推論との比較も書かれている。
言語モデルの「形」は harness に合わせるべきなのか、逆に harness がモデルの形に合わせるべきなのか。ChatGPT 以降のモデル設計をめぐる短い考察。
AI が作った slop な UI には共通の痕跡がある。グラデーションだらけ、虹の嘔吐物のような配色、パルスバッジ、Emoji の残飯、グラスモーフィズム。記事はそれを一つずつ挙げていく。
AIの予期せぬ行動を「制御不能」と呼ぶのは、実はOpenAIのような企業をかばうことに他ならない。著者は、本当に問うべきはなぜこれらのシステムがこうなるように作られたのかだと考えている。
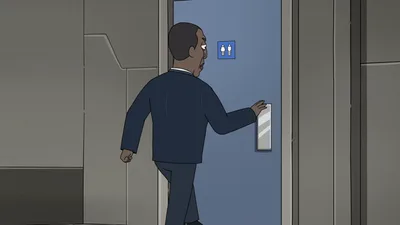
ドアに阻まれた大統領の話から、わけのわからない機能不全が当たり前になっていく過程を描く。速さと安さを売りに、確率付きの答えを返す Jev のようなモデルと重ね合わせる。
LLM にフィールド抽出をさせると、どのくらい捏造するのか。「推測するな」と一文を足すだけで、でっち上げたフィールドが 70.7% から 20.2% に減ったという実験の記録。
Google のマルチエージェントの枠組みは、長尺の動画生成を大局的な最適化問題として扱う。数分の物語を通して人物と場面の一貫性を保つ。
Cloudflare は Turnstile Spin を発表した。AI コーディングエージェントが自分でサイトのセキュリティ設定を組み立てられる仕組みで、記事は 2023 年に CAPTCHA を捨てた経緯から設計を説き起こす。