OpenAI 会不会吃掉 Jev 的午餐?
TypeSafe 的 Jev 用类型化决策换掉文本生成,速度和价格都占优,但作者认为护城河不深:模型能力一旦被通用模型吸收,OpenAI 这类玩家随时可以跟进。
更多 AI
首页TypeSafe 的 Jev 用类型化决策换掉文本生成,速度和价格都占优,但作者认为护城河不深:模型能力一旦被通用模型吸收,OpenAI 这类玩家随时可以跟进。
Nathan Lambert 给美国国会议员的开放权重模型简报:中国自 2025 年 7 月起在 Hugging Face 下载量上反超,主要靠阿里的 Qwen;AAII 等能力基准上也领先。美国头部实验室越来越闭源。
Alexandru Nedelcu 认为,把写代码和读代码都交给 AI 的人和组织是在冒险,因为代码可维护性没有可用的度量,坏架构的后果要几个月甚至几年才显现。他预测会有越来越多公司把 NO-AI 政策当成竞争优势来炫耀。
Cloudflare Workers 正式支持 Python,FastAPI、Django、Flask 可直接运行,还能绑定 Workers AI、R2、D1 等平台服务,冷启动与依赖管理都换成了原生方案。
Tripo 首席科学家曹炎培谈 AI 生成 3D 资产:Smart Mesh 5 秒内端到端输出带干净边流、可直接进游戏管线的模型。
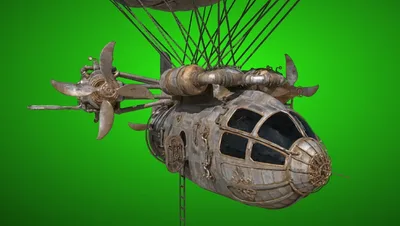
Miris CTO Sean Looper 谈如何用 AI 把 3D 资产摄取一次、流式传输到任意设备,从而摆脱游戏引擎与预渲染之间长达二十年的画质与交互性取舍。
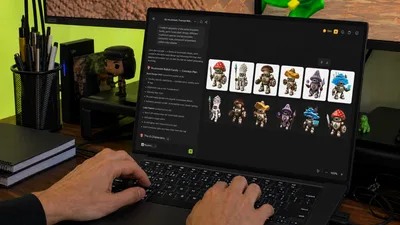
Meshy 开放 3D Agent Beta,用对话式多步骤工作流批量生成风格统一的游戏资产,已获 4 亿美元 B 轮融资。
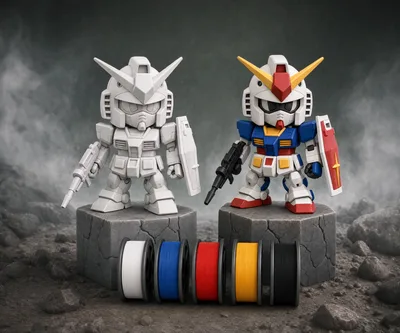
Hi3D 用 AI 把一句提示词变成可打印的定制装甲战士,自动修复网格并智能拆件,几分钟完成传统需数小时的建模流程。
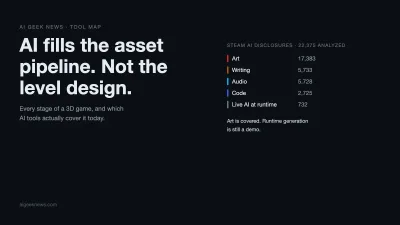
3D 游戏的 AI 工具已经铺满模型、贴图、绑定三段,按件计价,能直接拖进引擎试。关卡设计和引擎里的整合还没有能替人的工具,而免费档基本不能商用、AI 生成物在美国拿不到版权保护,这两个坑最后都落在开发者身上。
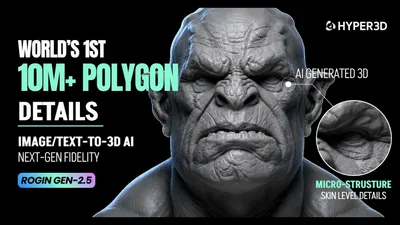
Hyper3D 的 Rodin Gen-2.5 更新聚焦 AI 3D 资产的生产管线整合,CTO QX Zhang 谈可控性为何比生成速度更关键。
Tripo 3.0 用 SparseFlex 表示法,P1.0 仅需 2 秒即可生成专业级 3D 模型,创始人 Simon Song 谈 AI 如何嵌入 UGC 实时管线。
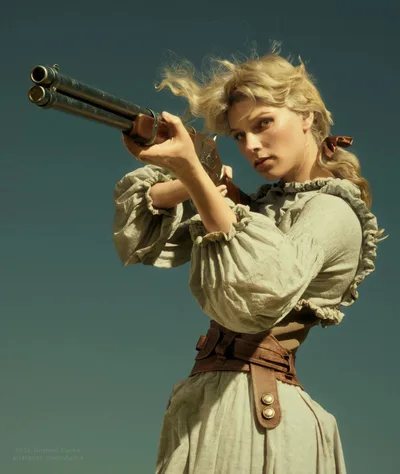
匈牙利3D艺术家用UE5 MetaHuman、Style3D Atelier和ZBrush复刻AI生成图,挑战接近AI质量的写实角色。
Nandakishor Mukkunnoth 说他在 2025 年 3 月就做出了 Jev 那套非自回归决策模型,为此写了一篇很长的 文章。我读了他引的两篇论文,也把他 2026 年的模型拿 229 道细粒度题跑了一遍,看到的和这个故事不太一样。
作者认为 LLM 的「智能」是一种统计学错觉,机制与灵媒的冷读骗局同源:观众自我筛选、场景预设、用确认式陈述引发主观验证,而 RLHF 因为只能按语气排序,等于把模型优化成了生成巴纳姆式陈述的机器。
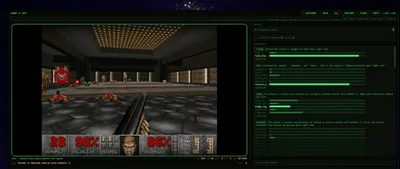
作者认为 Jev 的价值可能主要在推理策略而非模型本身。把回复预填成 choice 字段、再只生成一个受约束的 token,任何 LLM 都能拿到大部分「秘密配方」,他用 Qwen2.5-1.5B 试出了 2 到 3 倍加速。
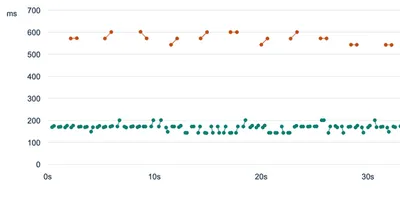
作者把 Qwen3-8B 接成 System One 分类器后试出两招:分层目标(每十秒定战略、每五秒定战术、每 200 毫秒执行)与锦标赛采样(一次喂一百个链接分两轮选),后者在 Wikiracing 里找到了理想的三链接路径。
DeepMind 把 AlphaGenome 的预测在基因组尺度上预先算完:1 PB 数据集、覆盖 90 亿个单核苷酸变异,并推出 AVI 分数把影响浓缩成一个数字。合作者已用它在一项未解罕见病里找到并实验验证了致病变异。
Po-Shen Loh 回应「数学家该让出控制权」的反对意见。他提出一条基本公理,我们应当帮助人类繁荣,并推出一条推理链,AI 越先进,需要人类盯的控制点就越多,多到人手不够,而这些岗位会反过来迫使 AI 放慢。
ChatGPT 广告测试 Sponsored Agents,用户可点击广告与商家赞助的 agent 对话,并新增 HubSpot 与 Shopify 集成。
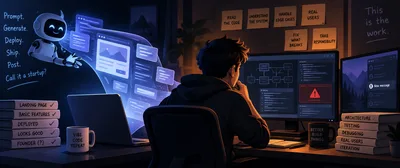
作者说,问题不在于人们用了 AI,而在于「手里有个能跑的东西」已经悄悄被当成「明白它为什么能跑」。他讲了自己重做一个读书会应用的经历,以及一个只在第二块显示器上出现的通知 bug,把界线画在审阅、调试和真正知道自己建了什么那一段上。
作者写的是一种新的累。它不像加班那样看得见的疲惫,而是工具每周都在变、期待的水位一直在悄悄抬高的那种。他把这份重量拆成几件具体的事,说明为什么大家都装作没事,以及什么才真的有用。
作者认为 AI 依赖最突出的后果是认知退化,代码变差还在其次。提示、接受、重复,中间少了审阅这一步,虚假的信任还会一环环往下传。他写了自己每天解一道编程题并录像讲题的对抗方法,以及一次亲手调试换来的踏实感。
GPT-6 Astra 发布后,作者把注意力从「模型有多强」转到一个更容易被忽略的问题:我们到底怎么知道模型在变强?基准会饱和、会用代理指标、真值来源复杂、评分方法也会变,文章给出一套看分数时该问的五个问题。
作者主张,用 AI 写博客、研究报告、备忘录这类有实质内容的文本,即使给足要点与上下文、事后又亲自编辑,也几乎永远不该做:写作本身就是思考,AI 的文字在难以察觉处含糊出错,不标明还失礼且误导人。