誰もFOSSにお金を払いたがらないが、我々は払わせることができる
著者は進化的安定戦略でオープンソースがなぜ常に無料で勝つのかを説明し、その後、本当の金はとっくにJFrog、Snyk、Dockerといった「信頼できる供給」を売るベンダーに流れていると指摘する。彼の提案はただ一言:レジストリは企業から料金を徴収し、その一定部分を依存関係ツリーに沿ってメンテナーに分配すべきだ。
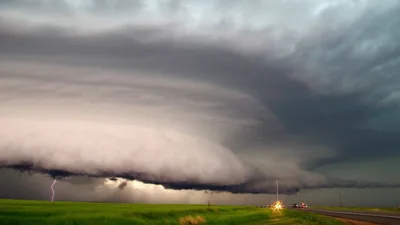
NOAA选择Tomorrow.io助力推进美国天气预报
NOAA は地球予測イノベーションセンター(EPIC)の支援先に Tomorrow.io を選定。EPIC は NOAA の 業務予報モデル群の支柱で、次世代の統一予報システム(UFS)の開発を加速する。
LLMentalist効果:チャットベースのLLMが霊媒詐欺の手口を再現する仕組み
作者はLLMの「知能」は統計的な錯覚であり、その仕組みは霊媒のコールドリーディング詐欺と同源だと考える。観客の自己選別、場面の前提設定、確認的な陳述による主観的検証の誘発であり、RLHFは口調でしか順位付けできないため、モデルをバーナム的陳述を生成する機械へと最適化してしまったのだ。
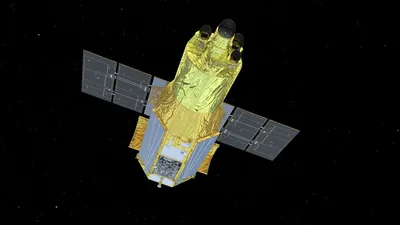
NASAとJAXAのXRISMミッション、パルサーが伴星の「風」を集める様子を観測
XRISM が、パルサー GX 301-2 が青色超巨星 Wray 977 の星風を取り込む様子を初めて直接観測。降着円盤の 形成・崩壊、そして逆向きの再形成までを捉えた。
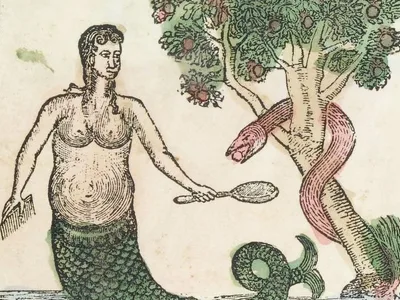
変身譚:初期近代のめくり絵本における変容(19世紀初頭)
19 世紀のめくり絵本 Metamorphosis では、アダムがイブに、イブが人魚に、獅子がグリフォンに、 そして鷲に変わる。子どもたちに死の避けがたさも教えた。
歯を食いしばって、それを送り出せ
得意な構築と得意な納品は別のスキルであり、短期的には互いに打ち消し合う。品味が高いほど納品を嫌がる。著者は自身のブログ執筆経験から、なぜ納品に傾くべきかを説明する——当時どれがよく書けていたか分からず、どの記事が受けるかも全く予測できない。
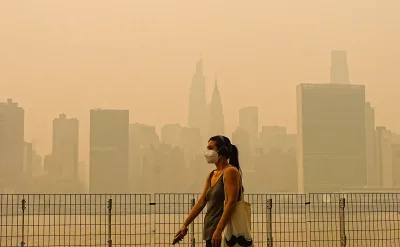
高度22000マイルから、この衛星は空気中の健康リスクをほぼリアルタイムで追跡する
NASA の TEMPO 衛星が、北米の汚染物質の生成と移動を初めて毎時で追跡。山火事の煙でポートランドの 大気質が世界最悪になった経緯を明らかにする。
シニアエンジニアの死のスパイラル
新たにシニアエンジニアに就任した友人への助言:自分を証明したい焦りから数週間姿を消して大きな成果に取り組むほど、燃え尽きと離職の螺旋に陥りやすい。むしろ一段下がって最高のチームメイトになることが解決策であり、結果志向をモメンタム志向に切り替えるべきだ。
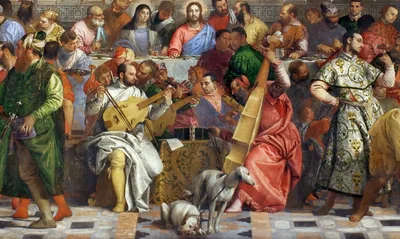
ヴェロネーゼの犬
ヴェロネーゼの絵に繰り返し登場する犬は、美術史家からルネサンスで最も犬を愛した人と呼ばれたが、宗教裁判所はその犬愛のゆえに彼のもとにやって来た。
Weaveツールを5つ試してみよう——あなた自身のものもぜひ共有してください
WeaveツールがFigma Communityに公開可能に、記事が試す価値のある5つを厳選:ムードボードをリアルな部屋のレンダリングに変えるものから、建築コンセプトスケッチや次のネイルのプレビューまで。
主権的でオープンウェイトなAIを技術の最前線へ
Mistralが30億ユーロのシリーズDラウンドの資金調達を完了、Samsung Electronicsが主導し、評価額は210億ユーロ超。欧州テック企業史上最大の株式調達。
Mistral x Mozilla:プライベートで多言語対応のAIブラウジング
MistralがMozillaと提携し、MistralモデルでFirefoxのスマートウィンドウ(ベータ版)を支え、フランスと北米のユーザーに先駆けてプライベートな多言語AIブラウジング体験を提供。
MilleMiglia:中距離物流向けのリアルなインスタンス生成器
MilleMiglia は C++ のオープンなインスタンス生成器で中距離物流のベンチマーク空白を埋め、 独自データに縛られずに跨拠点のリレー輸送を最適化できるようにする。
DatabricksとRedisによるリアルタイムパーソナライゼーションの実現
Spark の Real-Time Mode が連続計算を担い、Redis がミリ秒単位の読み取りを担う。この役割分担により、パーソナライズ推薦と不正スコアリングをリクエストパス内に収めている。記事には実行可能なサンプルリポジトリも付属。
Jevが構造化出力を再び面白くする
著者は、Jevの価値は主にモデル自体ではなく推論戦略にある可能性があると考えている。返信をchoiceフィールドに事前入力し、制約されたトークンを1つだけ生成すれば、どのLLMでも「秘密のレシピ」の大部分を得られる——彼はQwen2.5-1.5Bで2〜3倍の高速化を試し出した。
推論のボトルネックを回避:Retrieve-for-Train で複雑な AI 検索を高速化
Google Research の Retrieve-for-Train は、軽量な拡散モデルを強化学習で一度だけ訓練し、 推論時の思考予算を迂回して一貫した fan-out 検索結果を 1 回の順伝播で生成する。
魚と熊の手を同時に得る:検索での発見可能性を保ちながらAIトレーニングを禁止する
CloudflareがAIトレーニングを拒否する設定を導入、AI学習クローラーを拒否しつつ検索インデックスは維持、Apple、Google、Microsoftが遵守を約束。
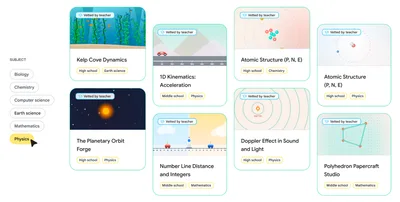
実践の未来:教師が生成UIで学習インタラクティブを作れるようにする
Google Research は教師が生成 UI で任意の STEM トピックのインタラクティブシミュレーションを生成できるようにし、教師が審査した 30 以上のモジュールを公開、12 名の教師の平均評価は 10 点満点中 8 点。
AI規範と価値観、第3部(全3部):私たちが信じるもの
Honeycomb の AI 規範と価値観シリーズの最終回は、彼らが何を守ることを選んだのかを語る。著者はこの立場を倫理宣言ではなく仕事上の約束と呼び、Dr. Cat Hicks との今後の対話にも触れている。
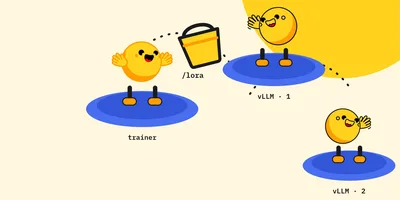
HF Jobs上でLoRAを使った非同期GRPO:バケット1つ、プロキシ1つ、NCCL不要
AsyncGRPOTrainer が rank-1 LoRA adapter だけを学習・同期し、HF Jobs 間は NCCL ではなく Storage Bucket 経由。500 ステップの学習が 3 時間 27 分から 53 分に短縮。
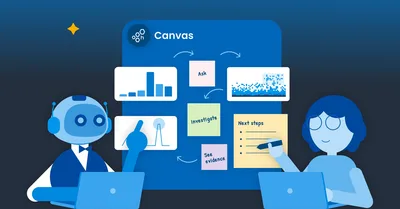
Canvas が AI Agent 開発のフィードバックループをどう駆動するか
Honeycomb Canvas はテレメトリ、GitHub、Linear、Slack を一つのループにつなぎ、それを使って自社の調査エージェントを開発し、ユーザーより先に問題を発見する。