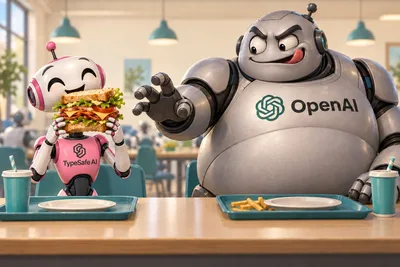
OpenAI は Jev の昼食を食べてしまうのか?
TypeSafe の Jev はテキスト生成を型付きの意思決定に置き換え、速度と価格で優位に立つ。だが著者は堀が浅いと見る。能力が汎用モデルに吸収されれば OpenAI などが追随するだけだ。
もっと見る AI
ホームTypeSafe の Jev はテキスト生成を型付きの意思決定に置き換え、速度と価格で優位に立つ。だが著者は堀が浅いと見る。能力が汎用モデルに吸収されれば OpenAI などが追随するだけだ。
Nathan Lambert が米国議会議員向けに行ったオープンウェイトモデルのブリーフィング。中国は2025年7月以降 Hugging Face のダウンロード数で逆転し、AAII でも先行。米国のトップラボは閉鎖的になり、地位が揺らぐ。
AIがコードを書いても読まない、vibe codingプロジェクトが数ヶ月後に保守不能な泥沼と化す理由
Cloudflare Workers が Python を正式サポート。FastAPI、Django、Flask がそのまま動き、Workers AI、R2、D1 などのバインディングも使える。
Tripo 首席科学者曹炎培、AI生成3Dアセットを語る:Smart Meshは5秒以内にクリーンなエッジフローを備え、そのままゲームパイプラインに投入できるモデルをエンドツーエンドで出力。
Miris CTO Sean Looperが語る、AIで3Dアセットを一度取り込み任意のデバイスにストリーミングし、ゲームエンジンとプリレンダリングの間で20年続いた画質とインタラクティブ性のトレードオフからの脱却。
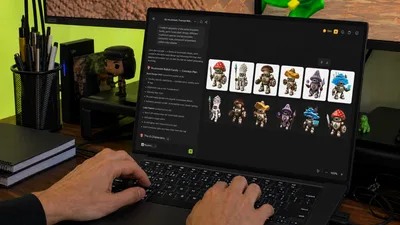
Meshy が 3D Agent Beta を公開した。対話型の多段階ワークフローで、スタイルの揃ったゲームアセットをまとめて生成できる。概念検討や背景オブジェクトの量産向けで、主役級のアセットの最終仕上げは依然としてアーティストの仕事だ。
Hi3D は AI で一言のプロンプトを印刷可能なカスタムアーマー戦士に変え、メッシュを自動修復しインテリジェントに分割、従来数時間かかるモデリング工程を数分で完了。
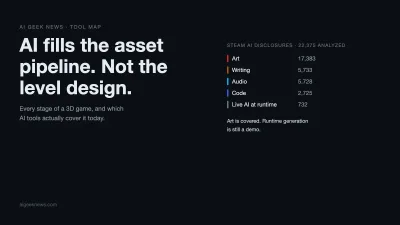
3DゲームのAIツールはモデル・テクスチャ・リギングの3段階をすでに網羅し、出来高制で価格設定され、エンジンに直接ドラッグして試せる。レベルデザインとエンジン内の統合はまだ人に代われるツールがなく、無料枠は基本的に商用利用不可で、AI生成物は米国で著作権保護が受けられないという2つの落とし穴は、最終的に開発者が負うことになる。
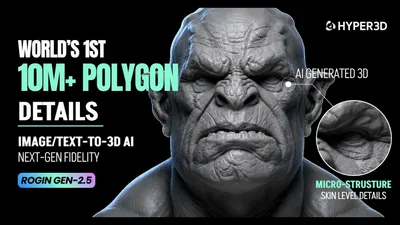
Hyper3DのRodin Gen-2.5アップデートはAI 3Dアセットの制作パイプライン統合に焦点、CTOのQX Zhang氏が制御性が生成速度より重要である理由を語る。
Tripo 3.0はSparseFlex表現を採用し、P1.0はわずか2秒でプロ級3Dモデルを生成、創業者Simon SongがAIをUGCリアルタイムパイプラインにどう組み込むかを語る。
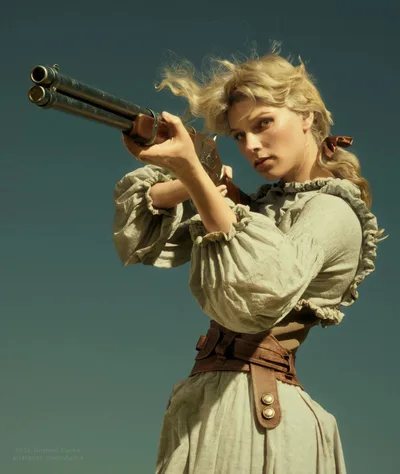
ハンガリーの3DアーティストがUE5 MetaHuman、Style3D Atelier、ZBrushでAI生成画像を再現し、AIに迫るリアルなキャラクター制作に挑戦。
Nandakishor Mukkunnothは2025年3月にJevの非自己回帰意思決定モデルを作り、それについて長い記事を書いたと述べている。私は彼が引用した2本の論文を読み、彼の2026年のモデルを229問の細粒度問題で走らせたが、見えたものはこの話とは少し違っていた。
作者はLLMの「知能」は統計的な錯覚であり、その仕組みは霊媒のコールドリーディング詐欺と同源だと考える。観客の自己選別、場面の前提設定、確認的な陳述による主観的検証の誘発であり、RLHFは口調でしか順位付けできないため、モデルをバーナム的陳述を生成する機械へと最適化してしまったのだ。
著者は、Jev の価値は主にモデル自体ではなく推論戦略にある可能性があると考えている。返信を choice フィールドに事前入力し、制約されたトークンを 1 つだけ生成すれば、どの LLM でも「秘密のレシピ」の大部分が得られる。彼は Qwen2.5-1.5B で 2〜3 倍の高速化を試し出した。
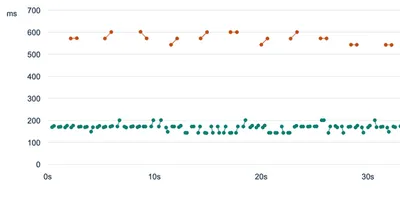
著者はQwen3-8BをSystem One分類器として接続した後、2つの手法を試した。階層的目標(10秒ごとに戦略、5秒ごとに戦術、200ミリ秒ごとに実行)とトーナメントサンプリング(一度に100個のリンクを2ラウンドで選別)で、後者はWikiracingで理想的な3リンク経路を見つけた。
DeepMindがAlphaGenomeの予測をゲノム規模で事前計算:1PBのデータセット、90億の一塩基変異をカバーし、影響を1つの数値に凝縮するAVIスコアを発表。共同研究者はこれを用いて未解明の希少疾患で原因変異を特定し、実験的に検証した。
Po-Shen Loh が、数学者は制御を手放すべきという反論に応じた。人類の繁栄を助けるべきだという基本公理を置き、そこから推論の連鎖を導く。AI が進歩するほど人間が監視すべき制御点が増え、人手が足りなくなり、その職務が逆に AI を減速させる。 Loh
ChatGPTがSponsored Agentsの広告テストを開始、ユーザーは広告をクリックして企業がスポンサーするagentと対話可能、HubSpotとShopifyの統合も追加。
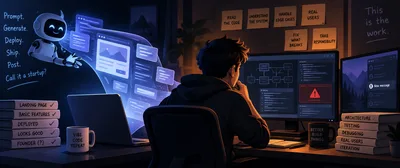
著者は、問題は人々がAIを使うことではなく、「動くものを手に入れた」ことがいつの間にか「なぜ動くのかを理解している」と見なされていることだと言う。彼は読書会アプリを作り直した経験と、2台目のモニターにしか現れない通知バグについて語り、その線引きをレビュー、デバッグ、そして自分が何を作ったのかを本当に知るという段階に置いている。
著者が書いているのは新しい種類の疲労だ。残業のような目に見える疲れではなく、ツールが毎週変わり、期待の水位が静かに上がり続けることによる疲れである。その重さをいくつかの具体的な事柄に分解し、なぜ皆が平気なふりをするのか、何が本当に役立つのかを説明する。
AIへの依存で最も深刻な結果はコードの劣化ではなく認知の退化だと著者は考える。プロンプト、受け入れ、繰り返しの間にレビューの工程が欠け、偽りの信頼が次々と連鎖していく。著者は毎日プログラミング問題を一問解き、録画して解説する対抗法と、自らの手でデバッグして得た確かな手応えについて綴っている。
GPT-6 Astraの公開後、著者は「モデルがどれだけ強いか」から、より見落とされがちな問題へと目を向けた。モデルが強くなっていることを、私たちは一体どうやって知るのか。ベンチマークは飽和し、代理指標が使われ、真値の出所は複雑で、採点方法も変わる。記事はスコアを見るときに問うべき5つの問いを提示する。
AI にブログ記事、リサーチレポート、メモのような実質的な内容のテキストを書かせるのは、十分な要点と文脈を与え、後から自分で編集したとしても、ほぼ決してすべきではないと著者は主張する。書くこと自体が思考であり、AI の文章は気づきにくいところで曖昧に誤り、明示しなければ失礼かつ人を誤導するからだ。