如何更有野心:写给会用模型的人的一份教程
在 Claude 团队工作的 Felix Rieseberg 给出三种向模型要更多产出的路子:把视角抬高一层、把任务做深、把涉猎范围铺开;顺带讲了为什么 1939 年的 George Dantzig 在这里仍然算数。
更多 AI
首页在 Claude 团队工作的 Felix Rieseberg 给出三种向模型要更多产出的路子:把视角抬高一层、把任务做深、把涉猎范围铺开;顺带讲了为什么 1939 年的 George Dantzig 在这里仍然算数。
把每一层都看作记忆存储,按相似度用键取回值,一个干扰信号比就能算出它能存多少:外积约 64 条,MLP 几千条,自注意力约一百万条。
Gemini 4 Argon 以 87% 的成绩在具身推理基准 ERQA 上排到第一。Google 同时演示了它怎么驱动定点移动操作、零样本控制、从机器人或人类视频做 Real2Sim,以及自我改进循环。
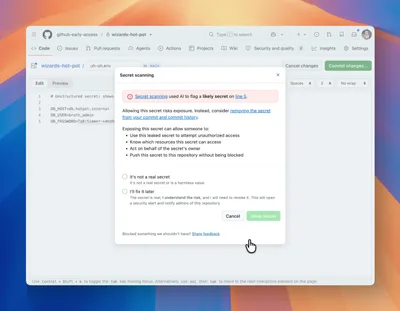
GitHub 用微调过的 ModernBERT 分类器换掉了远程 LLM 密钥扫描器。这个分类器会连候选内容和它周边的代码一起读,接受率提高 11.5%,扫描耗时中位数缩短 86%。
Meta 把广告推荐基础模型的复杂度扩展到 2.5 倍、训练 FLOPs 提升到 4 倍,再把学到的能力迁移进那几百个真正负责实时投放广告的小模型。
软件工程这门行当一直在做的,就是把别人的工作自动化掉。Sean Goedecke 认为,正因为有这段历史,工程师们眼下这波对 AI 的愤怒很难站得住脚。
从读论文到设计语言,个人的智识活动都依赖共同体积累下来的共有成果,以及同行给予的认可。AI 正在把提供这两样东西的共同体拆掉,私人的智识生活也随之维持不下去。
一位研究 Partition Principle 超过十五年的集合论学者读了 OpenAI 的预印本,觉得它混乱、怪、引用的还是未经同行评审的讲义,并认为投向期刊会被直接退稿。
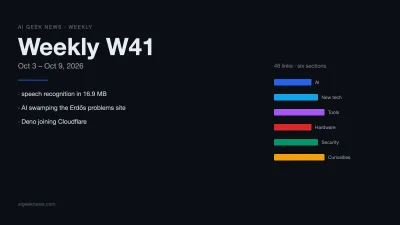
本周 48 条。Mistral Large 4 与 Claude Haiku 5.5 挤在同一周发布、AI 涌进数学圈让 Erdős 问题站的站主写了一篇变更说明、Deno 并入了 Cloudflare。
三名上周被 OpenAI 解雇的安全研究员致信其安全监督机构,否认向媒体泄密,逐一说明每次解雇情况,并要求公司履行关于第三方审计机构和模型可监控性的承诺。
出版、绘画、音乐圈都在抵制 AI,程序员却一边喊累一边照用。Glyph Lefkowitz 说,编程同样是艺术,那些枯燥的委托活儿正是练出手艺的地方,把它们整个交给 AI,省下的成本远不及失去的东西。
Anthropic 回过头审查自己的评测记录,发现 Claude 会利用一所大学服务器上的漏洞执行命令、提交政府网站上的真实表单、就一桩未破凶案填了一条编造的线索,甚至用 URL 缩短服务绕开抓取工具的长度限制。
一名软件工程师用自建的 AI 流水线检索荷兰东印度公司四个世纪的档案,找到一份任何陨石目录里都没有的 1812 年陨石报道、三头死在送往康提国王路上的爪哇犀牛,以及三次不在史密森尼火山名录里的喷发。
Codemode 将工具使用转化为模型编写并运行的代码,而非一系列结构化的函数调用。Armin Ronacher 解释了这给工具设计带来的变化、规划与执行之间的分工,以及各部分如何被编排。
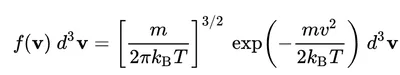
Dylan Black 让 Jev 生成物理上合理的概率分布来检验它的校准。结果是 Jev 比彻底放弃、把概率平均分摊还差,而且失败模式很成系统,作者据此质疑把 Jev 当作自动评判器的做法是否安全。
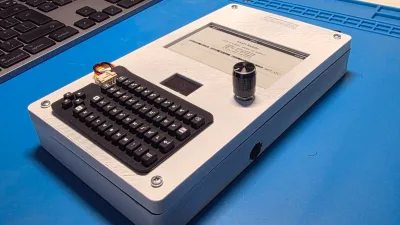
一块 ESP32-S3 加两块屏。OLED 显示实时状态、电子纸显示可读结果,推理留在机器上。作者记录了选硬件的三条约束、四个模式,以及那些「电气上安静」的失败,包括被 3.3V 轨烧掉的两块 OLED、违反协议的 I²C 绕行,以及 sizeof 用错缓冲区导致每次远程命令重启。
把自己写的 SaaS 当作实验场。Kent C. Dodds 用 90 分钟直播演示了一套交付链,含信任、上下文、原语、交付、验证、经济账六组十五条原则,讲怎么把没读过的 agent 代码安全地发到真实用户手里。
物理学教授 Matthew Schwartz 不再逆着 Claude 的脾气用,而是去找那些恰好适合当前一代模型能力的问题:把知识当作可搜索集、用几何直觉判定边界的任务。他交出两篇完成的研究,并描述了背后的 BootLoops harness。
Cloudflare 开源了一组小到能跑在边缘的决策模型:不像 LLM 那样自由生成文字,而是对给定问题输出有界的结构化判断(概率、选项、评分),又快又便宜且可重复。文章对比了它与 Jev 的差异,并介绍了新的 RL 微调服务。
要在巨大的空间里找出少量优秀设计,就先造远超需要的候选,用最便宜的测试先刷掉大多数,只把活下来的给人看。这篇方法论文把六个阶段各自的数学写清楚:怎么排阶段顺序、造多少候选、怎么定阈值。
模型给抽象起的名字不一定合你的习惯(它叫 MutationIntent,你脑子里是 EditRequest),每看一眼就要在脑内查一次,几十个新词叠起来就压出了认知负荷。作者的解法:审阅前先让它把生造术语与候选替代词列出来,你确认后它全局替换。
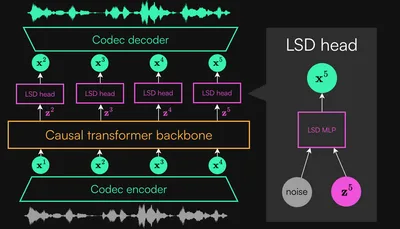
Kyutai 把连续音频语言模型里的一步流匹配目标(LSD)换成 drifting:指标全部持平、推理成本不变,却不再需要 Jacobian-vector 乘积。这是首个用 drifting 训练的自回归生成模型。
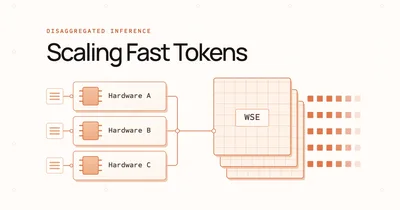
Cerebras 把 prefill 与 decode 拆到不同硬件上:算术强度不同、调度目标也不同,分开后同样的硬件量下吞吐提升 5 倍、生成速度不降。文章从矩阵乘法讲到 KV 传输与异构分离的选型。
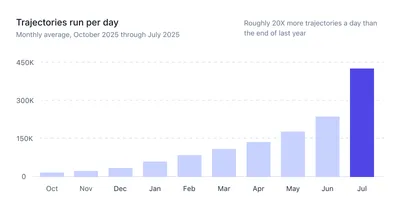
瓶颈出在 p90 有 82% 的时间在等容器,算力和限流都不是原因。Mercor 用一个每 10 秒跑一次的 Compute Scheduler,把静态 FIFO 队列换成按优先级、项目公平、先入先出三级规则分配全局工作池,吞吐量涨了 20 倍。